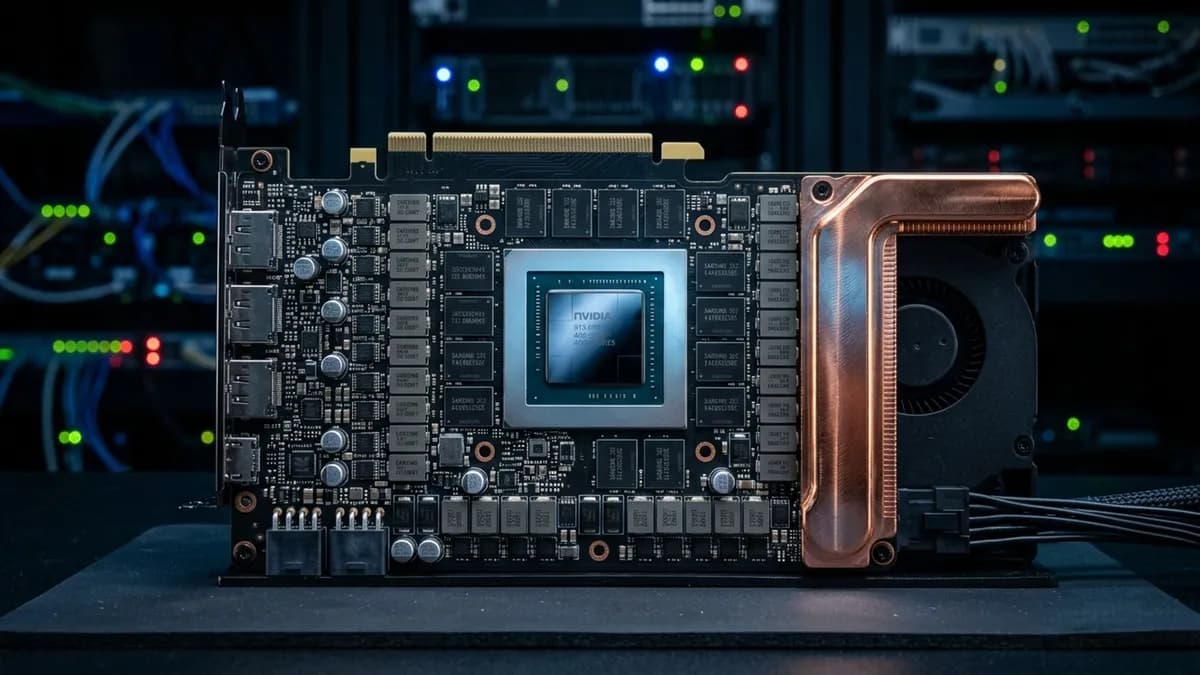
۸۴ گیگابایت حافظه؛ عددی که حالا به تیمهای سازمانی اجازه میدهد مدلهای حجیمتر هوش مصنوعی و پنجرههای متنی طولانیتر را بدون اتکا به خوشههای ابری اجرا کنند. انویدیا در ۱۴ سپتامبر ۲۰۲۴، کارت گرافیک RTX PRO 5500 Blackwell Workstation Edition را در صفحه رسمی محصولات خود فهرست کرد که نشاندهنده چرخش راهبردی به سمت متمرکز کردن قدرت پردازشی در رکهای سرور برای تیمهای حرفهای است.
بسیاری از ایستگاههای کاری فعلی بر پایه کیسهای مجزا در کنار میز هر کاربر هستند. سختافزار جدید انویدیا این قدرت را به رکهای مدیریتشده منتقل میکند تا تیمهای IT بتوانند منابع محاسباتی را بین چندین کاربر به اشتراک بگذارند و مقیاس آن را افزایش دهند. این محصول در واقع پلی است بین یک GPU دسکتاپ سنتی و یک شتابدهنده تمامعیار مرکز داده.
همانطور که در تحلیلهای قبلی ما درباره زیرساختهای سختافزاری مدلهای زبانی اشاره کردیم، گلوگاه اصلی اجرای مدلها در محیطهای محلی، همواره کمبود حافظه ویدیویی بوده است.
طبق اعلام NVIDIA، این کارت با شعار «قدرتبخش عصر بعدی هوش مصنوعی» عرضه میشود. این استراتژی به سازمانها اجازه میدهد سختافزار را متمرکز کنند و نیاز به خرید کیسهای گرانقیمت برای تکتک متخصصان را از بین ببرند. شرکت PNY Technologies نیز این محصول را با کد SKU VCNRTXPRO5500B-PB فهرست کرده و آن را سختافزاری تخصصی برای هوش مصنوعی و شبیهسازی توصیف کرده است که بهطور خاص برای ایستگاههای کاری نصبشده در رک (Rack-mounted) ساخته شده است.
بر اساس مستندات فنی، این کارت بر پایه معماری Blackwell ساخته شده و از نسل پنجم هستههای تنسور (Tensor Cores) و نسل چهارم هستههای RT بهره میبرد. این سختافزار برای استقرار در تراکم بالا طراحی شده و هر دو گزینه خنککننده بادی فعال (Active air-cooled) و خنککننده مایع (در فرمفاکتور RXM) را پشتیبانی میکند.
مشخصات فنی این کارت عبارت است از:
- حافظه: ۸۴ گیگابایت GDDR7 با قابلیت تصحیح خطای ECC.
- پهنای باند: ۱,۳۹۸ گیگابایت بر ثانیه (احتمالاً با استفاده از یک باس حافظه ۴۴۸ بیتی).
- پردازش: ۲۱,۷۶۰ هسته CUDA (که از نظر مقیاس با GeForce RTX 5090 مطابقت دارد).
- توان مصرفی: حداکثر ۶۰۰ وات از طریق گذرگاه PCI Express Gen 5 x16.
- خروجی تصویر: تا چهار خروجی DisplayPort 2.1b که از رزولوشن 16K در ۶۰ هرتز و 8K در ۲۴۰ هرتز پشتیبانی میکند.
- مدیا: سه رمزگذار NVENC نسل نهم و سه رمزگشای NVDEC نسل ششم.
- ابعاد فیزیکی: فرمفاکتور دو اسلته با ارتفاع کامل و طول کامل، با ابعاد ۴.۴ اینچ ارتفاع در ۱۱.۱ اینچ طول.
پشتیبانی از GPU چند-نمونهای (MIG) — شبیه به تقسیم یک خانه بزرگ به دو آپارتمان مجزا برای دو مستأجر مختلف — اجازه میدهد این کارت به دو نمونه کاملاً ایزوله تقسیم شود. کاربران میتوانند یک نمونه با ۸۴ گیگابایت یا دو نمونه با ۴۲ گیگابایت حافظه داشته باشند. طبق FAQ انویدیا، هر نمونه دارای حافظه، کش و هستههای محاسباتی اختصاصی است. این ساختار تضمین میکند که کیفیت سرویس (QoS) برای چندین کاربر که از یک سختافزار واحد استفاده میکنند، به طور کامل تضمین شود.
انویدیا ادعا میکند هستههای تنسور نسل پنجم، ۳ برابر عملکرد نسل قبل را ارائه میدهند. این هستهها از پشتیبانی بومی برای دقت FP4 و قابلیت DLSS 4 Multi Frame Generation بهره میبرند. در بخش رهگیری پرتو (Ray-tracing)، هستههای RT نسل چهارم ۲ برابر سریعتر شدهاند و فناوری RTX Mega Geometry امکان پردازش ۱۰۰ برابر مثلثهای بیشتر در رهگیری پرتو را فراهم میکند.
در حوزه تولید ویدیو، موتورهای NVENC نسل نهم رمزگذاری 4:2:2 H.264 و HEVC را اضافه کرده و کیفیت AV1 را بهبود بخشیدهاند. همچنین توان عملیاتی رمزگشایی H.264 در موتورهای NVDEC نسل ششم تا دو برابر افزایش یافته است.
تمرکز اصلی این سختافزار بر روی هوش مصنوعی زاینده (Generative AI) — مثل هنرمندی که میتواند هر تصویری را بر اساس توصیفات شما خلق کند — و مدلهای عاملمحور (Agentic AI) است. این رویکرد با تلاشهای گستردهتر انویدیا برای حذف گلوگاههای پردازشی در مقیاسهای عظیم همسو است، مشابه آنچه در بهکارگیری پردازندههای Vera برای توانمندسازی هوش مصنوعی عاملمحور در SpaceXAI مشاهده کردیم. این شامل استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز — برای مدلهای زبانی بزرگ (LLM)، عوامل هوش مصنوعی (AI Agents) و بینایی ماشین از طریق نسل دوم موتور ترنسفورمر است. برای هوش مصنوعی فیزیکی، این کارت از جریانهای کاری NVIDIA Omniverse پشتیبانی میکند که شامل شبیهسازی رباتیک، تولید دادههای مصنوعی و مدلهای سهبعدی مبتنی بر Universal Scene Description (OpenUSD) است.
سایر کاربردها شامل محاسبات علمی و تحلیل دادهها با استفاده از عملکرد FP32 و رندرینگ مبتنی بر هوش مصنوعی با RTX Neural Shaders است. انویدیا صنایع بهداشت و درمان، خدمات مالی، علوم زمین (Geoscience)، تولید، مهندسی، آموزش عالی و معماری و مهندسی (AEC) را به عنوان بازارهای هدف شناسایی کرده است.
طبق مشخصات PNY Technologies، الزامات سیستمی شامل پردازندههای Intel Core i5، i7، i9 یا Xeon و همچنین پردازندههای کلاس AMD Ryzen یا Epyc است. توصیه شده که حافظه سیستم (RAM) حداقل دو برابر حافظه GPU باشد (یعنی ۱۶۸ گیگابایت).
پلتفرمهای پشتیبانی شده عبارتند از:
- ویندوز ۱۱ و ویندوز ۱۰ (۶۴ بیتی)
- Red Hat Enterprise Linux 7.x و SUSE Linux Enterprise Desktop 15.x
- Fedora 31 و Ubuntu 18.04
- FreeBSD 11.x و Solaris 11
این کارت با سیستم RTX PRO Sync سازگار است. این قابلیت اجازه میدهد خروجی تصویر و نمایشگرها تا ۳۲ نمایشگر از ۸ کارت گرافیکی در یک سیستم، با استفاده از دو برد RTX PRO Sync همگامسازی شوند. PNY برای این محصول گارانتی محدود سه ساله ارائه میدهد.
این تغییر سختافزاری سیگنالی است که «ایستگاه کاری هوش مصنوعی» در حال خروج از روی میز کاربر و ورود به اتاق سرور است. با متمرکز کردن ۸۴ گیگابایت حافظه GDDR7، شرکتها میتوانند جریانهای کاری عاملمحور را که به VRAM عظیمی نیاز دارند، بدون خرید سرورهای مجزا برای هر مهندس مستقر کنند. این تمرکز بر سختافزارهای ردهبالای سروری، تفاوتهای بنیادین در دسترسی به ابزارهای توسعه ایجاد میکند؛ موضوعی که در بررسی محدودیتهای دسترسی کاربران خانگی به پشتیبانی CUDA در معماری RISC-V نیز به آن پرداخته بودیم.
برای کاربر نهایی، این یعنی امکان اجرای شبیهسازیهای پیچیده سهبعدی یا تنظیم دقیق (Fine-tuning) — شبیه به وقتی که به یک پزشک عمومی، تخصص پوست میدهیم تا در یک حوزه دقیق شود — مدلهای زبانی به صورت ریموت و با تأخیر بسیار کم. این رویکرد فضای فیزیکی توسعه هوش مصنوعی را کاهش و حافظه در دسترس هر کاربر را افزایش میدهد.
با توجه به اینکه محصول در حال حاضر با وضعیت «بهزودی» (Coming Soon) علامتگذاری شده است، باید منتظر تاریخ عرضه رسمی و قیمتگذاری باشیم. سیگنال حیاتی بعدی، اولین بنچمارکهای دنیای واقعی خواهد بود که این تراشه ۸۴ گیگابایتی Blackwell را در وظایف استنتاج کوچکمقیاس با H100 مقایسه میکند.
گام بعدی شما
- اگر مدیر IT هستید، بررسی کنید که آیا انتقال GPUها به رکهای سرور میتواند هزینههای سختافزاری تکراری شما را کاهش دهد یا خیر.
- برای توسعهدهندگان مدلهای محلی، رصد کنید که آیا ۸۴ گیگابایت VRAM نیاز به کوانتایز کردن مدلهای متوسط را از بین میبرد.
- منتظر بنچمارکهای واقعی برای مقایسه این تراشه با H100 در وظایف استنتاج کوچکمقیاس باشید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو