
اگر امروز برای مدیریت حافظه عاملهای هوش مصنوعی خود به پایگاهدادههای برداری ساده تکیه میکنید، احتمالاً با رسیدن به حجم دادههای واقعی، با سقف عملکردی مواجه خواهید شد. در حالی که بسیاری از ابزارهای هوش مصنوعی عاملمحور برای تفاخر به قابلیتهای خود از نمونههای کوچک بازاریابی استفاده میکنند، NylonME ادعا میکند که در محک سختگیرانه و جامع LoCoMo برای گفتگوهای طولانی، نرخ بازیابی (Recall) ۸۴.۶ درصدی را ثبت کرده است. این موتور حافظه اکنون بهصورت یک ابزار متنباز در دسترس است.
انتخاب لایه حافظه برای عاملهای هوش مصنوعی در سال ۲۰۲۶ از یک پرسش «آیا» به «کدام یک» تغییر کرده است. اکثر تیمها در حال حاضر بر پایگاهدادههای برداری پایه یا سرویسهای ابری مدیریتشده تکیه میکنند، اما این سیستمها با پیچیده شدن پرسوجوها، اغلب با سقف عملکردی مواجه میشوند. این موضوع یک گلوگاه حیاتی برای عاملهایی در بخشهای مالی، بهداشت و درمان و حقوقی ایجاد میکند؛ جایی که حاکمیت دادهها (Data Sovereignty) غیرقابل مذاکره است.
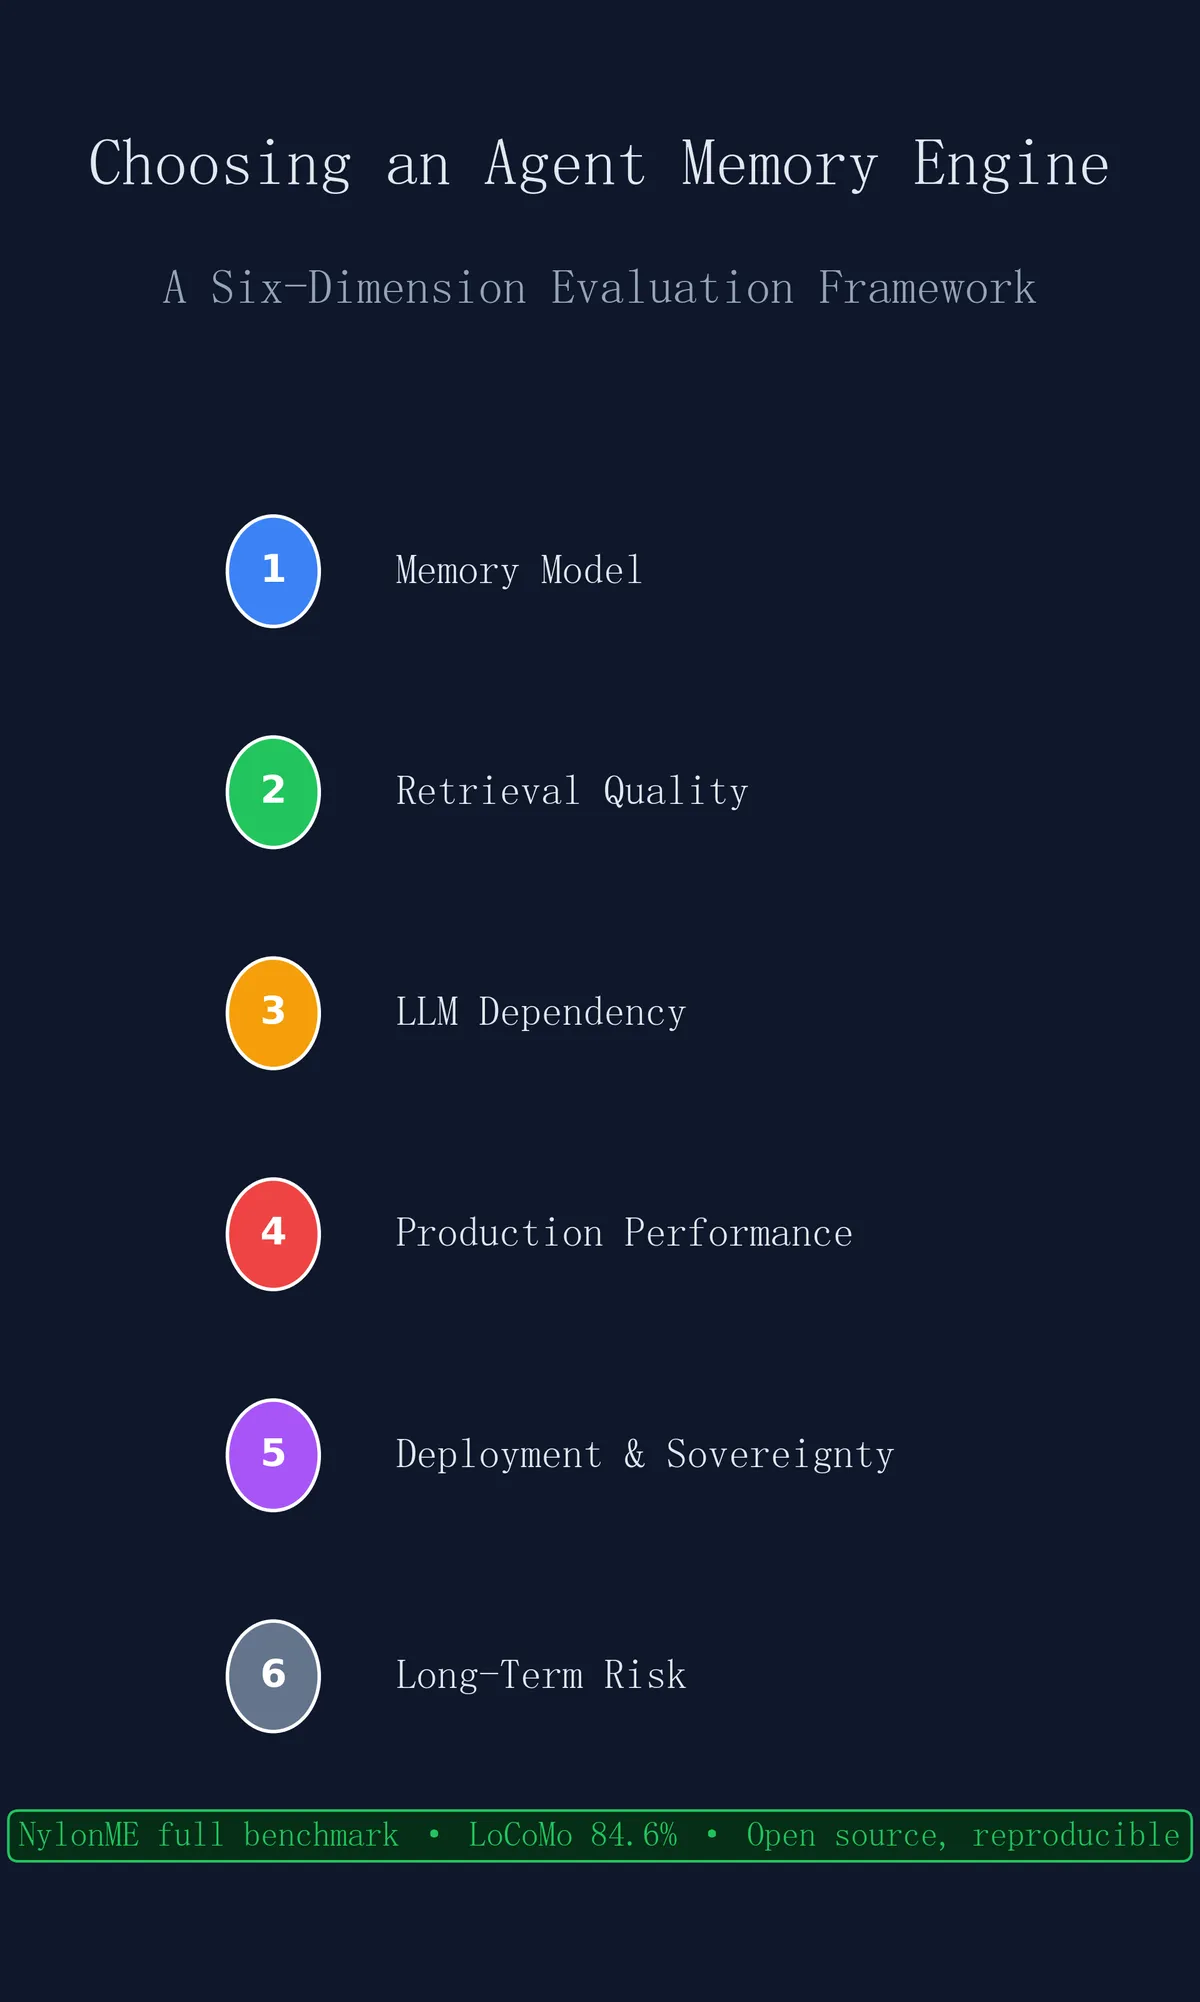
به نقل از گزارش فنی منتشر شده در ۸ سپتامبر ۲۰۲۶، ارزیابی یک موتور حافظه نیازمند بررسی شش بُعد کلیدی است. بسیاری از تیمها این اشتباه را میکنند که تنها سه پست وبلاگی را بخوانند و یک دموی ساده را اجرا کنند، تا اینکه شش ماه بعد و با رشد حجم حافظه، با سقف تواناییهای سیستم انتخابی خود مواجه شوند. این شش بُعد حیاتی عبارتاند از:
- مدل حافظه: نحوه سازماندهی اطلاعات (لیست تخت، فشردهسازی لایهای یا شبکه گرافی) که کیفیت بازیابی را محدود یا تقویت میکند.
- کیفیت بازیابی: اینکه آیا اعداد قابل تکرار و نتایج کامل در محکهای عمومی وجود دارد یا خیر. این چالشها در مقایسه عاملهای هوش مصنوعی با موتورهای جستوجوی سنتی در پردازش الگوها نیز به وضوح دیده میشود.
- وابستگی به مدل زبانی (LLM): اینکه آیا سیستم در صورت قطع شدن LLM، اتمام زمان (Timeout) یا افزایش قیمتها، همچنان کار میکند یا خیر.
- عملکرد عملیاتی: توان عملیاتی نوشتن (Write Throughput)، تأخیر پرسوجو و ردپای منابع تحت بار واقعی.
- استقرار و حاکمیت دادهها: قابلیت میزبانی شخصی (Self-hosting) و اطمینان از اینکه دادهها هرگز مرکز داده را ترک نمیکنند.
- ریسک بلندمدت: مجوزها، وابستگی به فروشنده (Vendor Lock-in) و پایداری پروژه در طول زمان.
همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، کنترل کامل بر لایه داده، پیششرط اصلی برای استقرار در صنایع حساس است.
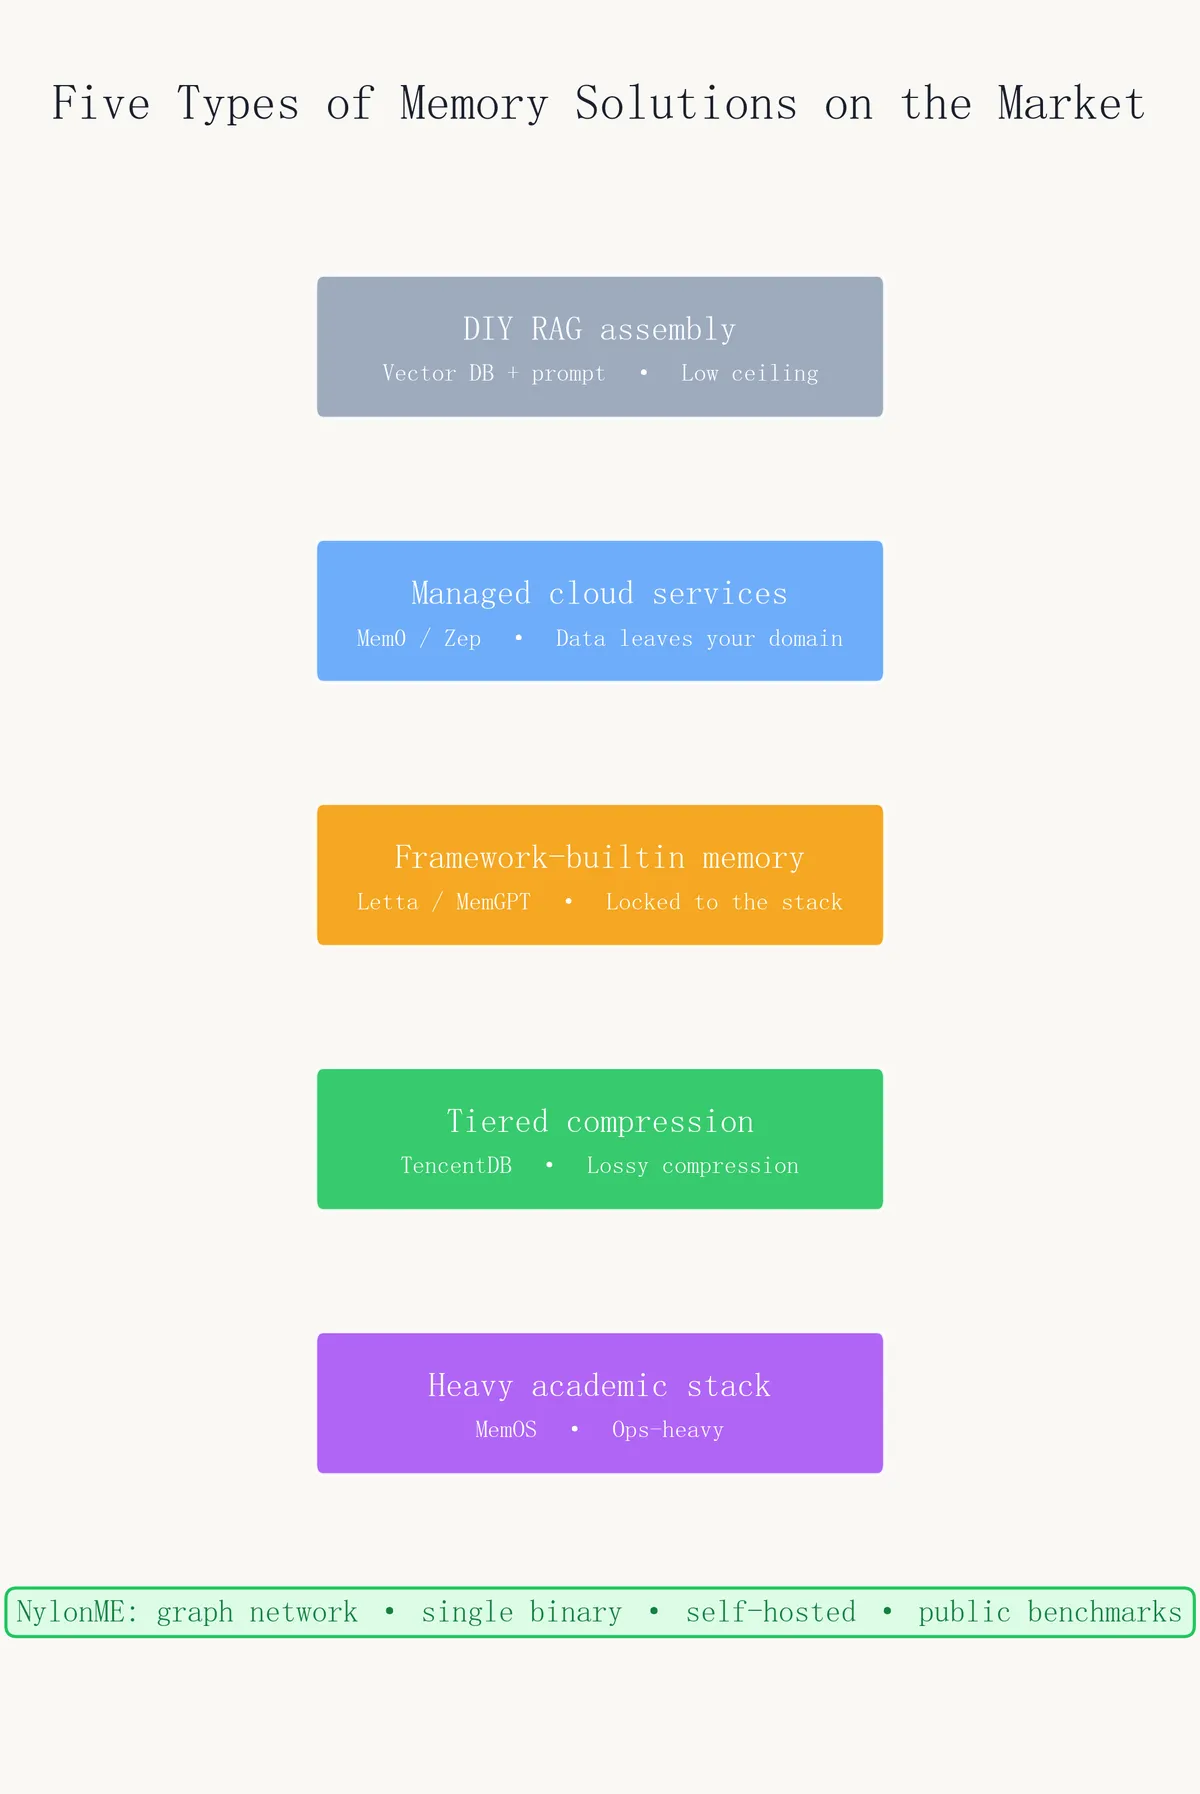
بر اساس بررسی مستندات، تا اوت ۲۰۲۶، راهکارهای حافظه عاملها به طور کلی به پنج مکتب فکری تقسیم شدهاند:
۱. ترکیب دستی RAG: استفاده از یک پایگاهداده برداری در ترکیب با قالبهای پرامپت. اگرچه این روش را میتوان در دو هفته پیاده کرد، اما فاقد مفاهیمی چون زمان، تشخیص تضاد و مکانیسمهای فراموشی است. برای مثال، اگر کاربر یک هفته پیش بگوید «غذاهای تند دوست ندارم» و هفته بعد بگوید «عاشق تند هستم»، این دو خاطره برای همیشه با هم میجنگند. این روش برای اعتبارسنجی اولیه مناسب است، اما نه برای محیط عملیاتی (Production). در این راستا، بررسی شده است که آیا ادغام جستوجوی لغتنامهای و برداری میتواند نقصهای حافظه مدلها را بپوشاند یا خیر.
۲. سرویسهای ابری مدیریتشده (مانند Mem0 و Zep): این سرویسها سریعترین ادغام و SDKهای کاربرپسندی را ارائه میدهند. با این حال، دادهها به سرورهای خارجی جریان مییابند که برای سناریوهای دولتی، مالی یا پزشکی یک «وتوی» فوری است. همچنین قیمتگذاری بر اساس میزان مصرف در الگوهای خواندن/نوشتن با فرکانس بالا میتواند بسیار گران شود.
۳. حافظههای داخلی فریمورکها (خانواده Letta/MemGPT): در اینجا حافظه بهشدت به فریمورک گره خورده است. ریسک این مدل در این است که اگر بخواهید فریمورک ارکستراسیون LLM خود را تغییر دهید، لایه حافظه نیز بههمراه آن «به گروگان گرفته شده» و منتقل میشود.
۴. مدرسه فشردهسازی لایهای (TencentDB-Agent-Memory): این رویکرد از فشردهسازی پیشرونده L0 تا L3 استفاده میکند. در حالی که صرفهجویی در توکنها واقعی و نصب آن راحت است، اما فشردهسازی از نوع «با تلفات» (Lossy) است. تستهای حذف (Ablation tests) نشان میدهد که نگه داشتن تنها لایه انتزاعی، باعث کاهش ۳.۴ واحدی در نرخ بازیابی میشود.
۵. پشتههای آکادمیک سنگین (MemOS): ترکیبی از Neo4j و Qdrant. اگرچه از نظر تئوری کامل است، اما نیازمند نگهداری همزمان یک خوشه پایگاهداده گرافی و یک خوشه پایگاهداده برداری است که برای تیمهای کوچک بیش از حد پیچیده است.
NylonME با استفاده از رویکرد شبکه گرافی خود را متمایز میکند. برخلاف لیستهای تخت یا فشردهسازیهای تلفاتی، این سیستم از مدل «شش تارهای ابریشمی» استفاده میکند که در آن هر خاطره دارای شش ویژگی است: حقیقت (Fact)، رابطه (Relation)، زمان (Temporal)، احساس (Emotion)، تکرار (Frequency) و منبع (Provenance). خاطرات بهطور صریح از طریق تارهای رابطه به هم متصل میشوند.
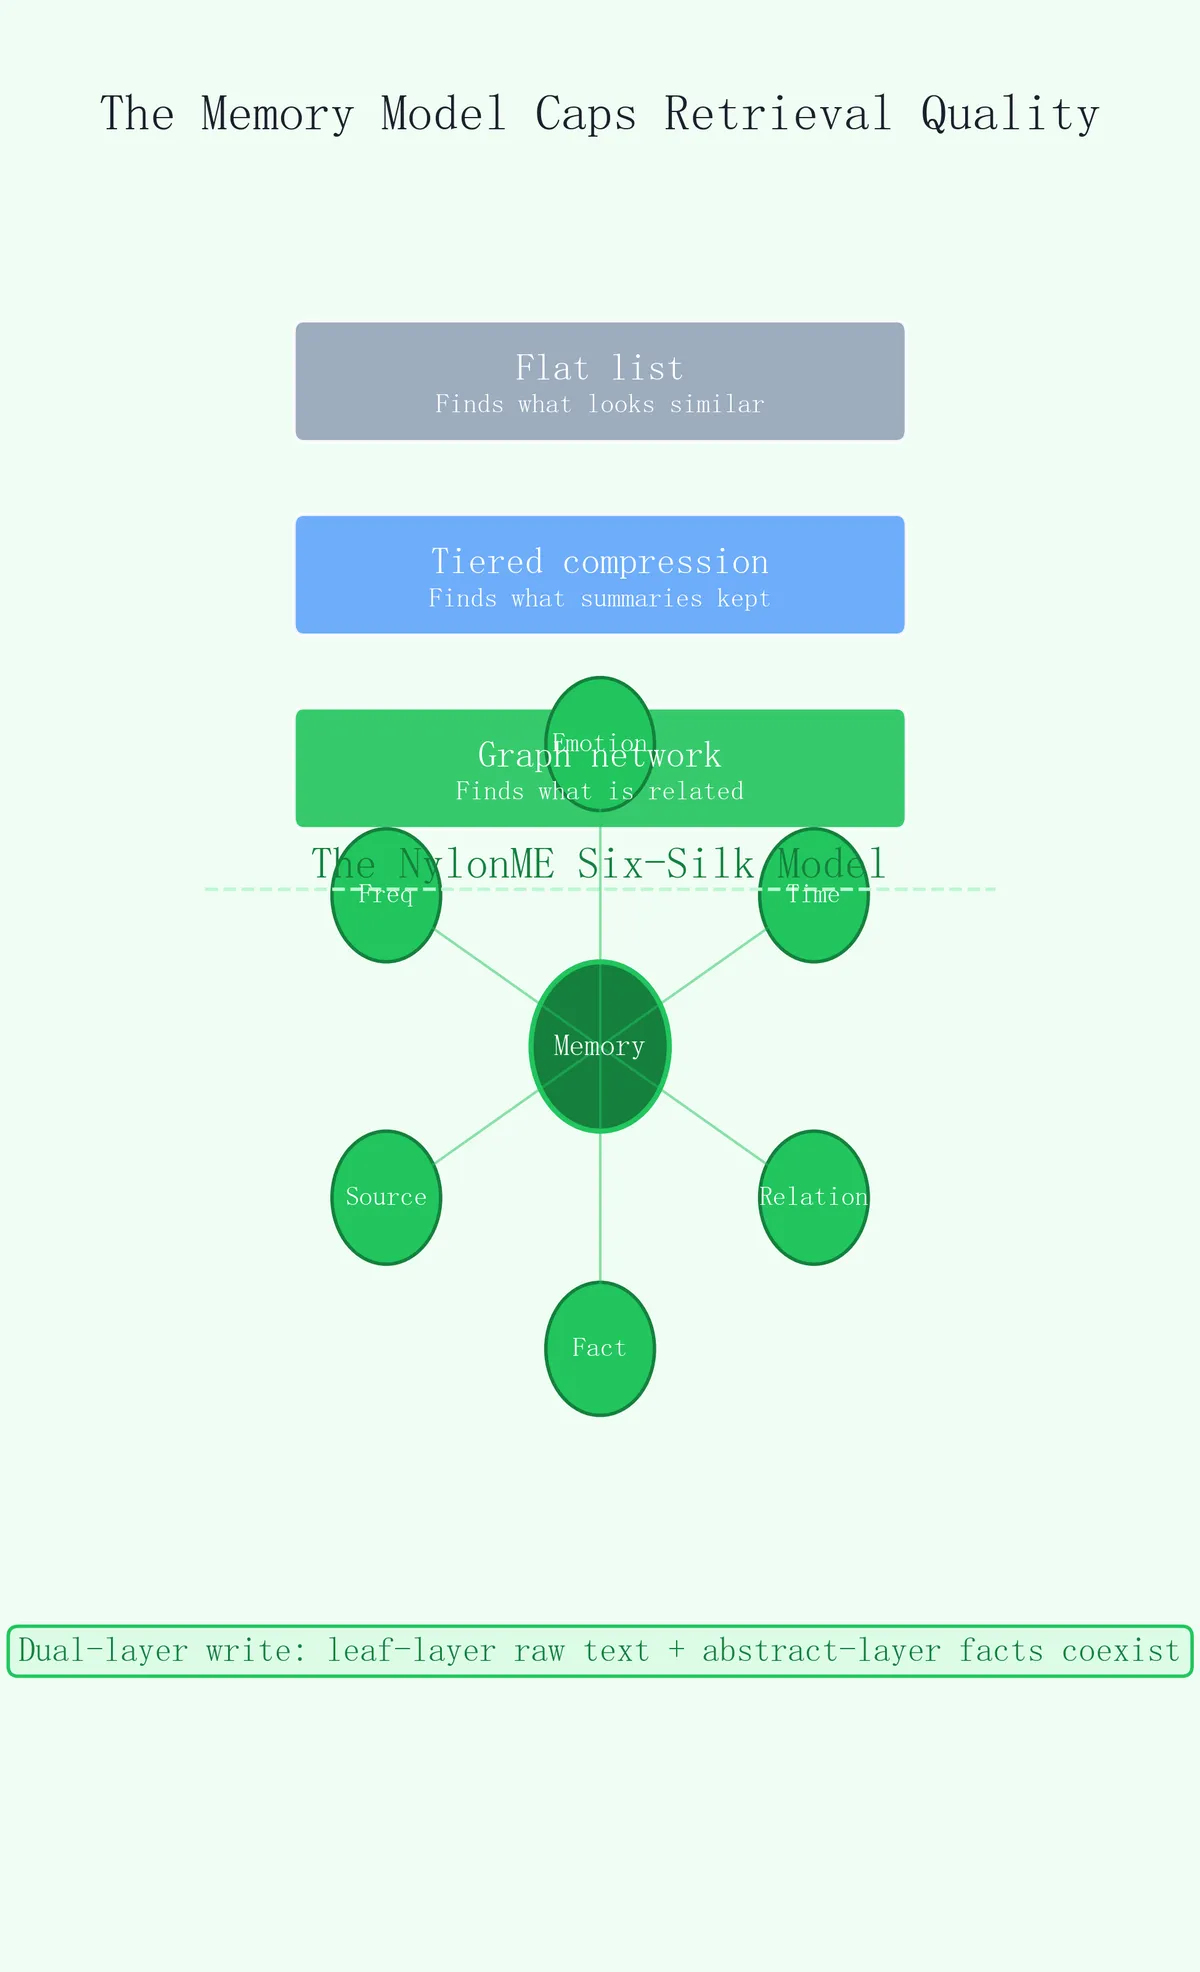
بازیابی در این سیستم از طریق «رزونانس متنی» (Contextual Resonance) انجام میشود که از گرههای بذر در گراف پخش شده و بر اساس شدت تنش (Tension) رتبهبندی میشود. این ساختار سه قابلیت خاص ایجاد میکند:
- بازیابی تداعیگر: سیستم میتواند یک دستور کار مربوط به قطعی اینترنت سه ماه پیش را فعال کند، حتی اگر کاربر کلمه کلیدی دقیقی به کار نبرد و فقط بگوید «اینترنتم کند است»، زیرا این دو در گراف توسط یک یال به هم متصلاند.
- تشخیص تضاد: هنگام ثبت خاطره جدید، سیستم بهطور خودکار تضادهای احتمالی با خاطرات موجود را بررسی میکند. این تضادها بهجای اینکه بهطور خاموش دادههای قدیمی را بازنویسی کنند، همراه با پاسخ به کاربر بازگردانده میشوند.
- فراموشی طبیعی: تنش خاطرات با گذشت زمان بهصورت نمایی کاهش مییابد. خاطراتی که مکرراً ذکر شدهاند در برابر این زوال مقاومت میکنند و بدین ترتیب نیازی به پاکسازی دستی پایگاهداده نیست.
برای افزایش دقت، این تیم در اوت ۲۰۲۶ قابلیت «نوشتن دو لایه» را پیاده کرد. سیستم هم متن خام گفتگوها را در یک لایه برگ (Leaf layer) و هم حقایق سطح-جلسه استخراجشده توسط LLM را در یک لایه انتزاعی (Abstract layer) ذخیره میکند. هر دو لایه همزیستی دارند و در بازیابی مشارکت میکنند. این طراحی بر اساس درسهای تجربی بود که نشان داد مصنوعات فشردهشده، یک مقدار افزایشی هستند و جایگزینی برای متن خام نیستند.
در محک LoCoMo، NylonME نرخ بازیابی recall@10 معادل ۸۴.۶٪ را در ۱۰ جلسه کامل و ۱۵۳۶ پرسش ثبت کرد. نویسندگان بهطور صریح این عدد را با خط پایه لغوی (Lexical baseline) که ۴۷.۱٪ بود مقایسه میکنند. آنها برای تضمین تکرارپذیری، اسکریپتهای ارزیابی متنباز و مدل جاسازی (Embedding) bge-m3 (با ۱۰۲۴ بُعد و قابلیت اجرا روی Ollama محلی) را ارائه کردهاند.
تیم توسعه هشدار میدهد که نباید فریب تبلیغات «دقت ۹۰٪ در ۲ جلسه» را خورد، زیرا نمونههای کوچک اجازه میدهند واریانس باعث گمراهی شود. در تستهای خودشان، عدد مربوط به ۲ جلسه ۸۰.۱٪ بود، اما در اجرای کامل به ۸۴.۲٪ رسید (با نوسان ۱.۵ واحدی در شاخص HNSW). مسیر رسیدن به ۸۴.۶٪ شامل ثبت چهار طراحی شکستخورده بود: گسترش پرسوجوی LLM، یالهای صریح بین-لایهای، کفِ تنش (Tension floor) و سهمیههای رزرو بذر. لیست شکستها به اندازه لیست موفقیتها طولانی است که نشاندهنده یک فرآیند پژوهشی واقعی است.
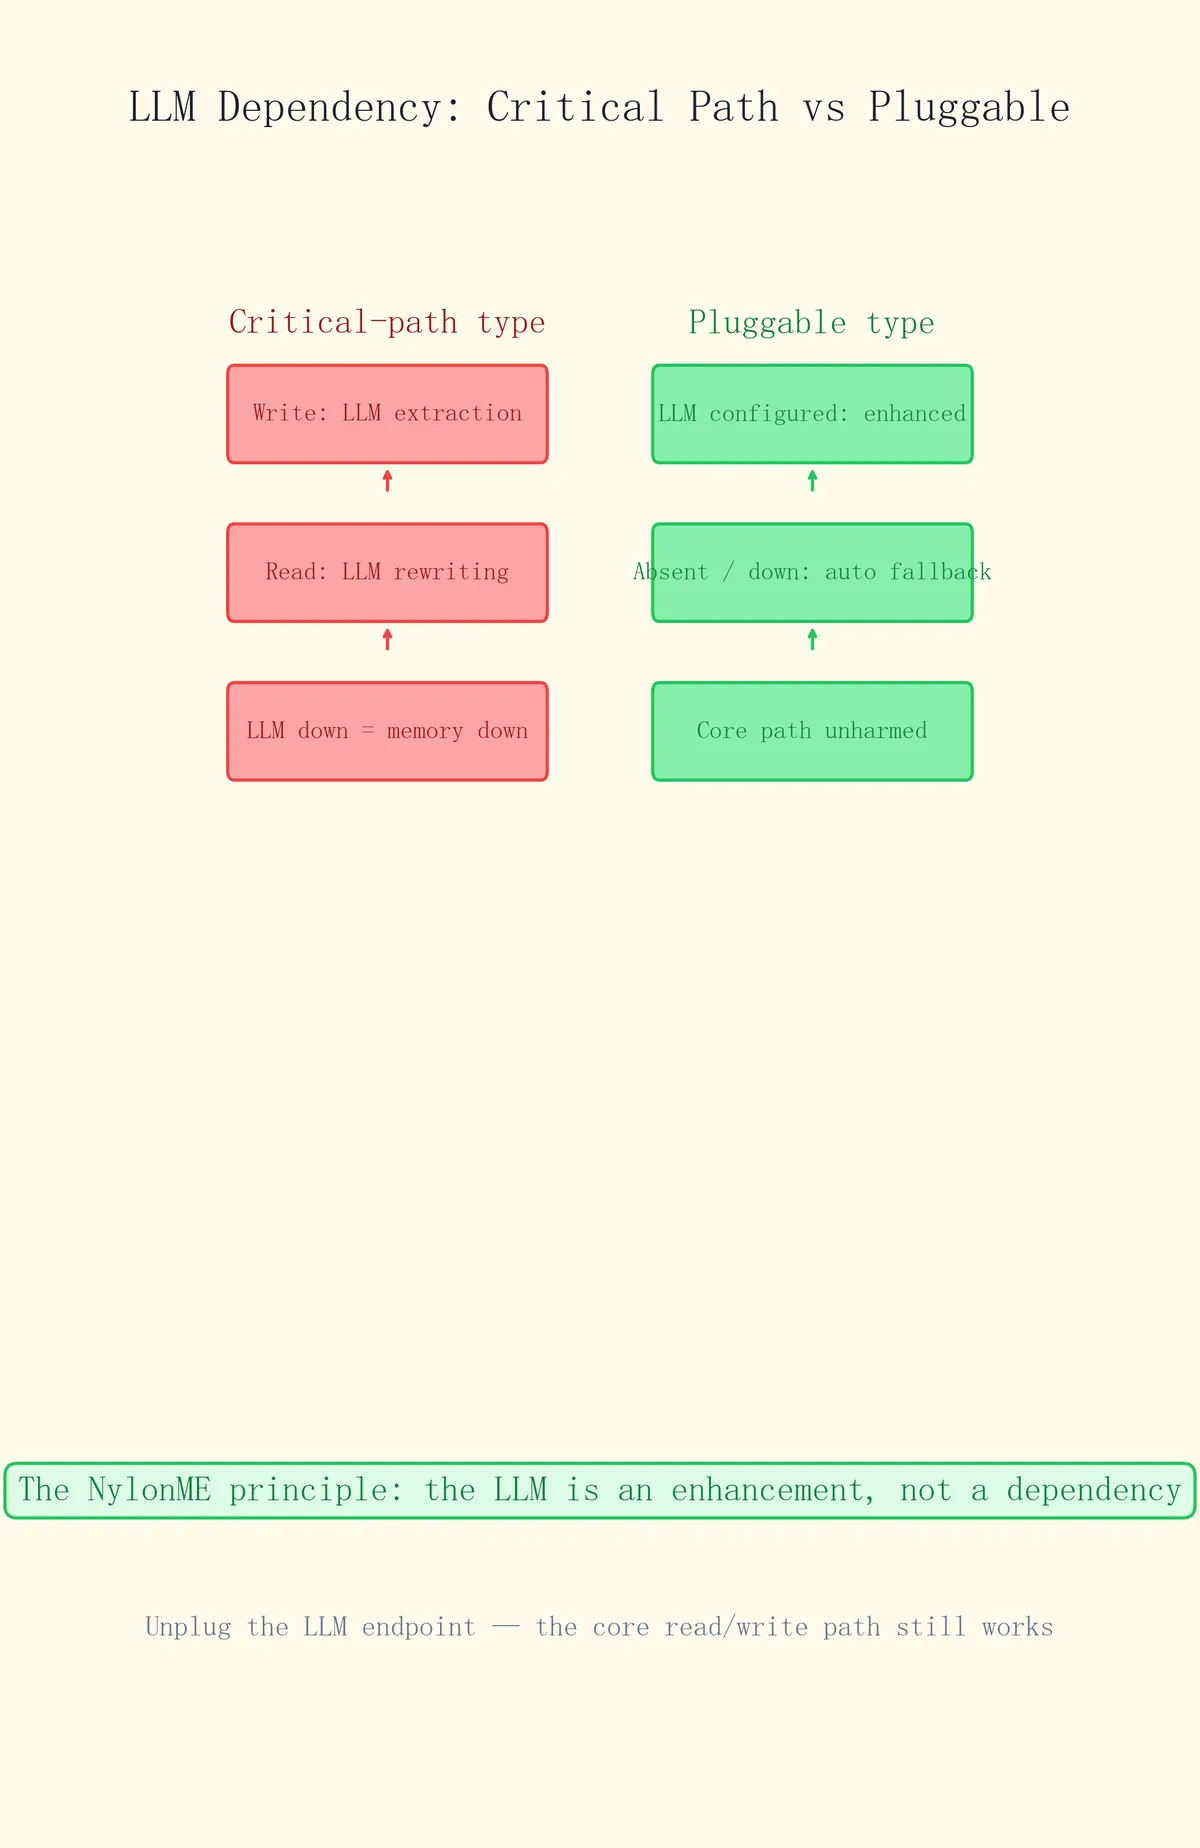
یکی از مهمترین تصمیمات معماری، رویکرد «LLM قابل تعویض و خطاپذیر» است. در حالی که بسیاری از سیستمها با قطع شدن ارائهدهنده LLM کرش میکنند، NylonME از LLM فقط برای بهبودهایی مثل تجزیه بافت (Weaving decomposition)، تشخیص تضاد و انتزاع سطح-جلسه استفاده میکند. اگر نقطه پایانی (Endpoint) شکست بخورد، سیستم بهطور خودکار به تجزیه اکتشافی (Heuristic) و تشخیص قاعدهمند بازمیگردد تا مسیر اصلی خواندن/نوشتن زنده بماند. این تضمین میکند که موتور حافظه صرفاً به دلیل خرابی ارائهدهنده LLM از کار نیفتد. این رویکرد با روند بهینهسازی مدلها همسو است، جایی که مدلهای زبانی کوچک به دلیل کاهش هزینههای استنتاج در محیطهای عملیاتی در حال تبدیل شدن به برنده واقعی هستند.
این موتور که بر پایه هسته Rust ساخته شده، بهصورت یک فایل باینری واحد و بدون وابستگی خارجی ارائه میشود. این یعنی حذف نوسانات مربوط به Garbage Collection و مصرف پیشبینیپذیر حافظه. هزینه استفاده از هسته Rust برای نویسندگان، سرعت توسعه کمتر بود، اما مزیت آن سیستمی است که پیچیدگی عملیاتی نصب خوشههای جداگانه Neo4j و Qdrant را ندارد.
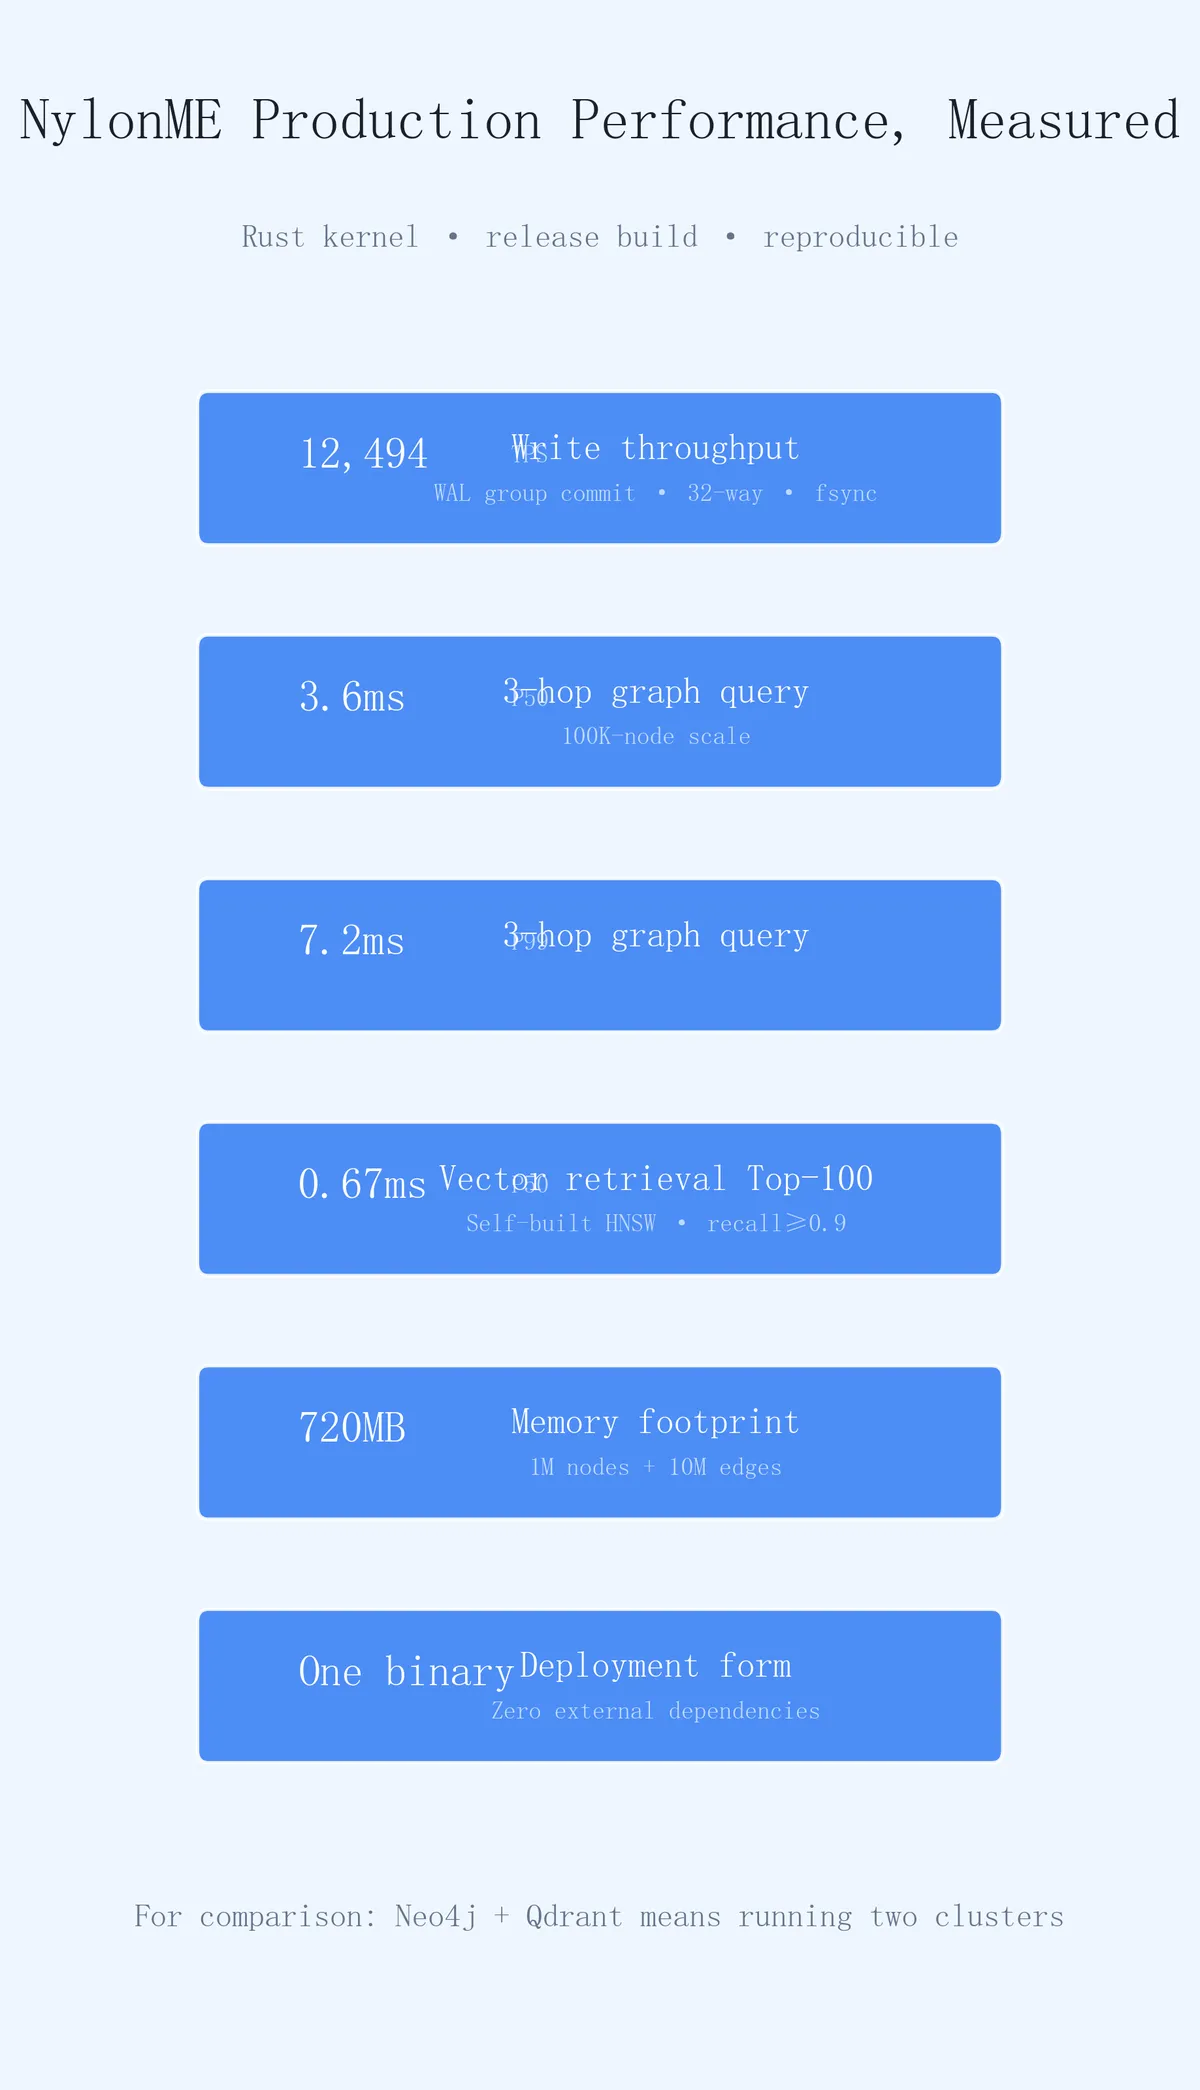
دادههای عملکردی اندازهگیری شده (نسخه Release روی ماشین توسعه) عبارتاند از:
- توان عملیاتی نوشتن: ۱۲,۴۹۴ تراکنش در ثانیه (TPS) با استفاده از WAL group commit، همزمانی ۳۲-راهه و fsync.
- تأخیر پرسوجو: P50 معادل ۳.۶ میلیثانیه و P99 معادل ۷.۲ میلیثانیه برای پرسوجوهای گرافی ۳-پرشی در مقیاس ۱۰۰ هزار گره.
- بازیابی برداری: P50 معادل ۰.۶۷ میلیثانیه برای ۱۰۰ نتیجه برتر با استفاده از HNSW داخلی (recall@10 ≥ 0.9).
- اشغال حافظه: ۷۲۰ مگابایت برای متن واقعی (حداقل ۴۳۲ مگابایت) برای ۱ میلیون گره و ۱۰ میلیون یال.
- شکل استقرار: باینری واحد؛ قابل جاسازی (Embeddable) یا بهعنوان یک سرویس.
برای تیمهایی که حاکمیت دادهها برایشان حیاتی است، این سیستم بهطور کامل از طریق درگاههای gRPC یا REST میزبانی میشود یا بهعنوان یک کتابخانه جاسازی میگردد. این سیستم از هر نقطه پایانی سازگار با OpenAI، از جمله نسخههای محلی Ollama روی اوبونتو پشتیبانی میکند، به این معنی که دادهها هرگز مرکز داده کاربر را ترک نمیکنند و هزینههای API میتواند صفر باشد. پروتکل gRPC عمومی است و اجازه میدهد کلاینتها در هر زبانی تولید شوند.
پروژه تحت مجوز Apache-2.0 منتشر شده است. برای جلوگیری از وابستگی به فروشنده، فرمت دادهها (اسنپشاتهای .nylon)، پروتکلهای gRPC و اسکریپتهای ارزیابی متنباز هستند. این تضمین میکند که اگر کاربر NylonME را رها کند، دادههای حافظهاش بهطور سالم صادر شوند. پروژه همچنین از یک CLA Assistant استفاده میکند تا زنجیره مالکیت معنوی (IP) مشارکتهای جامعه پاکیزه باشد.
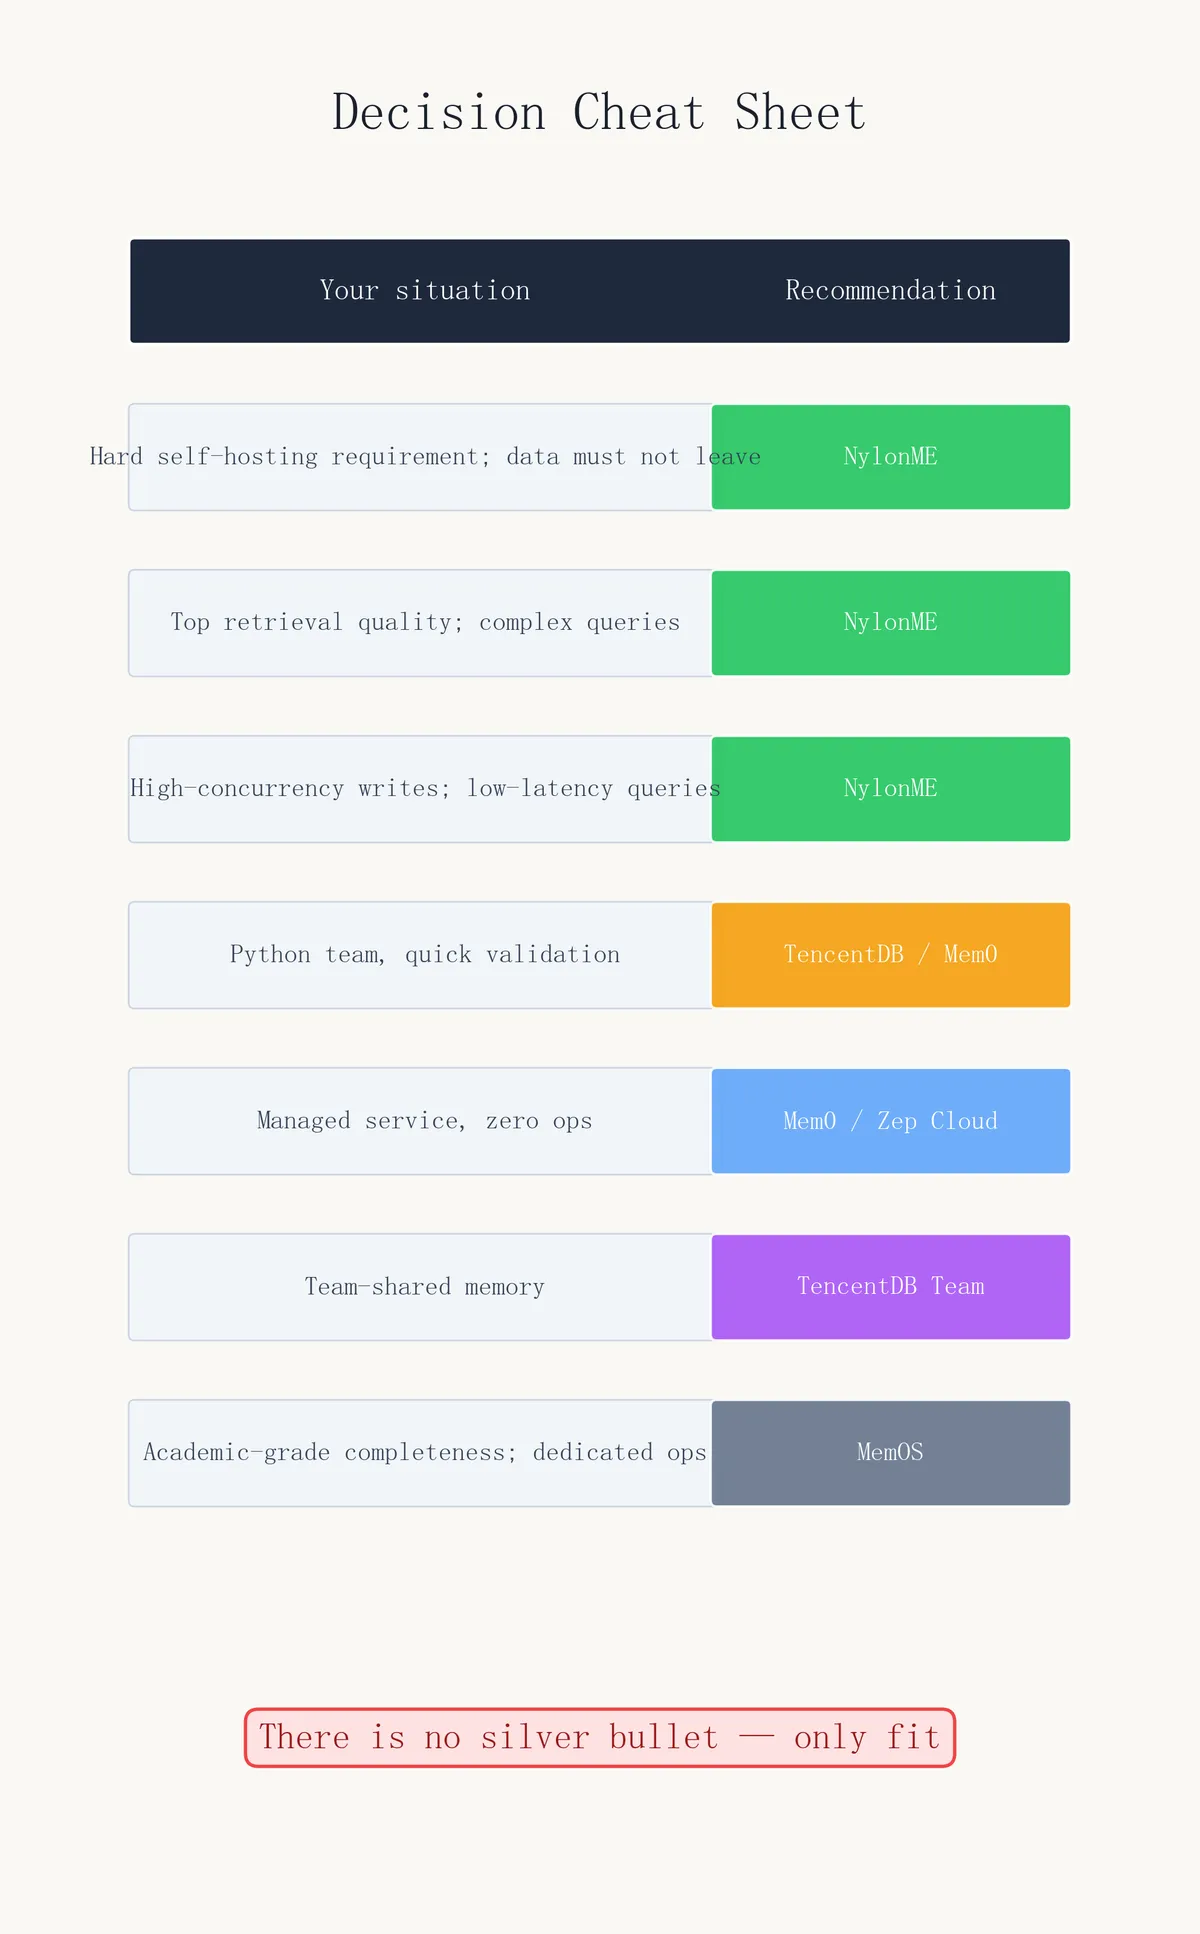
با این حال، نویسندگان اشاره میکنند که NylonME برای هر تیمی انتخاب مناسبی نیست. در شرایط زیر، آنها پیشنهاد میکنند به سراغ گزینههای دیگر بروید:
- تیمهای فولاستک پایتون که باید در دو هفته محصول را عرضه کنند: TencentDB-Agent-Memory یا Mem0 را انتخاب کنید، زیرا SDK پایتون برای NylonME هنوز در حال توسعه است.
- جویندگان سرویس مدیریتشده: کسانی که نمیخواهند هیچ پردازشی را مدیریت کنند باید مدارس سرویسهای ابری را انتخاب کنند؛ نسخه ابری NylonME هنوز در نقشه راه است.
- حافظه مشترک تیمی: کسانی که به اشتراکگذاری چندکاربره و جداسازی دسترسیها نیاز دارند باید از Tencent's Team Memory استفاده کنند که در حال حاضر آماده تولید است.
- صرفهجویی خالص در توکن: اگر هدف صرفاً کاهش توکنهاست (مثلاً استفاده از ۶۱٪ فشردهسازی توکن) بدون اهمیت به سقف کیفیت بازیابی، مدرسه فشردهسازی لایهای مناسبتر است.
- تیمهای ریسکگریز: کسانی که نمیتوانند روی یک پروژه جدید شرطبندی کنند، باید ابتدا از اسکریپتهای ارزیابی ارائه شده برای تأیید اعداد قبل از تعهد نهایی استفاده کنند.
این چرخش به سمت حافظههای گرافی و میزبانی شخصی نشان میدهد که صنعت در حال فاصله گرفتن از «جعبههای سیاه» ابری به سمت هستههای شفاف و با کارایی بالاست. با جداسازی موتور حافظه از ارائهدهنده LLM، توسعهدهندگان میتوانند عاملهایی بسازند که در برابر قطعیهای API و جهشهای قیمتی مقاوم باشند.
برای کسانی که میخواهند این ادعاها را تأیید کنند، نویسندگان یک POC نیمروزه را پیشنهاد میکنند:
۱. اجرا (۱۰ دقیقه): مخزن را کلون کنید، cargo build را بزنید و باینری واحد را استارت کنید.
۲. بازتولید اعداد (۱ ساعت): اسکریپتهای ارزیابی متنباز LoCoMo را اجرا کنید تا نرخ بازیابی ۸۴.۶٪ را مشاهده کنید.
۳. تزریق داده (۲ ساعت): لاگهای واقعی گفتگوها را از طریق gRPC یا REST متصل کنید تا بازیابی رزونانسی را روی توزیع دادههای خودتان تست کنید.
۴. تست قطع اتصال (۵ دقیقه): هر دو نقطه پایانی LLM و Embedding را قطع کنید تا تأیید شود مسیر اصلی همچنان فعال است.
پروژه NylonME در آدرس github.com/nylon-memory/NylonME تحت مجوز Apache-2.0 متنباز شده است. این مقاله بخش ششم از سری وبلاگهای فنی است که پس از بررسیهای عمیق در مورد محکها، هسته عامل و مقایسه با TencentDB-Agent-Memory منتشر میشود.



گفتگو