تصور کنید یک مهندس ارشد امنیت در تمام لحظات کنار شما نشسته و هر خط کد را در زمان واقعی (Real-time) پیش از اجرا بررسی میکند. این دیگر یک رویا نیست؛ بلکه استراتژی جدید OpenAI برای تغییر بنیادین موازنه قدرت از مهاجمان به مدافعان است. عدد ۸۵.۶٪ دقت برای یک عامل هوش مصنوعی واحد در بازتولید آسیبپذیریهای شناختهشده نرمافزاری، معیار جدیدی است که برتری را به طور کلی به سمت مدافعان سوق میدهد.
به نقل از وبسایت openai.com، در ۲۳ ژوئن ۲۰۲۶، این شرکت ابتکار دیبریت (Daybreak) را گسترش داد تا فرآیند وصلهگذاری نرمافزارهای آسیبپذیر را با سرعت ماشینی دموکراتیزه کند. این تلاشها از همین حالا نتایج ملموسی به همراه داشته است؛ این شرکت مدلهای خود را برای کشف و تولید وصلههای امنیتی برای آسیبپذیریهای بحرانی در مرورگرهای بزرگ، زیرساختهای شبکه و سیستمعاملها به کار گرفته است و بهطور مشخص به هسته لینوکس (Linux kernel) و FreeBSD اشاره کرده است.
سالها بود که گلوگاه اصلی در امنیت سایبری، یافتن آسیبپذیریها بود؛ تکلیفی که نیازمند تخصص نادر، زمان بسیار زیاد و آشنایی عمیق با سیستم بود. اما امروز، این مشکل معکوس شده است. طبق گزارشی از openai.com، مدلهای پیشرو هوش مصنوعی اکنون میتوانند در مخازن عظیم کد پیمایش کنند، درباره مسیرهای حمله استدلال کنند و فرضیات را بهراحتی اعتبارسنجی نمایند. آنها میتوانند مسائل امنیتی را بیرون بکشند که در غیر این صورت پنهان میماندند. این وضعیت باعث شده تا مدافعان انسانی در برابر حجم عظیم نقصهای کشفشده، مستأصل و غافلگیر شوند. اکنون، گلوگاه بحرانی دیگر «کشف» نیست، بلکه «وصلهگذاری» یا همان Patching است.
گزارشهای آسیبپذیری به تنهایی کسی را محافظت نمیکنند. ارزش واقعی در مراحل طاقتفرسای بعد از کشف نهفته است: اعتبارسنجی مسئله، درک اثرات آن بر سیستم، توسعه و تست یک وصله، هماهنگی برای افشای مسئولانه (Coordinated Disclosure) و کمک به تیمها برای استقرار اصلاحیه. OpenAI در کنار شرکای خود سرمایهگذاری میکند تا این مراحل انتهایی را شتاب ببخشد. هدف این است که توانایی مدل به کاهش واقعی ریسک در دنیای واقعی تبدیل شود.
کدکس سکیوریتی (Codex Security)، ابزار مرکزی گردشکار در اکوسیستم دیبریت است. در حالی که یافتن یک باگ تنها گام اول است، ارزش واقعی در اعتبارسنجی مسئله و استقرار یک اصلاحیه تستشده قرار دارد، پیش از آنکه یک بازیگر مخرب بتواند وارد عمل شود.
ابعاد چالش
توانمندیهای دفاعی پیشرو نباید تنها در دستان گروه کوچکی متمرکز باشد. نرمافزار تمام جنبههای زندگی را لمس میکند؛ از زیرساختهای حیاتی گرفته تا اپلیکیشنهای تجاری و شبکههای دولتی. از آنجایی که هوش مصنوعی سرعت کشف آسیبپذیریها را تغییر میدهد، مدافعان در همه جا به دسترسی دموکراتیزه به این مدلها نیاز دارند تا بتوانند پیش از آنکه مهاجمان این نقصها را شناسایی کرده و مورد سوءاستفاده قرار دهند، زیرساختهای خود را یافته، اصلاح و محافظت کنند.
دیبریت توانمندیهای سایبری پیشرو مدلهای OpenAI را با «دسترسی مورد اعتماد برای سایبر» (Trusted Access for Cyber)، گردشکارهای Codex Security و شرکای اکوسیستمی ترکیب میکند. این رویکرد یکپارچه به مدافعان تاییدشده کمک میکند تا آسیبپذیریها را اعتبارسنجی کنند، ریسکها را اولویتبندی نمایند، وصلهها را تولید و تست کنند و شواهد لازم را در جریانهای کاری موجود در توسعه و امنیت تولید کنند. هدف نهایی، فراهم کردن ابزارهایی برای سازمانها است تا حتی با شتاب گرفتن چشمانداز تهدیدات سایبری، امن بمانند.
موتور محرک: GPT-5.5-Cyber
قلب این تحول، مدل GPT-5.5-Cyber است؛ مدلی تخصصی که برای کارهای پیشرفته و مجاز امنیت سایبری طراحی شده است. OpenAI پس از یک پیشنمایش اولیه که تنها مجاز به کارهای غیرتخریبی بود، اکنون نسخه کامل را از طریق یک عرضه محدود به مدافعان مورد اعتماد ارائه میدهد. برخلاف مدلهای عمومی، این نسخه «پذیرنده» تر است (Permissive) و قادر است تحلیلهای عمیق را در مخازن کد در مقیاس بزرگ حفظ کند.
این مدل بهطور خاص تنظیم شده است تا به مدافعان کمک کند تا کل «چرخه اصلاح» (Remediation Loop) را طی کنند. مدل میتواند اجزای مرتبط با امنیت را شناسایی کند، ردیابی کند که آیا کد آسیبپذیر در واقعیت قابل دسترس (Reachable) است یا خیر، مسائل احتمالی را در محیطهای کنترلشده اعتبارسنجی کند و شواهدی مفصل برای بازبینی انسانی آماده سازد. در حالی که هوش عمومی GPT-5.5 را حفظ کرده، در انجام تکالیف طولانی و پیچیده برتری یافته است.
OpenAI معیارهای عملکردی دقیقی را برای این مدل بهروزرسانی شده ارائه کرده است که نشاندهنده عملکرد پیشرو (SOTA) آن است:
- CyberGym: این محک میسنجد که آیا یک عامل (Agent) — شبیه به کارمندی که میتواند بهطور مستقل ابزارهها را اجرا کند تا به هدف برسد — میتواند آسیبپذیریهای شناختهشده را در محیطهای نرمافزاری بازتولید کند. GPT-5.5-Cyber در ارزیابیهای تکمدلی به صحت ۸۵.۶٪ رسید که از امتیاز ۸۱.۸٪ مدل استاندارد GPT-5.5 بالاتر است. این بالاترین امتیاز CyberGym است که تاکنون برای یک مدل واحد اندازهگیری شده است.
- ExploitGym: این تست ارزیابی میکند که آیا عوامل میتوانند آسیبپذیریهای شناختهشده را به اکسپلویتهای عملی تبدیل کنند که منجر به اجرای کد غیرمجاز (Unauthorized Code Execution) شود. GPT-5.5-Cyber امتیاز ۳۹.۵٪ را کسب کرد که بهطور قابلتوجهی بالاتر از ۲۵.۹۵٪ مدل GPT-5.5 است.
- SEC-bench Pro: این معیار، کشف آسیبپذیری در افقهای زمانی بلند و تولید اثبات مفهوم (PoC) را در اهداف نرمافزاری پیچیده ارزیابی میکند. GPT-5.5-Cyber به ۶۹.۸٪ رسید، در حالی که این رقم برای GPT-5.5 برابر با ۶۳.۱٪ بود.
البته بنچمارکها تنها بخشی از داستان هستند. آنچه در عمل اهمیت دارد این است که آیا مدل میتواند آسیبپذیریهای واقعی را بیابد، مسائل عملیاتی را از نویز (Noise) تشخیص دهد و به مدافعان کمک کند تا اصلاحات را بهطور ایمن اعمال کنند. OpenAI همچنان در حال ارزیابی عملکرد روی مخازن پیچیده و گردشکارهای اصلاح واقعی است، همزمان با اینکه فرآیندهای افشای هماهنگشده را به پایان میرساند.
مقیاسبندی اصلاحات: Codex Security
کدکس سکیوریتی تواناییهای این مدل را به یک جریان کاری قابل استفاده برای توسعهدهنده تبدیل میکند. از زمان پیشنمایش پژوهشی در ماه مارس، این سیستم بیش از ۳۰ میلیون کامیت (Commit) را در بیش از ۳۰ هزار مخزن کد اسکن کرده است.
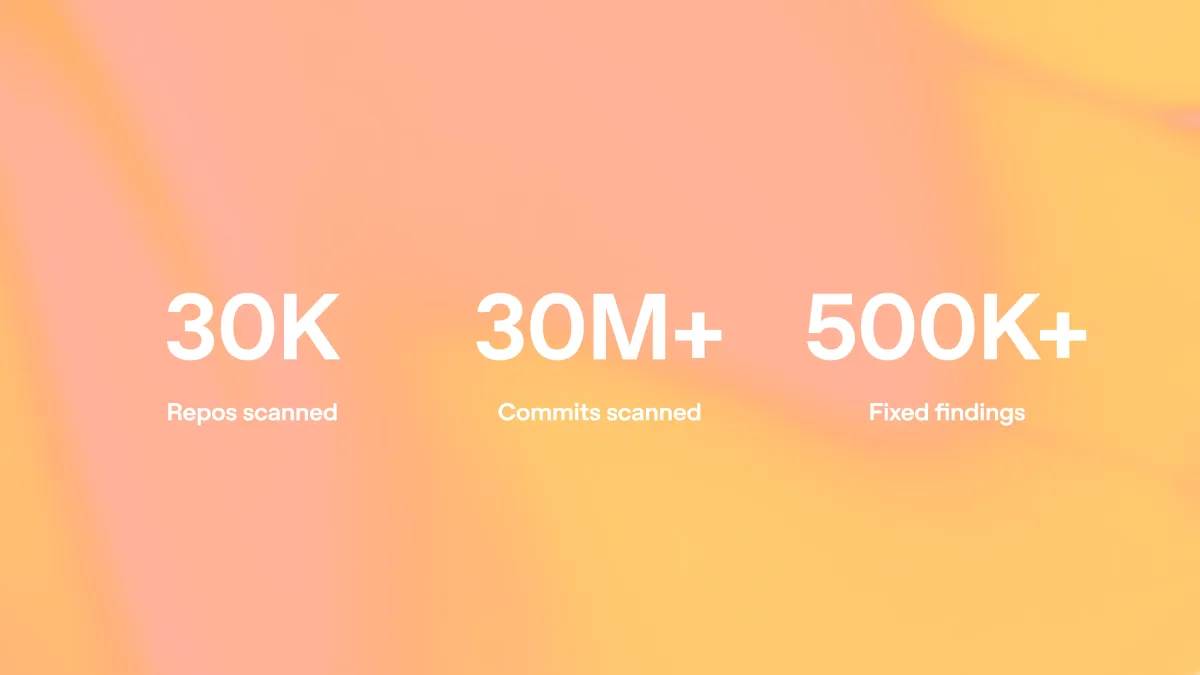
نتایج نشاندهنده مقیاس بحران فعلی است: بازبینهای انسانی ۷۰ هزار یافته را بهصورت دستی به عنوان «اصلاح شده» علامتگذاری کردند، در حالی که بیش از ۵۰۰ هزار یافته بهطور خودکار اصلاح شدند. این همان مقیاسی است که وصلهگذاری اکنون برای اثرگذار بودن باید در آن اتفاق بیفتد.
قابلیتهای کلیدی افزونه Codex Security
بهروزرسانی جدید افزونه Codex Security، گردشکارهای دفاعی امنیتی را بهصورت آمادهبهکار (Out-of-the-box) فراهم میکند. بهجای تولید صرفِ هشدارها، این ابزار مانند یک مهندس امنیت خودکار عمل میکند:
- اسکن و تحلیل: توسعهدهندگان میتوانند اسکنهایی را برای پوشش کل یک کدبیس، یک زیرمجموعه خاص، یا یک تغییر یا کامیت مشخص تنظیم کنند. آنها میتوانند اسکنهای عمیق اجرا کنند یا تغییرات اخیر را بازبینی نمایند.
- گزارشدهی و شواهد: ابزار گزارشهایی شامل سطوح شدت (Severity)، مکانهای کد آسیبدیده، شواهد اعتبارسنجی و راهنمای اصلاح تولید میکند. این ابزار میتواند مسیرهای حمله را ردیابی کرده و مدلهای تهدید (Threat Models) بسازد.
- اصلاح (Remediation): میتواند آسیبپذیریهای محتمل را شناسایی کند، تعیین نماید که آیا کد آسیبدیده قابل دسترس است یا خیر، وصلههای هدفمند توسعه دهد و نتیجه را تایید کند.
- یکپارچگی: افزونه میتواند یافتههای موجود از گزارشهای Bug-bounty، اطلاعیههای امنیتی یا اسکنرها را تریاژ کند. همچنین خروجیها را به سیستمهای مدیریت آسیبپذیری صادر کرده و با ابزارهایی که از فایلهای SARIF و کوئریهای CodeQL استفاده میکنند، یکپارچه میشود. علاوه بر این، از خطلولههای خودکار (Automated Pipelines) از طریق Codex CLI یا ادغام در اپلیکیشن Codex پشتیبانی میکند.
در تمام این مراحل، اپراتورهای انسانی کنترل کامل دارند و تصمیم میگیرند کدام یافتهها بررسی شوند، کدام تغییرات اعمال گردند و چه اطلاعاتی به اشتراک گذاشته شود.
طرح Patch the Planet و حمایت از اکوسیستم
OpenAI این ابزارها را محدود به مشتریان سازمانی پولی نکرده است. از طریق ابتکار «پچ د پلنت» (Patch the Planet) که با همکاری Trail of Bits و در همکاری با HackerOne و Calif تاسیس شد، این شرکت بودجه پژوهشگران امنیتی خبره را تامین کرده و آنها را به Codex Security و مدلهای پیشرفته مجهز میکند تا مستقیماً با نگهدارندگان (Maintainers) پروژههای متنباز همکاری کنند.
نرمافزارهای متنباز هر چیزی را، از زیرساختهای حیاتی تا خدمات عمومی، به حرکت در میآورند. با این حال، تفاوت فاحشی در ظرفیت نگهداری وجود دارد. پژوهشی از بنیاد لینوکس و دانشگاه هاروارد نشان داد که ۹۴٪ از پروژههای پرکاربرد، کمتر از ۱۰ توسعهدهنده داشتند که مسئول بیش از ۹۰٪ کدهای اضافهشده در سال بودند. این وضعیتی را ایجاد میکند که در آن AI میتواند هزاران گزارش تولید کند، اما نگهدارندگان هیچ ظرفیت اضافهای برای اصلاح آنها ندارند و اغلب مجبورند میان انبوهی از مثبتهای کاذب (False Positives) با کیفیت پایین جستجو کنند. نگهدارندگان نباید با گزارشهای بیشتر و بدون ظرفیت اضافه برای اصلاح، رها شوند.
برای حل این مشکل، Patch the Planet از یک رویکرد انسانمحور استفاده میکند:
- مشاوره: هر تعامل با مشاورهای بین پژوهشگران امنیتی و نگهدارندگان آغاز میشود. نگهدارندگان اولویتها، ترجیحات و فرآیندهای افشای تثبیتشده خود را تعریف میکنند.
- مدیریت سرتاسری (End-to-End): پژوهشگران، اعتبارسنجی و حذف موارد تکراری (Deduplication) both آسیبپذیریها و وصلهها را پیش از آنکه به دست نگهدارندگان برسد، مدیریت میکنند تا بار کاری آنها کاهش یابد و سرعت اصلاح افزایش یابد.
- ابزارهای حمایتی: پروژههای شرکتکننده، ChatGPT Pro، اعتبارهای API برای توسعه اصلی، اتوماسیون برای نگهداران، گردشکارهای انتشار و دسترسی مشروط به Codex Security دریافت میکنند.
بیش از ۳۰ پروژه متنباز متعهد به شرکت در این طرح شدهاند. شرکتکنندگان اولیه شامل cURL، Go، Python، Sigstore و pyca/cryptography هستند. در یک دویار (Sprint) اولیه پنجروزه در چندین پروژه، صدها مورد برای بازبینی شناسایی شد و دهها وصله ادغام (Merge) گردید. این دویار همچنین گردشکارهای بازاستفادهپذیری برای Fuzzing، تحلیل گونهها (Variant-analysis)، تست تفاضلی (Differential-testing) و تستهای مبتنی بر مشخصات (Specification-based testing) ایجاد کرد.
برنامه شرکای سایبری دیبریت
برای مقیاس بیشتر این مزایا، برنامه شرکای سایبری دیبریت (Daybreak Cyber Partner Program) به ارائهدهندگان پیشرو نرمافزار و خدمات امنیتی اجازه میدهد تا از GPT-5.5 با «دسترسی مورد اعتماد برای سایبر» استفاده کنند. این مدل، مدل اصلی برای اکثر گردشکارهای دفاعی امنیت سایبری است. این برنامه به شرکا اجازه میدهد تا قابلیتهای دفاعی مدل را در محصولات خود برای مشتریانشان ادغام کنند، در حالی که دسترسی مستقیم به مدل در دستان شرکای شرکتکننده باقی میماند.
OpenAI برای تقویت حفاظها، نظارت و استانداردهای پیشگیری از سوءاستفاده که برای استقرار مسئولانه این قابلیتها در اکوسیستم امنیتی لازم است، به همکاری با این شرکا ادامه میدهد. این برنامه با مجموعهای اولیه از شرکا در حال اجراست و برنامههایی برای گسترش به سازمانهای بیشتر در ماههای آینده دارد.
حاکمیت و امنیت جهانی
استقرار چنین تواناییهای قدرتمندی نیازمند حفاظهای (Guardrails) قابلتوجهی است. OpenAI گفتگوهای مستمری با دولت ایالات متحده درباره رویکرد سایبری خود داشته است. این شامل همکاری با مرکز استانداردهای هوش مصنوعی و نوآوری (CAISI) برای تستهای پیش از استقرار GPT-5.5 و 5.5-Cyber است. علاوه بر این، آنها با دفتر ملی مدیر سایبری (ONCD) و دفتر سیاستهای علم و فناوری (OSTP) برای اجرای دستور اجرایی اخیر و استانداردهای صنعتی مرتبط همکاری میکنند.
فراتر از ایالات متحده، OpenAI شراکتهای «دسترسی مورد اعتماد» را با چندین نهاد و دولت بینالمللی برای محافظت از زیرساختهای حیاتی برقرار کرده است، از جمله:
- استرالیا، کانادا، فرانسه، آلمان، ژاپن و جمهوری کره.
- نهادهای اتحادیه اروپا مانند ENISA.
- دولت بریتانیا، با تمرکزی بر همکاری در زمینههای سایبری، تست، ارزیابی و سایر حوزههای مورد علاقه مشترک.
OpenAI قصد دارد مستقیماً با اپراتورهای واجد شرایط زیرساختهای حیاتی، از جمله شبکههای دولتی، برای توسعه حفاظهای سفارشیسازی شده همکاری کند. تمرکز بر این است که AI پیشرفته برای مدافعان مفیدتر شود و در عین حال برای بازیگران مخرب سختتر باشد که بتوانند آسیبهای واقعی در دنیای واقعی ایجاد کنند. آنها همچنین با مشتریان سازمانی همکاری میکنند تا زمینه (Context) گستردهتر و شناسههای مربوط به سیستمهای خاص را برای جلوگیری از فعالیتهای سایبری مضر در خدمات حیاتی لحاظ کنند. در این راستا، OpenAI بر ایمنی دادهها در محیطهای حساس تأکید دارد؛ برای مثال، راهکارهای جدیدی مانند Lockdown Mode در ChatGPT برای جلوگیری از نشت اطلاعات از طریق حملات تزریق پرامپت معرفی شدهاند تا لایههای امنیتی کاربران سازمانی تقویت شود.
واقعیت جدید دفاعی
این تحول، صنعت را از ذهنیت «اول تشخیص» (Detection-first) به استراتژی «اول اصلاح» (Remediation-first) میبرد. برای اکثر مدافعان، نقطه شروع فعلی GPT-5.5 با دسترسی مورد اعتماد برای سایبر و Codex Security است. با این حال، GPT-5.5-Cyber برای مدافعان تاییدشدهای در نظر گرفته شده است که کار مجاز آنها نیازمند پیشرفتهترین توانمندیها و رفتار پذیرندهتر است، که با تایید، نظارت، کنترلهای محدودشده و بازبینیهای سختگیرانهتر همراه است.
این ابزارها پیش از این به مدافعان کمک کردهاند تا آسیبپذیریها را در سیستمهای پرکاربردی از جمله Firefox، V8، Safari، OpenBSD، FreeBSD و پیادهسازیهای HTTP/2 شناسایی و اعتبارسنجی کنند. هدف دیگر فقط یافتن یک باگ نیست، بلکه بستن چرخه اصلاح — اعتبارسنجی، وصلهگذاری و استقرار — بدون ایجاد گلوگاه انسانی است.
OpenAI با ارائه مدلی تخصصی مانند GPT-5.5-Cyber به مدافعان تاییدشده، روی این فرض شرطبندی کرده است که تنها راه شکست دادن یک مهاجم مجهز به AI، داشتن یک مدافع مجهز به AI است. موفقیت این استراتژی به این بستگی دارد که آیا نگهدارندگان و مدافعان انسانی میتوانند از این ابزارها برای رسیدن به دنیایی با نرمافزارهای ایمنتر و تابآوری کامل سایبری استفاده کنند یا خیر.
گام بعدی شما
- اگر مدیر فنی هستید، بررسی کنید که آیا ابزارهای فعلی شما فقط «هشدار» میدهند یا میتوانند «وصله» تولید کنند.
- برای توسعهدهندگان متنباز، بررسی کنید که آیا پروژه شما واجد شرایط طرح Patch the Planet برای دریافت منابع رایگان است یا خیر.
- روی اتوماسیون جریانهای کاری امنیت (Security Workflows) تمرکز کنید تا از حجم گزارشهای AI غافلگیر نشوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو