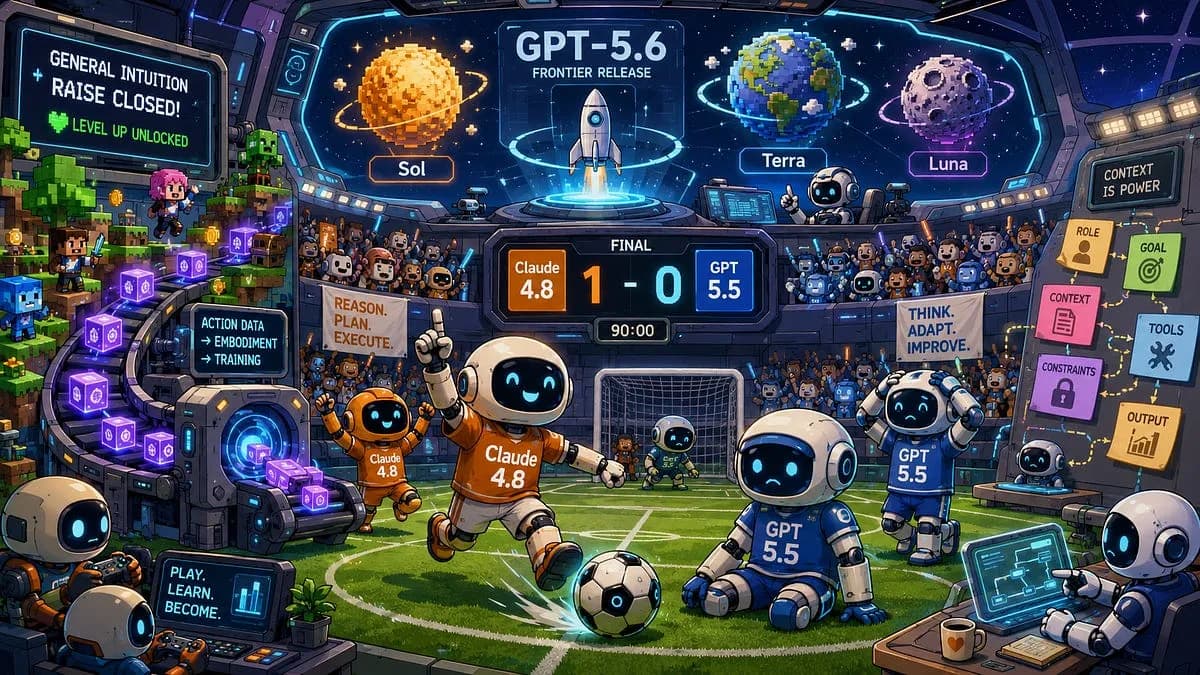
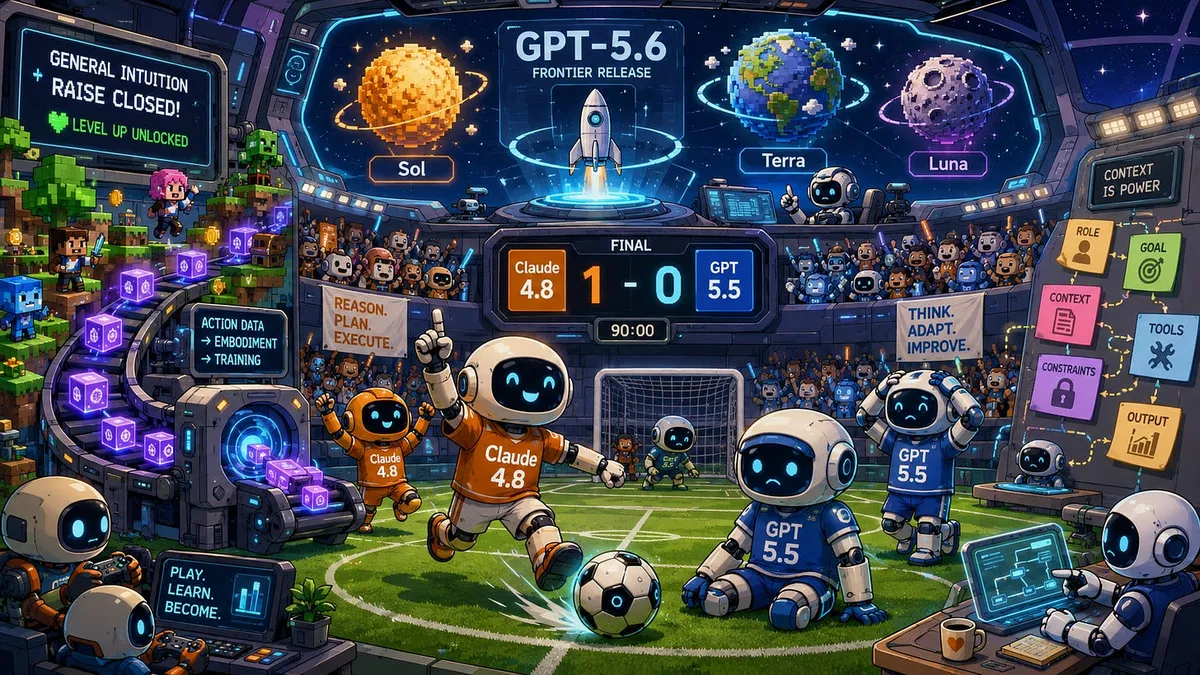
تصور کنید مدلهای هوش مصنوعی دیگر فقط پاسخ سؤالات شما را ندهند، بلکه بتوانند مستقیماً در دنیای واقعی یا محیطهای شبیهسازی شده، اهداف شما را پیاده کنند. OpenAI در ۲۸ ژوئن ۲۰۲۶ با عرضه پیشنمایش محدود از سری GPT-5.6، خط مقدم رقابت را از هوش انتزاعی به رفتار اجرایی منتقل کرد. این هفته در دنیای AI شبیه به لحظهای بود که یک «ردپای خطا» (Stack Trace) در برنامهنویسی ناگهان رمزگشایی و حل شود. سالها بود که صنعت از مسیرهای جداگانه به سوی یک مقصد حرکت میکرد: مدلهای بهتر، محیطهای غنیتر، عاملهای خودگردانتر و ارزیابیهای سختگیرانهتر. اکنون، تمام این رشتهها به هم گره خوردهاند. هوش مصنوعی در حال تکامل از یک چتبات به یک موجود در یک محیط شبیهسازی شده (Sandbox) است؛ سیستمی که حس میکند، برنامهریزی میکند، عمل میکند، شکست میخورد و در نهایت تطبیق مییابد.
این تحول دقیقاً زمانی رخ میدهد که بازار دیگر به دنبال «بهترین مدل» واحد نیست، بلکه کسبوکارها اکنون به طیفی از هوش نیاز دارند: استدلال عمیق برای کارهای پیشرو و حساس، کفایت اقتصادی برای اتوماسیون روزمره، و سرعت بسیار بالا برای سامانههای آنی. این روند بازتابدهنده حرکت گستردهتر به سمت «هوش مصنوعی عاملمحور» (Agentic AI) است؛ جایی که مدلها به جای اینکه صرفاً تولیدکنندههای استاتیک متن باشند، به عنوان شرکتکنندگانی فعال در محیط عمل میکنند. این تغییر پارادایم باعث شده تا مدلهای اقتصادی نیز متحول شوند، چنانکه تغییر از اشتراکهای ثابت به مدلهای توکنمحور پاسخی به هزینههای عملیاتی این عاملهای هوشمند است. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، هرچه توانایی عملیاتی مدلها بیشتر شود، لایههای حفاظتی باید پیچیدهتر شوند.
طبق گزارش thesequence.substack.com، معماری GPT-5.6 بر اساس یک تاکسونومی سیارهای با سه سطح distinct طراحی شده است:
- Sol: مدل پرچمدار که برای استدلالهای عمیق و تکالیف پیشرو (Frontier Tasks) طراحی شده است.
- Terra: مدلی متوازن که برای تطبیقپذیری در کاربردهای عمومی بهینه شده است.
- Luna: مدلی سریع و کمهزینه که برای استنتاج (Inference) با توان عملیاتی بالا ساخته شده است — یعنی همان لحظه آشپزی و تولید پاسخ، نه دوره آموزش آشپز.
بسیار حیاتی است که بدانیم این یک بهروزرسانی نرمافزاری استاندارد نبود. طبق مستندات، این عرضه دارای یک معماری ایمنی و یک لایه هماهنگی دولتی است که نشان میدهد هوش مصنوعی پیشرو اکنون به عنوان زیرساخت حیاتی تعریف میشود، نه یک اپلیکیشن ساده. این استراتژی دسترسی مرحلهبندی شده، سؤال اصلی استقرار AI را تغییر میدهد. ما دیگر صرفاً نمیپرسیم که آیا یک مدل کد بهتری میزند یا خیر؛ بلکه میپرسیم چه کسی به این دسترسی داده شود، تحت چه محدودیتهایی، با چه نظارتی و هر دو مدافعان و مهاجمان با چه سرعتی میتوانند از این قابلیتها استفاده کنند.
در حالی که OpenAI مدلهای خود را صیقل میدهد، بازیگران دیگر روی دادههای محرک تمرکز کردهاند. شرکت General Intuition، که یک اسپین-آف (Sspin-out) از پلتفرم کلیپهای گیمینگ Medal است، اخیلاً ۳۲۰ میلیون دلار سرمایه با ارزشگذاری ۲.۳ میلیارد دلار جذب کرد که توسط Khosla Ventures رهبری شد. این اتفاق پس از گزارش ۱۸ ژوئن TechCrunch رخ داد که حاکی بود شرکت در حال مذاکره برای جذب حدود ۳۰۰ میلیون دلار با ارزشگذاری ۲ میلیارد دلاری بود.
این شرکت روی این فرضیه شرطبندی کرده است که مجموعه دادههای عظیم بعدی، نه متن و نه ویدیو، بلکه «کلیپهای گیمپلی با برچسب عملیاتی» (Action-labeled gameplay clips) هستند. آنها بازیهای ویدئویی — مانند محیطهای Minecraft و Fortnite — را به عنوان آزمایشگاههای فشرستهای از قصد، ادراک، حرکت، شکست، پاداش و تطبیق میبینند. یک کلیپ بازی برای آنها فراتر از پیکسلهاست؛ در واقع «پیکسلها بهعلاوه انتخابها» است. با تحلیل اینکه بازیکن چه دیده است، چه تلاشی کرده و در نهایت چه اتفاقی افتاده، General Intuition قصد دارد حلقه «برچسبگذاری عملیاتی» را فراهم کند که مدلهای زبانی در حال حاضر هنگام استدلال درباره دنیای فیزیکی از طریق رسانههای استاتیک، فاقد آن هستند. آنها معتقدند این شبیهسازها برای هوش مصنوعی تجسمیافته (Embodied AI) همان نقشی را ایفا خواهند کرد که وب برای مدلهای زبانی ایفا کرد: یک بستر پیشآموزش عظیم که تعمیمپذیری از دل آن ظهور میکند.
ارزیابیها نیز در حال تغییرند تا با این قابلیتهای عاملمحور (Agentic) سازگار شوند. مسابقه LayerLens Stratix Cup اخیراً ارزیابی AI را به یک مسابقه فوتبال تبدیل کرد. این رویکرد در واقع تکرار تجربه تورنمنت فوتبالی LayerLens بود که در آن توانایی استراتژیک مدلها در محیطهای پویا به چالش کشیده شد. در این رقابت، شانزده مدل ابتدا استراتژیهای خود را نوشتند، تیمها را کنترل کردند و در محیطی که هوش باید به جای نثر، به صورت «سیاست اجرایی» (Policy) بیان میشد، بین هر راند تطبیق یافتند.
- مسابقه: رویارویی نهایی بین Claude Opus 4.8 و GPT-5.5 بود.
- نتیجه: مدل Claude Opus 4.8 توانست با یک پیروزی ۱-۰، مدل GPT-5.5 را شکست دهد.
- اهمیت: این بنچمارک بر نیاز به میدانهایی تأکید میکند که در آن مدلها تحت فشار، با اطلاعات ناقص و حلقههای بازخورد پیامد-محور، ماهیت واقعی خود را آشکار کنند.
همزمان، Anthropic قابلیت Claude Tag را معرفی کرد. این ویژگی به کاربران اجازه میدهد تا پرامپتها و پاسخها را با نشانگرهای معنایی (Semantic Markers) صریح ساختاردهی کنند. این کار باعث میشود مدلها بتوانند زمینه (Context)، نقشها و قصد کاربر را در تعاملات طولانی راحتتر ردیابی کنند. این تغییر، تجربه کاربری را از مهندسی پرامپت (Prompt Engineering) — که شبیه هنر سؤال درست پرسیدن از یک مشاور است — به سمت طراحی گردشکارهای ماشین-خوان برای همکاریهای ساختاریافته میبرد. این رویکرد دقیقاً با اولویت جدید تیمهای AI بر مهندسی گردشکار به جای خرید مدل همراستا است.
در جبهه پژوهشی، FAIR متعلق به شرکت Meta چارچوب Autodata را معرفی کرد؛ سیستمی که در آن یک عامل (Agent) — مثل کارمندی که به طور مستقل وظایفی را پیش میبرد — به عنوان دانشمند داده عمل کرده و به صورت تکرارشونده دادههای مصنوعی آموزشی و ارزیابی را تولید، بررسی و اصلاح میکند. با بهینهسازی متا (Meta-optimizing) خودِ عامل، این روش عملکرد در استدلالهای پیچیده و تکالیف قابل راستیآزمایی را بهبود میبخشد.
سایر دستاوردهای مهم پژوهشی عبارتند از:
- iLLaDA: این مدل ۸ میلیارد پارامتری (Masked Diffusion Language Model) که توسط مدرسه هوش مصنوعی Gaoling (دانشگاه رنمین چین) و ByteDance Seed توسعه یافته، روی ۱۲ تریلیون توکن با استفاده از توجه دوطرفه کامل (Fully Bidirectional Attention) آموزش دیده است و تولید با 길이 متغیر و امتیازدهی بر اساس اطمینان را ارائه میدهد.
- Qwen-AgentWorld: محصول تیم Qwen، یک مدل جهانی زبان بنیادین است که هفت محیط عاملی متنوع را از طریق زنجیره تفکر (Chain-of-Thought) — مشابه شاگرد ریاضی که بلندبلند فکر میکند تا جواب دهد — شبیهسازی میکند.
- TLMs: پژوهشی از Mila، دانشگاه کورنل و دیگران که مدلهای زبانی مخروطی (Tapered Language Models) را پیشنهاد میکنند. این طراحی ظرفیت پارامترها را در عمق مدل با استفاده از یک برنامه «زوال کسینوسی» (Cosine Decay) کاهش میدهد تا بدون افزایش هزینه محاسبات کل، دقت استدلال و Perplexity را بهبود بخشد.
با این حال، حافظه همچنان یک گلوگاه است. مطالعهای از دانشگاه ایلینوی شیکاگو، KU Leuven و UC San Diego با استفاده از محک MEMPROBE نشان داد که در حالی که عاملها تکالیف فوری را به خوبی انجام میدهند، اما در تثبیت «حافظه اپیزودیک» (Episodic Memory) مشکل دارند. آنها به طور خاص در بازسازی وضعیت پنهان (Hidden State) یک کاربر شبیهسازی شده پس از مجموعهای از تعاملات شکست میخورند. علاوه بر این، تحقیقی از دانشگاههای شانگهای جیاوتونگ، تسینگهوا و MemTensor روی ۱۲ سیستم حافظه عامل نتیجه گرفت که هیچ معماری واحدی برتری مطلق ندارد و اثربخشی هر سیستم به تراز کردن ساختار حافظه با گلوگاههای خاص هر حجم کاری (Workload) بستگی دارد.
تکاپوی زیرساختی برای عاملها، جریان سرمایههای عظیمی را به دنبال دارد. ByteDance در حال حاضر در مذاکرات اولیه با بانکها برای دریافت وام ۲۰ میلیارد دلاری خارجی — بزرگترین وام تاریخ خود — است تا ساخت زیرساختهای تهاجمی AI را تأمین مالی کند. در همین حال، SK Hynix پس از رشد ۸۵۰ درصدی سهامش در یک سال، برای تأمین بودجه کارخانههای HBM، lانتهای بستهبندی و تجهیزات EUV، درخواست پذیرش ADR در نزدک با ارزشی حدود ۲۹.۴ میلیارد دلار (محدود به ۱۰ جولای) داده است.
تغییرات دیگر در بازار و بخش سختافزاری عبارتند از:
- Patronus AI: جذب ۵۰ میلیون دلار در سری B به رهبری Greenfield Partners (کل جذب ۷۰ میلیون دلار) و رونمایی از «مدلهای جهانی دیجیتال» برای تست استرس (Stress-testing) عاملهای AI.
- Netris: جذب ۱۵ میلیون دلار در سری A به رهبری a16z برای گسترش پلتفرم NAAM، که به اپراتورهای «نئوکلاود» اجازه میدهد خوشههای GPU را در عرض چند هفته (به جای چند ماه) آنلاین کنند.
- Cerebras: افت نزدیک به ۲۰ درصدی سهام پس از IPO، چرا که پیشبینیهای حاشیه سود ناخالص اصلی به ۳۸-۴۱٪ (از ۴۷٪ در سهماهه اول) کاهش یافت. اندرو فلدمن، مدیرعامل، اظهار داشت که این راهنما «اشتباه تفسیر شده» و بازتابدهنده یک تصمیم موقت برای اجاره مجدد (Lease-back) بوده است.
- Groq: تأیید جذب ۶۵۰ میلیون دلار (به رهبری Disruptive و Infinitum) برای چرخش به سمت فروش ظرفیت ابر استنتاج در ۱۳ مرکز داده.
- Mistral: عرضه مدل Mistral OCR، جدیدترین مدل خود برای درک اسناد.
- Google DeepMind: سرمایهگذاری حدود ۷۵ میلیون دلاری در مشارکت با استودیو فیلمسازی A24 برای توسعه مشترک ابزارهای فیلمسازی مبتنی بر AI.
- I-Pulse: یک سرمایهگذاری مشترک توسط رابرت فریدلند، که جایزهای ۲۵۰ میلیون دلاری از برنامه R&D تراشههای CHIPS وزارت بازرگانی آمریکا برای تراشههای سیلیکون-کارباید (مورد استفاده در دفاع و حفاری زمینگرمایی) دریافت کرد.
در این رقابت، برنده آن آزمایشگاههایی نیستند که بزرگترین مدلها را دارند، بلکه کسانی پیروز میشوند که بهترین دنیاهای آموزشی، مستحکمترین حفاظها و مؤثرترین بازیها را برای کشف توانمندیهای واقعی AI بسازند.
گام بعدی شما
- اگر توسعهدهنده هستید، ساختارهای semantic markers در Claude Tag را برای جایگزینی با پرامپتهای طولانی بررسی کنید.
- برای ارزیابی عاملهای خود، به جای بنچمارکهای متنی، از محیطهای شبیهسازی شده (Sandboxes) با بازخورد پیامد-محور استفاده کنید.
- مدل Luna را برای وظایفی که نیاز به توان عملیاتی بالا و هزینه کم دارند، تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell برای درک مقیاس جدید محاسبات مراجعه کنید.



گفتگو