اگر در اتحادیه اروپا از هوش مصنوعی برای نوشتن گزارشهای کاری یا ایمیلهای رسمی استفاده میکنید، باید بدانید که از این پس ردپای دیجیتال شما قابل ردیابی است. متنهای تولیدشده توسط ChatGPT و Codex دیگر «ناشناس» نخواهند بود.
این تغییر در پاسخ به قانون هوش مصنوعی اتحادیه اروپا (EU AI Act) رخ میدهد که قوانین شفافیت آن از ۲ اوت ۲۰۲۶ اجرایی شده است. طبق اعلام OpenAI در ۵ اکتبر ۲۰۲۶، این شرکت برای تضمین انطباق با قوانین، یک امضای دیجیتال نامرئی را به خروجیهای متنی خود برای تمام کاربران اتحادیه اروپا اضافه میکند. همانطور که در تحلیل قبلی ما دربارهی پیشرفتهای OpenAI در استدلالهای پیچیده — مانند مدلی که ۳۷۲ مسئله ریاضی قدیمی را حل کرد — اشاره کردیم، اکنون تمرکز صنعت از افزایش تواناییهای حل مسئله به سمت پاسخگویی قانونی در مورد خودِ خروجیها تغییر کرده است.
این سیستم بر پایه روشی به نام textGrain عمل میکند — شبیه به یک مهر نامرئی که روی کاغذ میزنند و فقط با نور خاص دیده میشود. این تکنیک که با همکاری پژوهشگران دانشگاه ییل و دانشگاه پنسیلوانیا توسعه یافته، پیشبینی کلمات بعدی توسط مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را با استفاده از یک کلید محرمانه تغییر میدهد. به نقل از پست وبلاگی OpenAI، این الگو بهگونهای ایجاد میشود که حتی در صورت کپی و چسباندن (Copy-Paste) متن نیز دستنخورده باقی میماند.
جزئیات فنی این استقرار به شرح زیر است:
- زمان دسترسی: طی هفتههای آینده برای تمام طرحهای کاربری در اتحادیه اروپا فعال میشود؛ توسعهدهندگان API در سراسر جهان همین امروز میتوانند آن را بهصورت دستی فعال کنند.
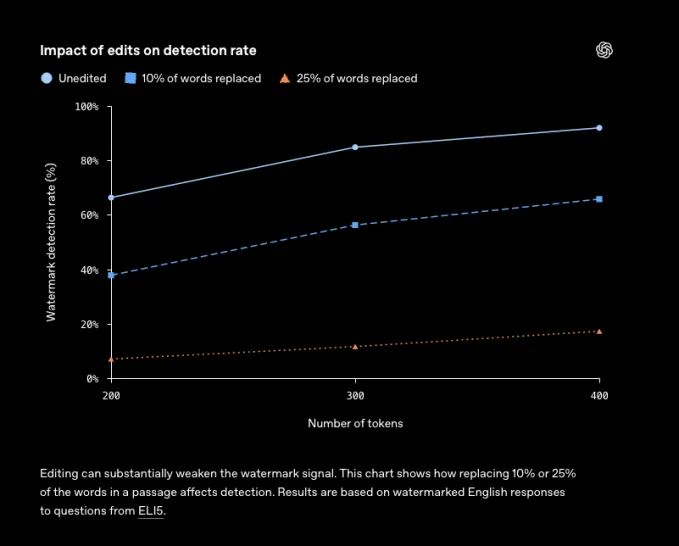
- دقت تشخیص: در تستهای داخلی، جایگزینی ۱۰٪ از کلمات با مترادفها، نرخ تشخیص را از ۹۲٪ به ۶۶٪ کاهش داد.
- محدودیتها: تشخیص متنهای کوتاه، پاسخهای ریاضی و متون ترجمهشده بهشدت دشوارتر است.
OpenAI هشدار داده است که نبودِ نشانگذاری (Watermark) لزوماً به معنای نویسندگی انسانی نیست، زیرا ویرایشهای گسترده یا استفاده از مدلهای هوش مصنوعی متفاوت میتواند این سیستم را دور بزند. به همین دلیل، این شرکت دسترسی به ابزار تشخیص را فعلاً محدود به پژوهشگران تأییدشده و سازمانهای خبره کرده است تا قابلیت اطمینان سیستم را ارزیابی کنند.
این تصمیم در راستای یک حرکت جهانی است؛ مشابه اقدامی که شرکت Anthropic برای مدل Claude انجام داد. آن اقدام با واکنش منفی کاربرانی مواجه شد که احساس میکردند هوش مصنوعی صرفاً ابزاری برای تصمیمات خلاقانه آنهاست. همچنین گزارشهای سال ۲۰۲۴ حاکی از آن است که OpenAI پیش از این برای جلوگیری از مهاجرت کاربران به رقبایی که واترمارک ندارند، در اجرای این قابلیت تأخیر کرده بود.
برای کاربر عادی، این یعنی ایمیلها یا گزارشهای شما که با کمک هوش مصنوعی در اتحادیه اروپا نوشته شدهاند، اکنون از نظر فنی قابل ردیابی هستند. اگرچه متن کاملاً یکسان به نظر میرسد، اما توزیع کلمات زیرین مانند یک اثر انگشت برای رگولاتورها و پژوهشگران عمل میکند.
این تغییر سیگنالی برای پایان عصر «هوش مصنوعی نامرئی» در اروپا است. با تعهد شرکتهایی مثل گوگل، متا و مایکروسافت به کد اخلاقی اتحادیه اروپا، توانایی اثبات اینکه یک متن صرفاً توسط انسان نوشته شده، به یک دارایی ممتاز در نویسندگی حرفهای تبدیل خواهد شد.
گام بعدی شما
- اگر توسعهدهنده هستید، تنظیمات API خود را برای تست قابلیت نشانگذاری بررسی کنید تا با استانداردهای اتحادیه اروپا سازگار شوید.
- در نوشتههای حساس، به جای تکیه بر عدم تشخیص، بر شفافیت در استفاده از ابزارها تأکید کنید.
- نحوه ادغام این تشخیصدهندهها در نرمافزارهای سرقت ادبی (Plagiarism) دانشگاههای اروپا را دنبال کنید، زیرا این موضوع میتواند نحوه نمرهدهی به تکالیف مدرسه و دانشگاه را بهطور بنیادی تغییر دهد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو