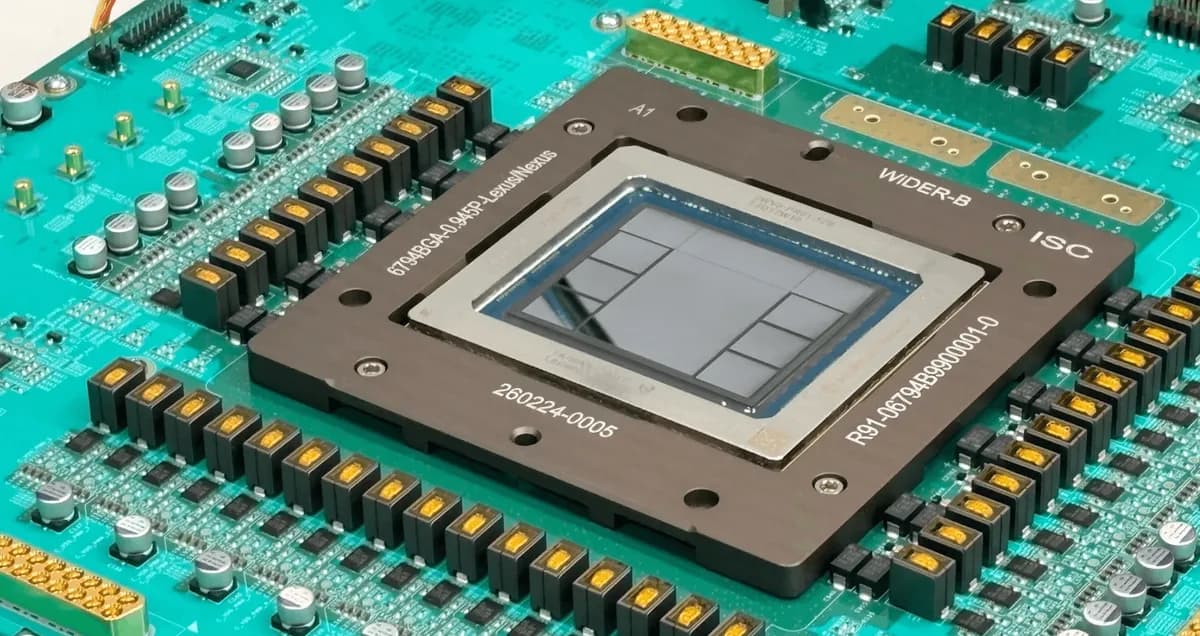
اگر امروز برای اجرای مدلهای زبانی هزینه میپردازید، احتمالاً بهزودی با کاهش چشمگیر قیمتها روبرو میشوید؛ چرا که OpenAI با معرفی تراشه Jalapeño، بازی سختافزاری را به نفع خود تغییر داد.
به گزارش وبسایت the-decoder.com در ۲۵ اوت ۲۰۲۶، این تراشه اختصاصی میتواند تا ۱.۹ برابر بیشتر از معماریهای Blackwell و Rubin انویدیا، در هر وات انرژی، پردازش هوش مصنوعی انجام دهد. این یعنی کاهش شدید هزینههای برق و افزایش سرعت پاسخدهی مدلها.
این حرکت در حالی رخ میدهد که آزمایشگاههای بزرگ برای رهایی از وابستگی به تامینکنندگان خارجی رقابت میکنند. همانطور که در تحلیل قبلی ما دربارهی تلاش OpenAI و Anthropic برای کنترل نیمی از محاسبات جهان تا سال ۲۰۲۷ اشاره کردیم، Jalapeño نخستین گام فیزیکی به سوی این یکپارچگی عمودی است. برای اکثر کسبوکارها، این اتفاق به معنای کاهش «مالیات GPU» است؛ یعنی هزینهای که بابت اجاره سختافزارهای گرانقیمت انویدیا پرداخت میکردند.
هوش مصنوعی زاینده (Generative AI) — مثل هنرمندی که میلیونها اثر را دیده و حالا میتواند بر اساس الگوها، چیزهای جدید خلق کند — حالا ابزاری دارد که دقیقاً برای نیازهایش ساخته شده است. OpenAI در کنفرانس Hot Chips نخستین بنچمارکهای این تراشه را رونمایی کرد. برخلاف تراشههای آموزشی، Jalapeño یک شتابدهنده استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی و نه دورهی آموزش آشپز — است. این تراشه برای مدلهای مختلف بهینهسازی شده و فقط محدود به مدلهای داخلی OpenAI نیست.
دایل پاتل، مدیرعامل SemiAnalysis، اشاره کرد که معمولاً نسل اول تراشهها رقابتی نیستند، اما Jalapeño همین حالا از Blackwell و Rubin پیشی گرفته است. او معتقد است مقایسه عادلانهتر با پلتفرم Vera Rubin است، زیرا هر دو از حافظه HBM4 استفاده میکنند.
طبق دادههای منتشر شده از محک InferenceAnalysis، نتایج کلیدی این تراشه عبارتند از:
- بازدهی: ۱.۵ تا ۱.۹ برابر کار بیشتر در هر وات انرژی در اوج توان عملیاتی.
- تأخیر: کاهش ۱.۷ تا ۳.۶ برابری تأخیر سرتاسری نسبت به برترین سیستمهای فعلی.
- بارهای کاری تعاملی: افزایش عملکرد بین ۲.۱ تا ۴.۱ برابر.
- مدل GPT-OSS 120B: دستیابی به حدود ۱۴۰۰ توکن (Token) — تکههای کوچکی از متن، مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — در ثانیه برای هر کاربر.
- مدل Deepseek R1 670B: ثبت رکورد ۷۰۰ توکن در ثانیه در یک درخواست همزمان.
- مدل Kimi K2.5 1T: حضور در مجموعه تستهای بنچمارک.
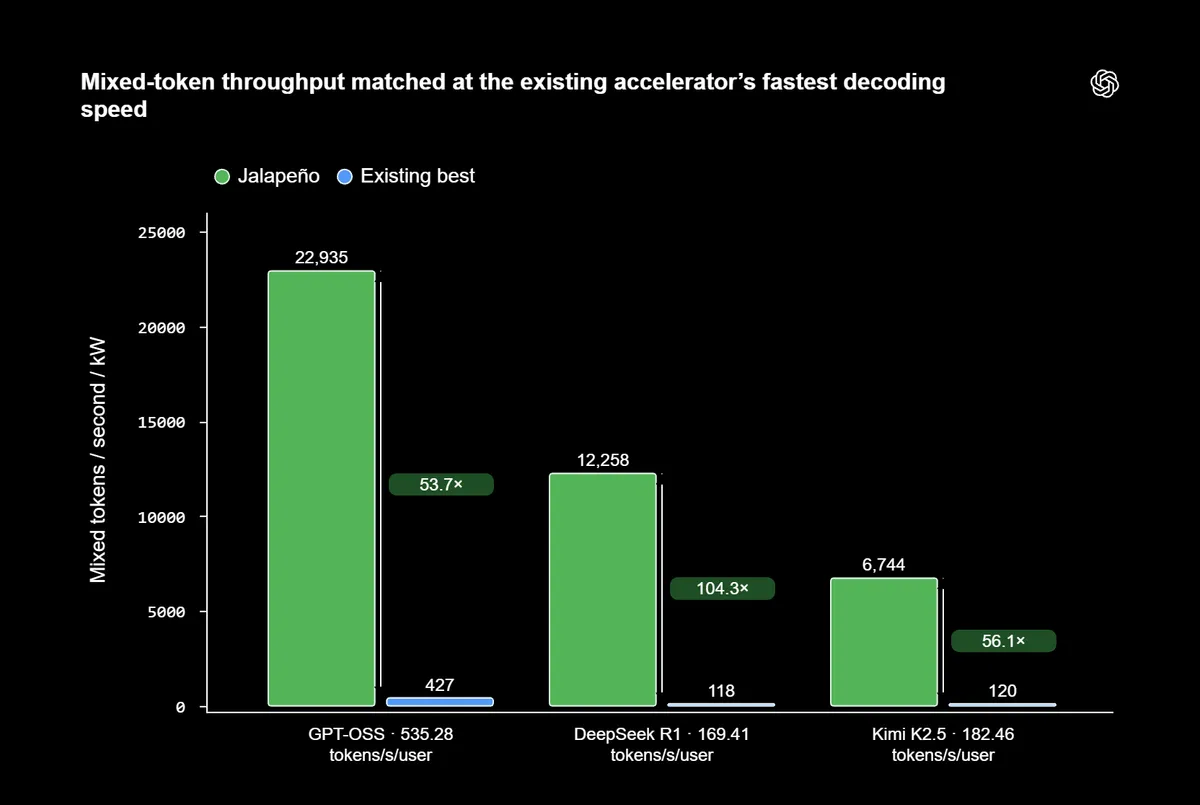
در سرعتهای رمزگشایی یکسان، Jalapeño بسته به مدل مورد استفاده، ۵۴ تا ۱۰۴ برابر بیشتر از بهترین شتابدهندههای موجود، توکن در هر کیلووات تولید میکند. نکته مهم این است که این اعداد بدون استفاده از بهینهسازیهایی مثل رمزگشایی گمانهزنانه (Speculative Decoding) به دست آمدهاند.
OpenAI این تراشه را با همکاری Broadcom توسعه داد. طراحی از اواسط ۲۰۲۴ آغاز شد و در نوامبر ۲۰۲۵ به مرحله تولید رسید. اگرچه کل چرخه ۱۶ ماه طول کشید، اما شرکت ادعا میکند تنها ۹ ماه بین طراحی اولیه و نقشه نهایی فاصله بود. نکته شگفتانگیز این است که OpenAI از مدلهای هوش مصنوعی خودش برای تسریع این فرآیند استفاده کرد؛ مدلهای قدیمیتر در طراحی سختافزار و مدلهای جدیدتر در برنامهنویسی و بهینهسازی کمک کردند.
این سرعت در توسعه نشان میدهد که «خندق CUDA» انویدیا — اکوسیستم نرمافزاری که توسعهدهندگان را به سختافزار این شرکت زنجیر کرده بود — در حال تبخیر شدن است. SemiAnalysis مینویسد که با این سرعت در ساخت سیلیکون، این خندق احتمالاً «مرده است».
با این حال، این تراشه جایگزین کامل انویدیا نیست. سارا فرایر، مدیر مالی OpenAI، اعلام کرد که Jalapeño مکمل همکاریهای فعلی با Nvidia، AMD، AWS، Cerebras و CoreWeave است. این رویکرد مکمل، در حالی است که OpenAI پیشتر برای آموزش نسل جدید مدلهای خود به سیستمهای رکمقیاس GB200 انویدیا روی آورده بود تا حداکثر توان پردازشی را به دست آورد. او این تراشه را بخشی از یک سیستم یکپارچه میبیند که در آن مراکز داده، تراشهها و دستگاهها مانند یک موجود واحد عمل میکنند.
البته محدودیتهایی هم وجود دارد. Jalapeño فعلاً در قالب نمونههای مهندسی است، در حالی که سیستمهای Rubin انویدیا در حال ارسال به مشتریان هستند. همچنین انویدیا و AMD نتایجی برای مدلهای بزرگتر مثل Deepseek V4 Pro منتشر کردهاند که Jalapeño هنوز آنها را تست نکرده است. در نهایت، هزینه کل مالکیت به ازای هر توکن، در حال حاضر برای هر دو سیستم تقریباً برابر است.
گام بعدی شما
- اگر مدیر محصول هستید، کاهش هزینههای استنتاج را در بودجهبندی سال آینده برای مدلهای بزرگ پیشبینی کنید.
- توسعهدهندگان باید روی مدلهای بازمتن (Open Weights) تمرکز کنند، زیرا تراشههای جدید مثل Jalapeño برای اجرای متنوع مدلها طراحی شدهاند.
- تغییرات در قیمتگذاری APIهای OpenAI را رصد کنید تا ببینید آیا این بازدهی سختافزاری به تخفیف برای کاربر نهایی تبدیل میشود یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو