
شکاف بین ۱۳.۳٪ و ۳۸.۳٪ را تصور کنید. این جهش سه برابری در عملکرد GPT-5.6 Sol در محک ARC-AGI-3 نه از طریق ارتقای مدل، بلکه با یک تغییر ساده در تنظیمات پیکربندی به دست آمد. این نتیجه که توسط OpenAI منتشر شده است، یک نقص بحرانی در نحوه اندازهگیری هوش مصنوعی عاملمحور (Agentic AI) در صنعت را برملا میکند: «شکست» مدل در واقع ناشی از نقص در محیط اجرای API (Harness) بود، نه ظرفیتهای ذهنی یا هوش ذاتی مدل.
بیش از یک سال است که در فضای هوش مصنوعی بحث میشود که آیا مدلهای پیشرو میتوانند واقعاً قوانین را از طریق تعامل یاد بگیرند. اکثر محکها برای تضمین عدالت بین مدلهای مختلف از یک «محیط اجرای عمومی» (Generic Harness) استفاده میکنند. اما این محیطها اغلب با مدل مانند یک تابع بدون وضعیت (Stateless) برخورد میکنند و دقیقاً همان زنجیره تفکر (Chain-of-Thought) را حذف میکنند که به مدل اجازه میدهد در طول چندین نوبت، نظریهای درباره یک مسئله بسازد.
همانطور که در تحلیلهای پیشین ما دربارهی حافظه مدلهای زبانی اشاره کردیم، مدیریت وضعیت (State) کلید تبدیل یک چتبات ساده به یک عامل فعال است.
زمینه و جزئیات آزمایش
این یک آزمایش طبیعی و دقیق بود. مدل کاملاً یکسان باقی ماند. مجموعه وظایف یکسان بود. خودِ محک نیز بدون تغییر ماند. تنها متغیرهایی که تغییر کردند، تنظیمات API در ستون سمت راست محیط ارزیابی بودند.
در یک جدول امتیازات عمومی برای یکی از این بازیها، هیچ مدل پیشرویی نمیتوانست با استفاده از محیط اجرای رسمی از سطح اول عبور کند. اما با محیط پیکربندیشده، GPT-5.6 Sol توانست هر ۶ سطح را با موفقیت حل کند. این نتیجه نشان میدهد که حدود ۷۲٪ از شکاف عملکردی که مردم پیش از این به قابلیتهای ذاتی مدل نسبت میدادند، در واقع توسط پیکربندی محیط اجرا ایجاد شده بود.
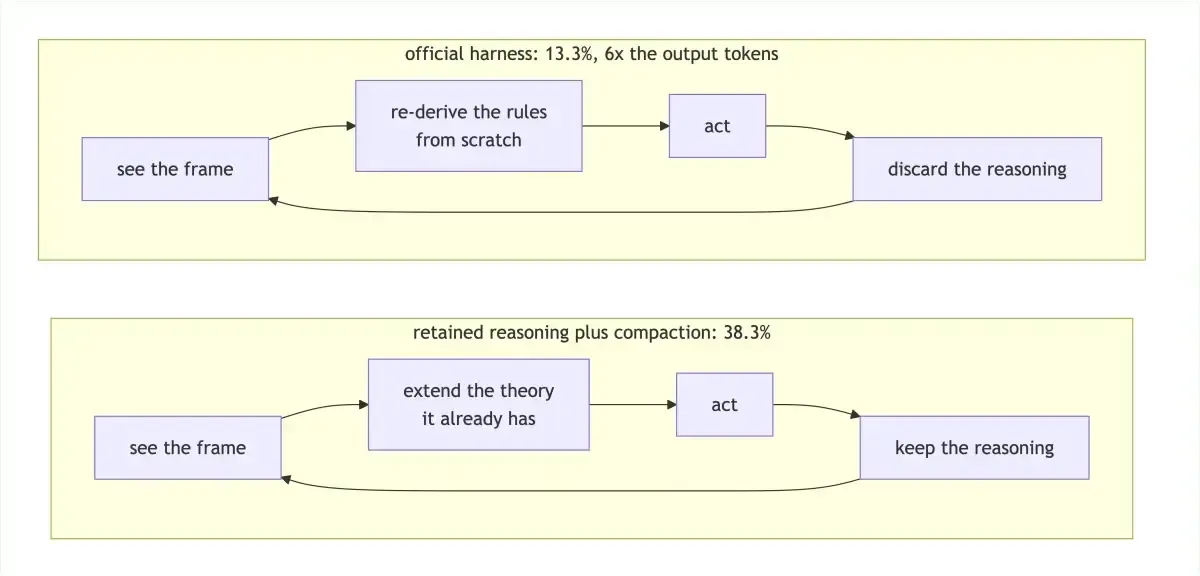
بر اساس مستندات منتشر شده، برای درک مقیاس این تغییر، باید به معیارهای خاص دو حلقه پردازش نگاه کرد. محیط رسمی برای بیطرفی طراحی شده بود، اما در نهایت یک اندازهگیری معیوب تولید کرد:
- محیط رسمی: امتیاز ۱۳.۳٪ (RHAE)، تولید ۶ برابر توکن خروجی در هر بازی، حذف استدلالهای بین نوبتی، و استفاده از برش متنی غلتان (Rolling Truncation) در ۱۷۵,۰۰۰ کاراکتر.
- محیط پیکربندیشده: امتیاز ۳۸.۳٪ (RHAE)، تولید ۱ برابر توکن خروجی در هر بازی، حفظ استدلالهای بین نوبتی، و استفاده از فشردهسازی (Compaction) به جای برش.
- خط پایه انسانی: تخمین OpenAI برای میانگین یک آزمایشکننده انسانی در همین مجموعه وظایف، ۴۸٪ است.
سازوکار شکست: فراموشی پیشرونده
گزارش OpenAI نشان میدهد محیط رسمی ARC-AGI-3 دو اقدام خاص انجام میداد که مدل را فلج میکرد. اینها انتخابهای عجیب یا پیچیدهای نبودند؛ بلکه طبیعیترین راه برای نوشتن یک حلقه عامل (Agent Loop) و رفتار پیشفرض تقریباً هر فریمورک عاملی هستند:
۱. حذف استدلال (Reasoning Discard): محیط اجرا، توکنهای استدلال خصوصی مدل را بعد از هر حرکت پاک میکرد. از آنجایی که توکنهای استدلال گران هستند و توسط API به عنوان یک شیء مجزا بازگردانده میشوند، بسیاری از توسعهدهندگان به دلیل «بهداشت کدنویسی» یا بهینهسازی، آنها را دور میریزند.
۲. برش متنی غلتان (Rolling Truncation): به محض اینکه حجم گفتگو از ۱۷۵,۰۰۰ کاراکتر گذشت، قدیمیترین پیامها حذف میشدند. این سادهترین نسخه مدیریت زمینه (Context Management) است که اکثر توسعهدهندگان در ابتدا مینویسند.
این وضعیت منجر به نوعی «فراموشی پیشرونده» (Anterograde Amnesia) میشد. مدل در هر نوبت صفحه بازی و اقدامات قبلی خود را میدید، اما «چرایی» پشت آنها را فراموش کرده بود. مدل مجبور بود در هر حرکت، کل نظریه خود درباره قوانین بازی را از صفر بازسازی کند. مدل یک حرکت انجام میدهد، نظریهای درباره قوانین میسازد و سپس آن نظریه حذف میشود. در نوبت بعد، مدل دوباره باید استدلال کند. مدل توکنهای خروجی را صرف بازسازی نظریهای میکند که قبلاً داشت، به نتیجهای کمی متفاوت میرسد و بر اساس آن عمل میکند.
هزینه بالای ناکارآمدی
وقتی OpenAI از یک محیط اجرای در سطح تولید (Production-grade) استفاده کرد — همان محیطی که در حال حاضر در ChatGPT و Codex اجرا میشود — نتایج کاملاً وارونه شد. با حفظ استدلال در طول نوبتها و استفاده از استراتژی فشردهسازی به جای برش، مدل دیگر کارهای تکراری انجام نداد:
- جهش امتیاز: کارایی اقدام نسبی انسانی (RHAE) از ۱۳.۳٪ به ۳۸.۳٪ رسید.
- بهینه سازی توکن: مدل برای رسیدن به این امتیاز بالاتر، ۶ برابر توکن خروجی کمتری (۱ برابر در مقابل ۶ برابر) مصرف کرد.
- کاهش شکاف انسانی: فاصله مدل با خط پایه انسانی از ۳۴.۷ واحد به تنها ۹.۷ واحد کاهش یافت.
این ثابت میکند گرانترین پیکربندی، در واقع بدترین عملکرد را داشت. ما این باور را درونی کردهایم که استدلال دقیقتر هزینه توکن بیشتری دارد و کیفیت چیزی است که باید برایش هزینه کرد. اما این آزمایش منطق را معکوس میکند. پیکربندی گرانقیمت به این دلیل گران بود که بدتر عمل میکرد. هر زنجیره استدلال حذفشده باید دوباره تولید میشد و بازتولید یعنی مصرف توکنهای خروجی با قیمت خروجی. در اینجا، اتلاف و شکست، یک اتفاق واحد بودند. این بهینهسازی در مصرف منابع یادآور رویکردهای جدید در کاهش هزینههای توکن است که نشان میدهد مدیریت بهینه توکنها میتواند بهرهوری را به شدت افزایش دهد.
OpenAI این سازوکار را به سادگی توصیف میکند: با حفظ استدلال، مدل زمان کمتری را قبل از هر اقدام صرف فکر کردن میکرد، زیرا دیگر مجبور نبود در هر نوبت بازی را از ابتدا تفسیر کند. تفکر کمتر (به دلیل حذف تکرار) منجر به بازی بهتر شد. این موضوع تنها زمانی متناقض به نظر میرسد که شما «استنتاجهای تکراری و زائد» را به عنوان «تفکر» بشمارید.
بحران در محکهای ارزیابی
این آزمایش یک مشکل سیستماتیک در جدولهای امتیازات AI را افشا میکند. ARC دلیلی برای استفاده از محیط اجرای عمومی داشت: یک محیط ساده باعث میشود نقاط ضعف مدلها بهتر دیده شود و مقایسه بین مدلها را با حذف اثرات تنظیمات تجاری، عادلانهتر کند. اما بیطرفی به معنای نبودِ فرض نیست. محیطی که استدلال را حذف میکند، در واقع موضعی گرفته است که مدلهای آموزشدیده برای تفکر در طول چندین نوبت را جریمه میکند.
وقتی یک محیط اجرا برای تضمین «بیطرفی» بین مدلهای مختلف ثابت نگه داشته میشود، در واقع در حال اندازهگیری میزان انطباق هر مدل با مجموعهای خاص از فرضهاست. اگر محیط اجرا استدلال را حذف کند، ذاتاً مدلهایی را که برای تفکر مستمر آموزش دیدهاند، تضعیف میکند.
OpenAI اعتراف کرد که این اولین بار نیست که از امتیازات پایین عمومی غافلگیر شده و سپس متوجه شده است که اجراکننده ارزیابی از محیطی استفاده کرده که پیامهای استدلال را حذف میکند. چون این اعداد به عنوان «حقیقت» درباره خودِ مدلها نقل میشوند، صنعت نقصهای زیرساختی محیط اجرا را به جای ظرفیت مدل تفسیر کرده است. این اعداد منتشر شده همچنان در گردش هستند و هیچکس برای اصلاح آنها بازنگری نکرده است. این نوسانات در درک واقعی توانمندیها، مشابه تغییرات ناگهانی در نرخ استفاده از مدلهای سری Luna است که گاهی پیش از ثبت رکوردهای جدید، با افتهای غیرمنتظره همراه است.
خطای انتساب (Attribution Error)
هر عدد در بنچمارکهای عاملمحور در واقع اندازهگیری یک سهگانه است: مدل، محیط اجرا (Harness) و پیکربندی. عددی که تولید میشود واقعی و تکرارپذیر است، اما اشتباه در «انتساب» رخ میدهد.
در این مورد، عدد ۱۳.۳٪ یک حقیقت واقعی درباره یک «سیستم» بود، اما به عنوان حقیقتی درباره یک «مدل» خوانده شد. این دو موجودات متفاوتی هستند و تفاوت آنها در اینجا ۲۵ واحد است. این یک شکست در دریافت سیگنال است؛ یک سیگنال واقعی به درستی تولید شد اما برای ادعایی به کار رفت که از آن پشتیبانی نمیکرد. چون بنچمارک به صورت تمیز اجرا شده بود، هیچکس فرضهای زیربنایی محیط اجرا را بررسی نکرد.
مهندسی وضعیت (State)
حفظ وضعیت یک تعهد مهندسی است. حفظ استدلال، در واقع مسئله مالکیت وضعیت است. بین دو نوبت، یک نفر باید کارهای میانی مدل را نگه دارد. اگر محیط اجرا آن را دور بریزد، مدل باید آن را بازتولید کند. اگر محیط آن را نگه دارد، حالا محیط اجرا مالک تکهای از وضعیت است که باید آن را نسخهبندی، سریالسازی، فشرده و بازیابی کند.
تفاوت فشردهسازی و برش متنی نیز همین شکل را دارد. برش متنی رایگان است اما به بدترین شکل ممکن باعث از دست رفتن دادهها میشود، زیرا قدیمیترین بخشهای زمینه را حذف میکند؛ جایی که معمولاً تعریف وظیفه قرار دارد. فشردهسازی هزینه یک فراخوانی اضافی مدل و یک استراتژی خلاصهسازی را دارد، اما تعریف وظیفه را حفظ میکند.
هر دو تنظیم، مواردی هستند که در آن محیط اجرا یک هزینه مهندسی واقعی میپردازد تا از تکرار کار توسط مدل جلوگیری کند. به همین دلیل است که محیطهای اجرای با کارایی بالا — مانند آنچه در Codex و Pi در مقایسه با Claude Code استفاده میشود — بین ۷۹۴ تا ۱,۷۲۹ خط کد را صرف یک حلقه ساده پنج مرحلهای میکنند. این خطوط همان جایی هستند که از تکرار جلوگیری میشود. در بحث حافظه عامل، استدلال حذفشده مانند کشی (Cache) است که نرخ برخورد (Hit Rate) آن صفر است. مدل در هر دسترسی دوباره محاسبه میکند و هر بار هزینه آن را میپردازد. هیچ چیز خراب نیست؛ فقط برای همیشه «سرد» است.
گام بعدی شما: ممیزی استک هوش مصنوعی
توسعهدهندگانی که وظایف عاملمحور چند نوبتی را اجرا میکنند، باید امروز دو حوزه خاص از پیکربندی خود را ممیزی کنند. اینها مشکلات مدل نیستند؛ بلکه مشکلات فایل پیکربندی (Config) هستند:
۱. استمرار استدلال (Reasoning Persistence): آیا فریمورک شما استدلالهای مدل را بین نوبتها حفظ میکند یا آنها را دور میریزد؟ بسیاری از فریمورکها آن را حذف میکنند و تعداد کمی به طور صریح این موضوع را افشا میکنند. اگر در حال اجرای وظیفهای هستید که مدل در آن به مرور زمان درک خود را میسازد، این اولین چیزی است که باید بررسی کنید.
۲. مدیریت زمینه (Context Management): آیا مدیریت زمینه شما فشردهسازی میکند یا برش متنی؟ اگر هنگام رسیدن به حد مجاز، قدیمیترین پیامها را میبرید، شما دقیقاً همان پیکربندی را اجرا میکنید که امتیاز ۱۳.۳٪ گرفت.
گرانترین متغیر در سیستم عامل شما چیزی است که هیچکس آن را بنچمارک نمیکند و همین حالا در فایل پیکربندی شما قرار دارد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو