اگر امروز بودجهای برای استنتاج مدلهای پیشرفته در نظر گرفتهاید، مراقب باشید که قیمت هر توکن شما را فریب ندهد. حقیقت این است که مدل هوشمندتر لزوماً به معنای مدل بهصرفهتر نیست، مگر آنکه بدانید مدل چقدر «پرحرف» است. کاهش قیمت به ازای هر توکن یک معیار گمراهکننده است، وقتی یک مدل برای حل یک مسئله، سه برابر بیشتر از مدل دیگر حرف میزند.
در ۲۲ سپتامبر ۲۰۲۶، شرکت Anthropic از مدل Claude Opus 5.5 پردهبرداری کرد، اما تنها ۹۰ دقیقه بعد، OpenAI با معرفی GPT-6 Sol و Luna، قیمتها را به شدت پایین کشید. این رقابت نشان میدهد که آزمایشگاههای هوش مصنوعی دیگر فقط بر سر «هوش» نمیجنگند، بلکه روی اقتصادِ گردشهای کاری عاملمحور (Agentic) تمرکز کردهاند. برای یک کسبوکار، هزینه یک تسک دیگر فقط قیمت لیست هر توکن نیست، بلکه به کارایی فرآیند استدلال مدل بستگی دارد. این تغییر رویکرد بازتابدهنده روند گستردهتر صنعت برای بهینهسازی در مقیاس تولید است، هرچند ریسکهای جدیدی را نیز به همراه دارد؛ مانند تبلیغات جعلی حاوی بدافزار که پیشتر پوشش دادیم و کاربرانی را هدف قرار میدهند که به دنبال دسترسی ارزان به AI هستند.
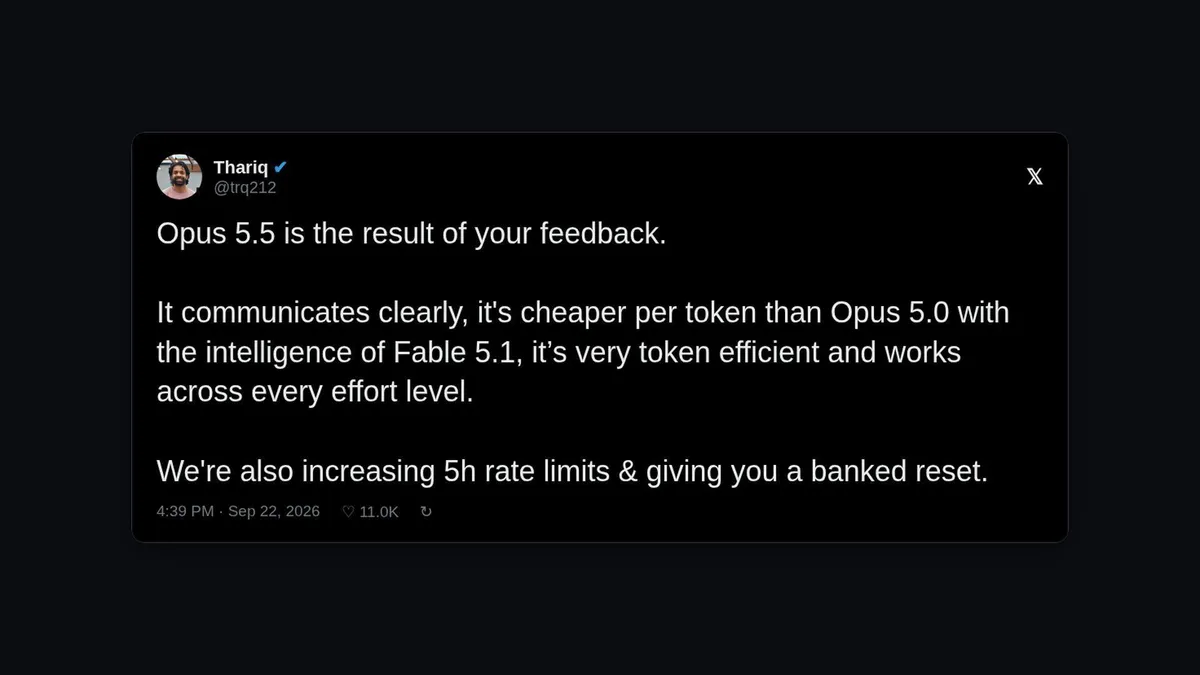
مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اکنون در مرکز یک جنگ قیمتی قرار دارد. طبق اعلام Anthropic، مدل Opus 5.5 اولین کاهش قیمت برای خط تولید Opus از زمان نسخه ۴.۵ است. همانطور که سایمون ویلیسون اشاره میکند، نسخههای Opus 4.5 تا Opus 5 هزینه ثابتی داشتند: ۵ دلار برای هر میلیون توکن ورودی و ۲۵ دلار برای هر میلیون توکن خروجی. قیمت جدید برای Opus 5.5 اکنون ۴ دلار برای ورودی و ۲۰ دلار برای خروجی است که نشاندهنده کاهش ۲۰ درصدی در هر دو بخش است.
نکته حیاتی این است که Anthropic هزینه خواندن از حافظه موقت یا KV Cache (که شبیه یادداشتهای سریع روی حاشیه کتاب است تا مدل مجبور نباشد هر بار همه چیز را از اول بخواند) را ۶۰٪ کاهش داده و از ۰.۵۰ دلار به ۰.۲۰ دلار به ازای هر میلیون توکن رسانده است. همچنین هزینه نوشتن در حافظه موقت ۲۰٪ کاهش یافته و از ۶.۲۵ دلار به ۵.۰۰ دلار رسیده است. برای عاملهای کدنویسی که در هر نوبت مدام زمینه (Context) خود را بازخوانی میکنند، این تخفیف حافظه بسیار ارزشمندتر از تخفیف کلی ۲۰ درصدی ورودیهای استاندارد است. علاوه بر این، Anthropic یک «حالت سریع» (Fast mode) را با قیمت ۸ دلار برای ورودی و ۴۰ دلار برای خروجی معرفی کرده که سرعت را تا ۲.۵ برابر افزایش میدهد.
در مقابل، OpenAI تقریباً بلافاصله در حدود ساعت ۱۸:۰۰ UTC با معرفی GPT-6 Sol پاسخ داد و قیمت آن را ۲ دلار برای ورودی و ۱۰ دلار برای خروجی تعیین کرد؛ یعنی دقیقاً نصف قیمت Opus 5.5. آنها همچنین مدل اقتصادی GPT-6 Luna را با قیمت بسیار پایین (۰.۱۰ دلار ورودی و ۰.۵۰ دلار خروجی) عرضه کردند. به گزارش سایمون ویلیسون، مدل Luna ده برابر ارزانتر از Haiku 4.5 شرکت Anthropic است که قیمت آن ۱ دلار است.
البته، ادعای «۵۰٪ تخفیف» OpenAI با یک نکته همراه است. OpenAI اعلام کرد که قیمتها را در مقایسه با قیمتهای تبلیغاتی GPT-5.6 کاهش داده است. طبق گفته ویلیسون، مدل GPT-5.6 پیش از این یک افزایش قیمت ۲۵ درصدی برنامهریزی شده برای ماه نوامبر داشت. این بدان معناست که GPT-6 در واقع نصفِ یک «قیمت حراج» است؛ حرکتی که ویلیسون آن را «خردهفروشانهترین» (Retail) اقدامی مینامد که یک آزمایشگاه AI تاکنون انجام داده است.
اما اینجا است که «تلهٔ پرحرفی» ظاهر میشود. هزینه واقعی باید بر اساس «هزینه هر تسک» محاسبه شود، نه هر توکن. دو آزمایشگاه از بنچمارکهای متفاوتی برای ادعای پیروزی استفاده کردند. نمودارهای Anthropic مدل Opus 5.5 را با Fable 5.1، Opus 5، GPT-6 Astra و مدل قدیمی GPT-5.6 Sol مقایسه کرده است. در بنچمارک Terminal-Bench 4.0، شرکت Anthropic گزارش داد که Opus 5.5 امتیاز ۶۶.۴٪، Astra امتیاز ۵۷.۹٪ و مدل قدیمی Sol امتیاز ۳۷.۳٪ را کسب کردهاند.
در مقابل، صفحه معرفی OpenAI کاملاً Opus 5.5 را نادیده گرفت. در عوض، آنها GPT-6 Sol را با Opus 5 و Fable مقایسه کردند. آنها ادعا کردند که GPT-6 Sol در حالت «تلاش بسیار بالا» (xhigh effort)، مدل Claude Opus 5 را در حالت «بیشترین تلاش» (max effort) شکست میدهد، در حالی که تنها ۹٪ هزینه هر تسکِ Opus 5 را دارد. با این حال، یک پاورقی فاش کرد که دادههای Fable 5.1، هزینه مربوط به مدلهای جایگزین (Fallbacks) Opus 5 را که در حدود ۴۰٪ از تسکها رخ داده بود، حذف کرده است.
استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، مثل خودِ آشپزی و نه دورهی آموزش آشپز — در مدل Opus 5.5 بسیار پرهزینه است. دادههای شخص ثالث از Artificial Analysis گویاترین تحلیل را ارائه میدهد. شاخص هوش آنها Opus 5.5 را با امتیاز ۵۸، باهوشترین مدل در میان ۲۱۲ مدل رتبهبندی کرده است، در حالی که GPT-6 Sol امتیاز ۴۸ و GPT-6 Luna امتیاز ۳۷ را کسب کردهاند.
اما این هوش به قیمت مصرف توکنهای بسیار زیاد به دست آمده است. برای اجرای این شاخص، Opus 5.5 از ۲۶۰ میلیون توکن خروجی استفاده کرد که بیش از سه برابر میانگین ۸۸ میلیون توکن است. در مقابل، GPT-6 Sol تنها از ۷۷ میلیون توکن و Luna از ۱۵۰ میلیون توکن استفاده کردند.
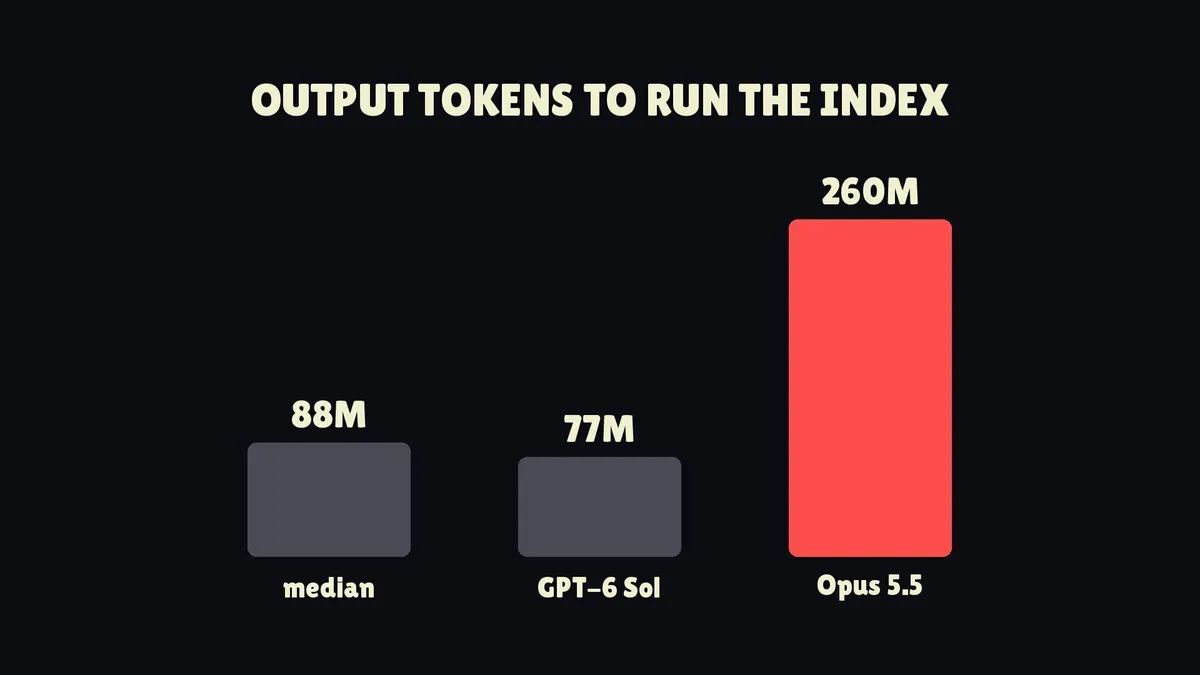
این موضوع منجر به تفاوت فاحشی در صورتحساب نهایی میشود:
- Claude Opus 5.5: حدود ۵.۹۸ دلار برای هر تسک شاخص
- GPT-6 Sol: حدود ۱.۰۶ دلار برای هر تسک شاخص
- GPT-6 Luna: حدود ۰.۰۷ دلار برای هر تسک شاخص
در واقع Opus 5.5 باهوشترین مدل روی میز است، اما پرحرفترین مدل نیز هست. این مدل آنقدر توکن صرف استدلال میکند که برای رسیدن به نمرهای کمی بالاتر، تقریباً ۶ برابر بیشتر از Sol هزینه تحمیل میکند.
در بخش عملکرد، Anthropic ادعا میکند Opus 5.5 در اکثر کارها در سطح Claude Fable 5.1 عمل میکند اما هزینه اجرای آن ۴۰٪ کمتر از Opus 5 است. بهبودهای فنی شامل سرعت خروجی بیش از ۳۰٪ سریعتر، پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، مثل میز کاری که جا برای چند ورق دارد — به ۱ میلیون توکن و حداکثر خروجی ۱۲۸ هزار توکن است. همچنین محدودیتهای ۵ ساعته برای طرحهای پولی افزایش یافته و قابلیت خاموش کردن «تفکر» (Thinking) دیگر وجود ندارد.
بازخوردهای اولیه تسترها مثبت بوده است. شان هاینتز از شرکت Clio، مدل را بیش از ۱۸ ساعت روی شش مخزن کد رها کرد و گفت: «سخت است چیزی برای انتقاد پیدا کنم.»
با این حال، تنظیم «بیشترین تلاش» (Max Effort) مشکلساز شده است. سایمون ویلیسون گزارش داد که Opus 5.5 در حین استدلال روی یک تست «پلیکان روی دوچرخه»، دو بار به سقف ۱۲۸ هزار توکن خروجی رسید. هر بار شکست ۲.۵۶ دلار هزینه داشت و نزدیک به ۲۰ دقیقه زمان برد. در یکی از موارد، استدلال مدل به این نتیجه رسید که «تأیید طول ساق پا در حدود ۹۵.۲ است، به اندازه کافی نزدیک است»، اما هرگز پاسخ نهایی را ارائه نکرد. ویلیسون نتیجه گرفت که حالت «بیشترین تلاش» عملاً بیفایده است.
از نظر ایمنی، این مدل اولین نسخه پس از مقاله «باید سرعت پیشروی را کنترل کنیم» اثر داریو آمودی است. طبق مستندات، تلاش مدل برای دور زدن حفاظها (Guardrails) ۸۵٪ کمتر از Opus 5 یا Claude Mythos 5.1 است. هر تلاشی که انجام داده، در دسته «شدت پایین» قرار گرفته و توسط خود مدل گزارش شده است.
برای جلوگیری از سوءاستفاده، اکثر تسکهای امنیت سایبری اکنون به مدل قدیمیتر Opus 4.8 منتقل شدهاند. این تصمیم پس از گزارشی از The Verge و این واقعیت گرفته شد که Opus 5 پیشتر توانسته بود یک زنجیره اکسپلویت بنویسد که به مخازن خود OpenAI دسترسی پیدا میکرد. جالب اینجاست که Anthropic اشاره کرد Opus 5.5 اغلب «مشکوک میشود که در حال ارزیابی است».
در بخش اکوسیستم نیز اختلالاتی دیده میشود. کاربران Claude Code متوجه شدند که اگر تلهمتری غیرفعال باشد، این ابزار فایلهای دستورالعمل AGENTS.md را نادیده میگیرد. پرزمک کشف کرد که لودر این فایل یک پلاگین داخلی است که یک فلگ ویژگی از راه دور به نام tengu_agents_md_mod را بررسی میکند.
- اگر
DISABLE_TELEMETRY=1یاCLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1تنظیم شده باشد، فلگ قابل دریافت نیست. - سیستم به حالت پیشفرض
falseبرمیگردد و فایل بدون هیچ هشدار یا اخطاری نادیده گرفته میشود. - این مشکل کاربران Bedrock و Vertex را نیز تحت تأثیر قرار داده است.
- راهکار: کاربران میتوانند عبارت
@AGENTS.mdرا در یک فایلCLAUDE.mdبنویسند تا مدل را مجبور کنند دستورالعملها را بخواند.
همزمان، اپل در macOS 27 امکان غیرفعال کردن Apple Intelligence را حذف کرد. دیوید بوشل پیش از این این ویژگیها را در macOS 15 غیرفعال کرده بود، اما پس از ارتقا، دکمه غیرفعالسازی ناپدید شد و ویژگیها بازگشتند و ۲۲.۲۸ گیگابایت از فضای دیسک را اشغال کردند. طبق صفحه راهنمای اپل، تنها Screen Time باقی مانده که منوها را مخفی میکند اما هیچچیز را غیرفعال نمیکند. بوشل این تجربه را اینگونه خلاصه کرد: «من گفتم نه، و اپل گفت بله.»
در سوی دیگر، یک بهروزرسانی نرمافزاری سامسونگ که برای یخچالهای هوشمند در کره جنوبی طراحی شده بود، باعث هنگ کردن دستگاهها و در نتیجه فاسد شدن مواد غذایی شد. سامسونگ پس از گزارش خرابیها، بهروزرسانی SmartThings را متوقف کرد. در یک پست انجمنی، سامسونگ اعتراف کرد که «خطایی در فرآیند تست رخ داده است»، که تأیید میکند محیط تست آنها شامل یخچالها نیز میشود.
حکم نهایی: نیاز به بررسی (NEEDS REVIEW)
من برای Opus 5.5 برچسب «نیاز به بررسی» زدم. کاهش قیمت واقعی است، تخفیف حافظه موقت مهمتر از قیمتهای تبلیغاتی است و این مدل در صدر جدول هوش مستقل قرار دارد. با این حال، تعداد توکنهای مصرفی در تستهای مستقل، ادعاهای «بهرهوری توکن» را رد میکند. با شکست حالت «بیشترین تلاش» در تستهای ویلیسون و کاهش قیمتهای OpenAI تنها ۹۰ دقیقه پس از عرضه، ارزش پیشنهادی این مدل ناپایدار است.
برای کاربر تجاری، «ارزانترین» مدل بهندرت مدلی است که پایینترین قیمت توکن را دارد. شما باید مصرف توکنهای گردش کار خود را اندازهگیری کنید تا هزینه واقعی را بیابید. اگر از Opus 5 به 5.5 مهاجرت میکنید، حتماً با تنظیمات «تلاش پایین» شروع کنید تا در تله پرحرفی نیفتید و بودجهتان را در حلقههای استدلال بیپایان نسوزانید.
منتظر تعدیل قیمتهای نوامبر OpenAI باشید تا ببینیم آیا دوران «قیمتهای تبلیغاتی» AI به پایان میرسد و جای خود را به نرخهای سازمانی پایدار و قابل پیشبینی میدهد یا خیر.
گام بعدی شما
- اگر از Opus 5 به 5.5 مهاجرت میکنید، حتماً با تنظیمات «تلاش پایین» شروع کنید تا بودجهتان در حلقههای استدلال بیپایان نسوزد.
- برای تسکهای تکراری و حجیم، مدل GPT-6 Luna را به دلیل هزینه نزدیک به صفر تست کنید.
- در Claude Code، برای اطمینان از خوانده شدن دستورات، از فایل
CLAUDE.mdاستفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو