
تصور کنید هر سه صفحهای که امروز در وب میخوانید، احتمالاً توسط انسانی نوشته نشده است. این دیگر یک پیشبینی نیست، بلکه واقعیت آماری وب مدرن است.
طبق گزارش مرکز پژوهشهای پیو (Pew Research Center) که در ۲۴ اوت ۲۰۲۶ منتشر شد، بیش از یکسوم صفحات وب انگلیسیزبان که پس از عرضه ChatGPT منتشر شدهاند، نشانههای واضحی از نویسندگی ماشین دارند. این تحلیل بر روی نزدیک به نیم میلیون صفحه با استفاده از ابزار تشخیص Open Pangram انجام شده است. این یافتهها در راستای یافتههای اولیه پژوهش پیو است که برای نخستین بار به نفوذ گسترده محتوای سنتتیک در وب اشاره کرد.
این حجم عظیم از محتوای سنتتیک در حالی رخ میدهد که وب در حال تغییر بنیادین در نحوه تولید اطلاعات است. همانطور که در تحلیلهای قبلی ما دربارهی اقتصاد مدلهای زبانی اشاره کردیم، تمرکز صنعت از کاهش هزینههای استنتاج — مثل زمانی که OpenAI هزینه مدل GPT-5.6 Sol را به ۴ دلار برای هر میلیون توکن ورودی رساند — به حجم خروجیهایی تغییر کرده که در حال اشباع کردن اینترنت عمومی هستند. این تغییر در توزیع محتوا با کاهش سهم ترافیک ارجاعی ChatGPT همسو است که نشان میدهد کاربران در حال گذار از ابزارهای متمرکز به محیطهای پراکندهتر وب هستند.
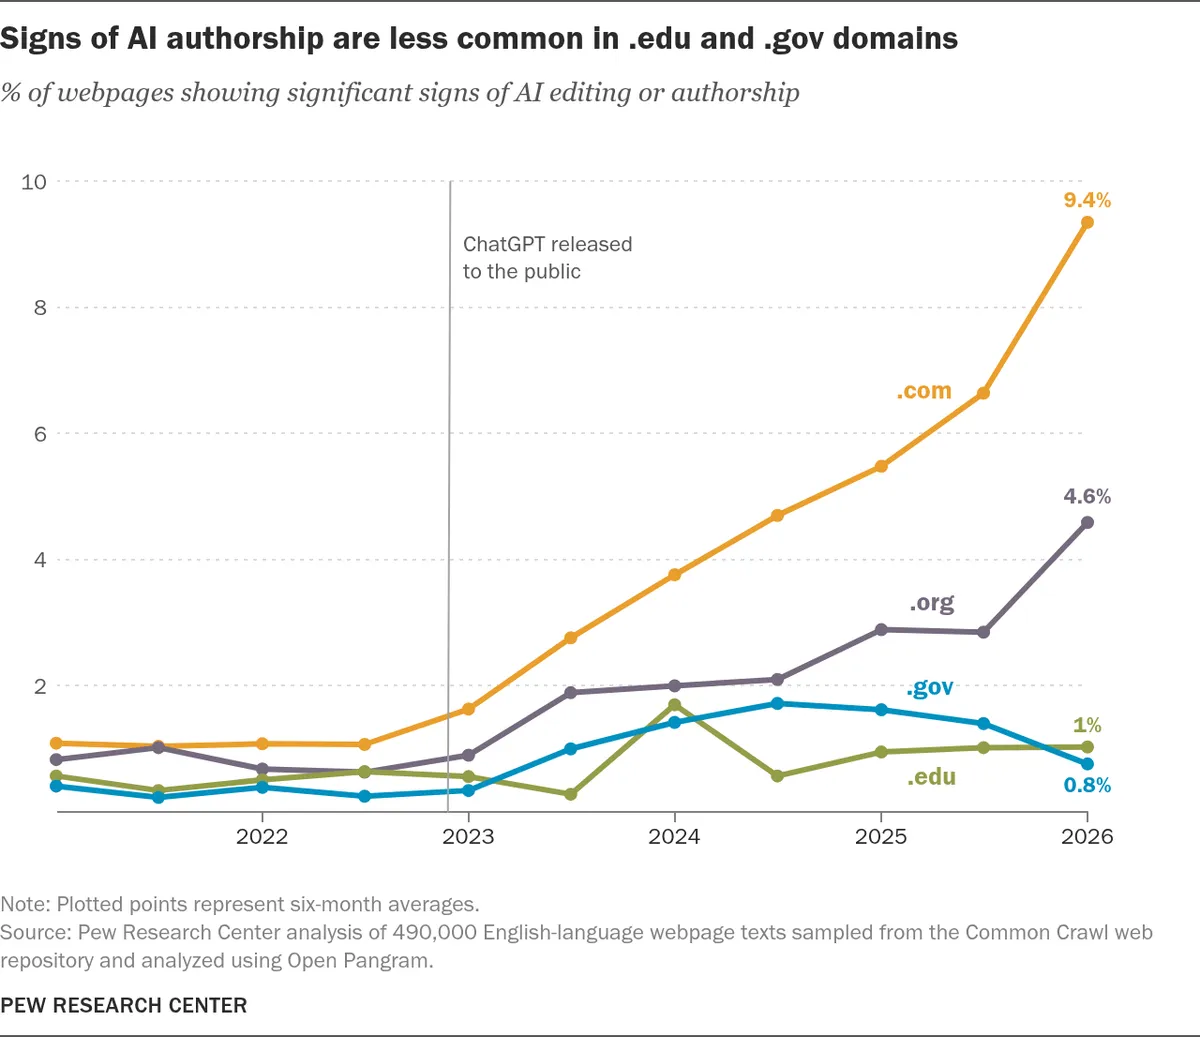
هوش مصنوعی زاینده (Generative AI) — شبیه نویسندهای است که میلیاردها متن را خوانده و حالا با ترکیب احتمالی کلمات، متونی شبیه به انسان میسازد — اکنون در دامنههای مختلف نفوذ متفاوتی دارد:
- دامنههای .com: حدود ۱۰٪ صفحات نشانههای AI دارند.
- دامنههای .org: ۴.۶٪ صفحات تحت تأثیر AI هستند.
- دامنههای .edu و .gov: تنها حدود ۱٪ صفحات از این ابزارها استفاده کردهاند.
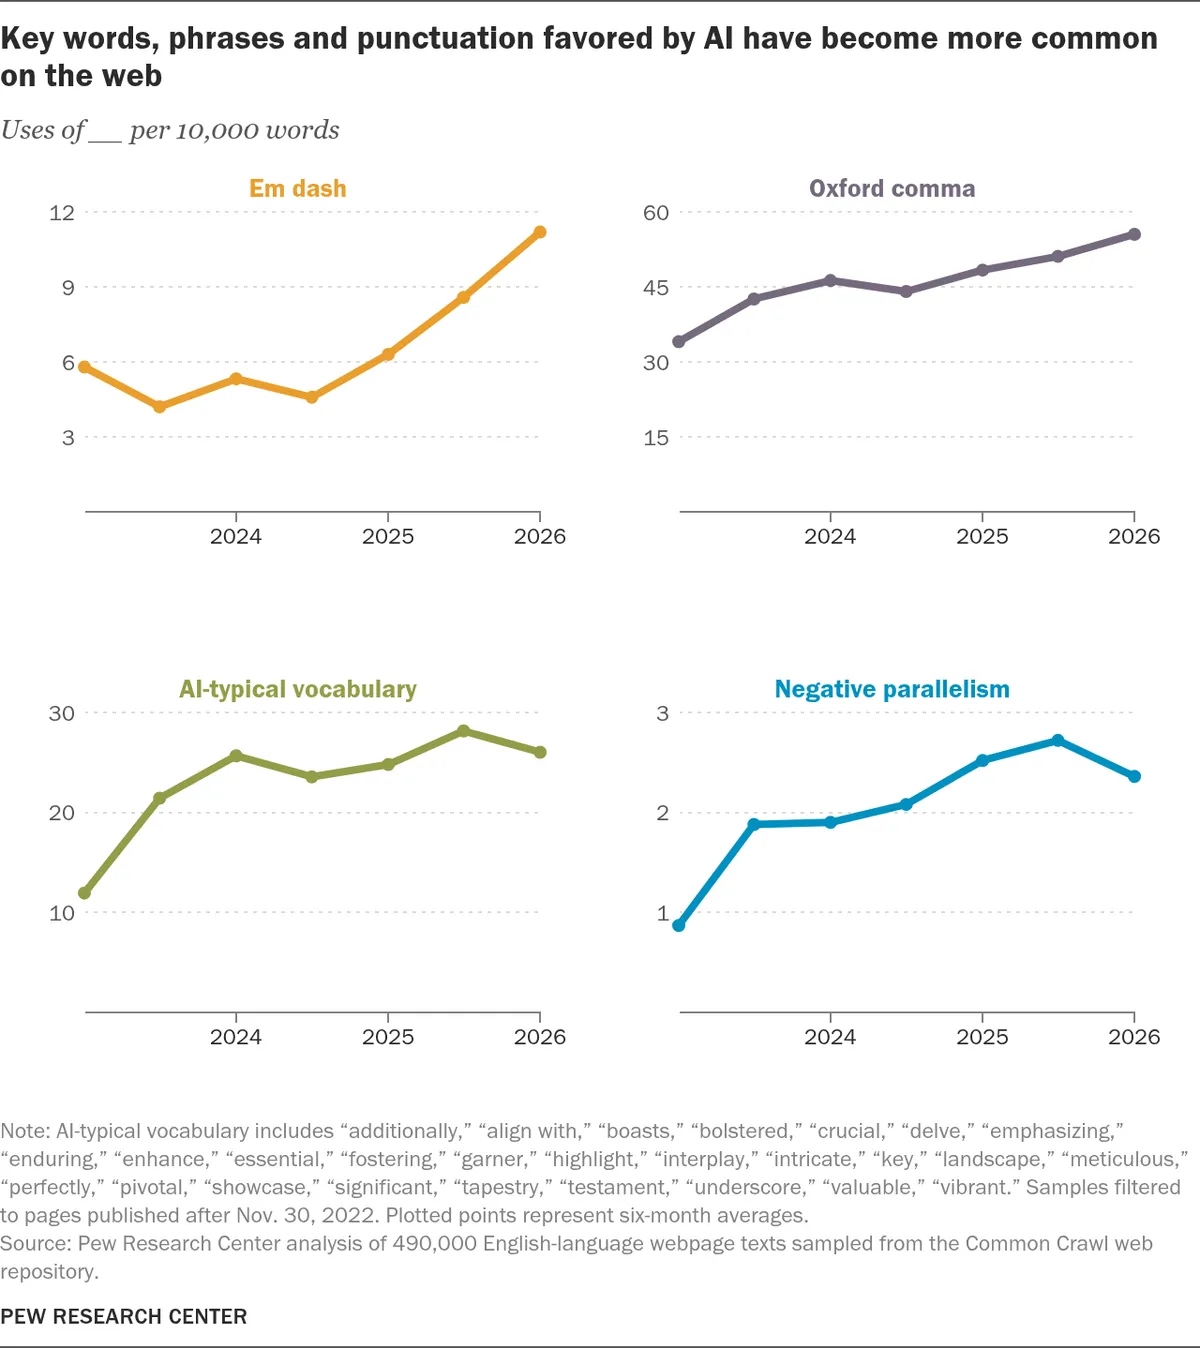
به نقل از این گزارش، «اثر انگشتهای» زبانی خاصی شناسایی شدهاند که از سال ۲۰۲۳ جهش کردهاند. استفاده از ویرگول اکسفورد ۶۳٪ افزایش یافته و خط تیره (em dash) اکنون دو برابر بیشتر دیده میشود. کلماتی مثل "delve"، "tapestry" و "pivotal" که محبوب مدلهای زبانی هستند، بیش از دو برابر تکرار شدهاند.
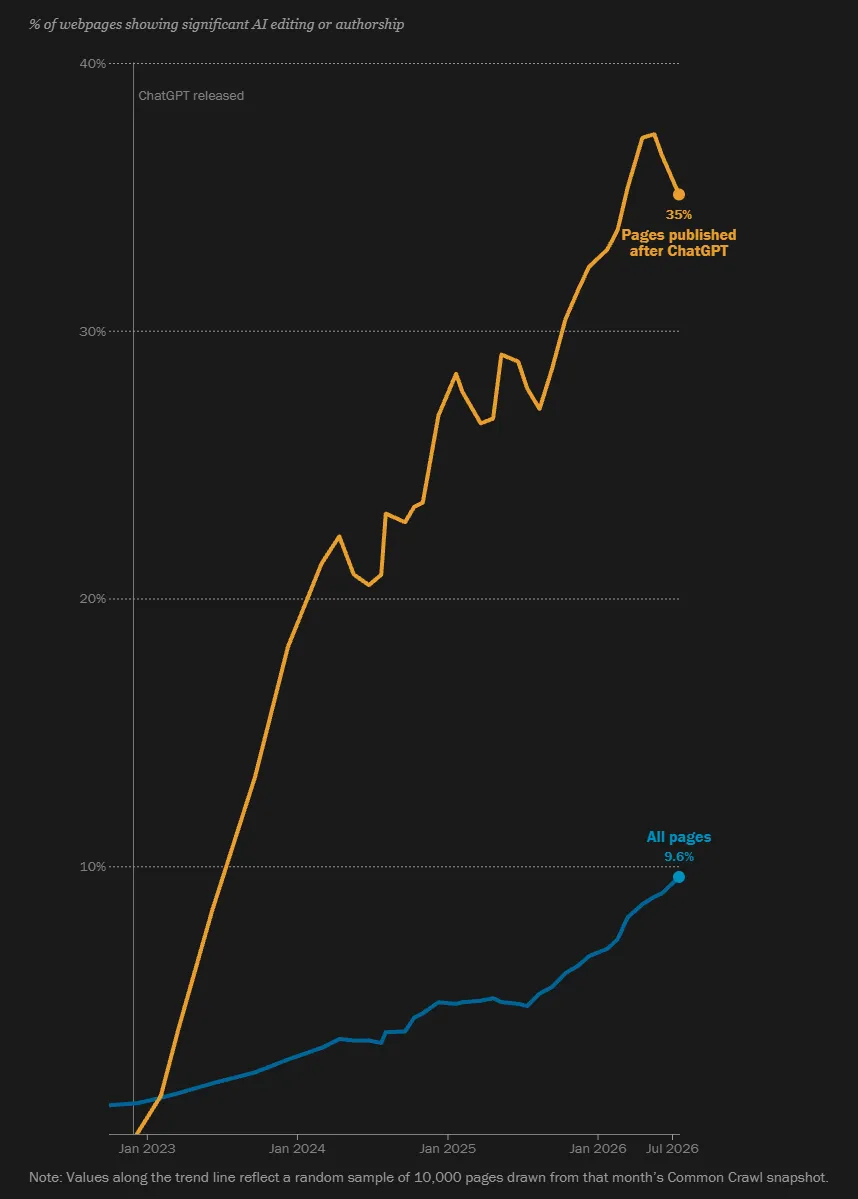
بر اساس بررسی منابع متعدد، این روند توسط پژوهشهای دیگر نیز تأیید شده است. مطالعهای در آوریل ۲۰۲۶ توسط امپریال کالج لندن، اینترنت آرکایو و دانشگاه استنفورد نشان داد که ۳۵٪ از وبسایتهای جدید، بهطور کامل یا جزئی توسط AI تولید شدهاند. این پژوهشگران متوجه شباهت معنایی ۳۳ درصدی بیشتر در متون AI و لحنی بهطور کلی مثبتتر شدند.
برای صاحبان کسبوکار و بازاریابان، این یعنی «ظاهرِ هوش مصنوعی» در حال تبدیل شدن به یک کالای ارزان و تکراری است. وقتی یکسوم وب از ساختارهای مشابه استفاده میکند، سرعت تولید محتوا دیگر یک مزیت رقابتی نیست، بلکه باعث از بین رفتن تمایز برند میشود.
با این حال، تعریف «متن AI» همچنان مبهم است. تفاوت زیادی میان یک صفحه کاملاً خودکار و پیشنویس انسانی که توسط مدل صیقل داده شده، وجود دارد. ابزارهایی مثل Open Pangram تنها تخمینهای تقریبی میدهند و نرخ خطای آنها بالاست. این چالشها ما را به بررسی دقت ابزارهای تشخیص AI در برابر پیچیدگیهای زبانی نویسندگان انسانی سوق میدهد.
در حالی که استیگما یا همان برچسب منفی ابزارهای AI در محیطهای کاری باقی مانده، صنعت برای یافتن یک نقطه تعادل تلاش میکند. بحثهای اخیر درباره برنامهی Anthropic برای نشانگذاری (Watermarking) خروجیهای مدل Claude، نشاندهنده این قطببندی است.
گام بعدی شما
- در تولید محتوا، از ساختارهای تکراری مدلها (مثل کلمات کلیدی ذکر شده) فاصله بگیرید تا توسط الگوریتمهای تشخیص محتوا جریمه نشوید.
- برای تأیید اصالت منابع، به جای ابزارهای تشخیص الگو، به دنبال استانداردهای جدید اثبات منشأ محتوا باشید.
- بررسی کنید که آیا محتوای تولید شده توسط AI در سایت شما، تمایز برندتان را از رقبایی که از ابزارهای مشابه استفاده میکنند، از بین برده است یا خیر.
اما داستان سختافزاری این تحول و فشار بر مراکز داده حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو