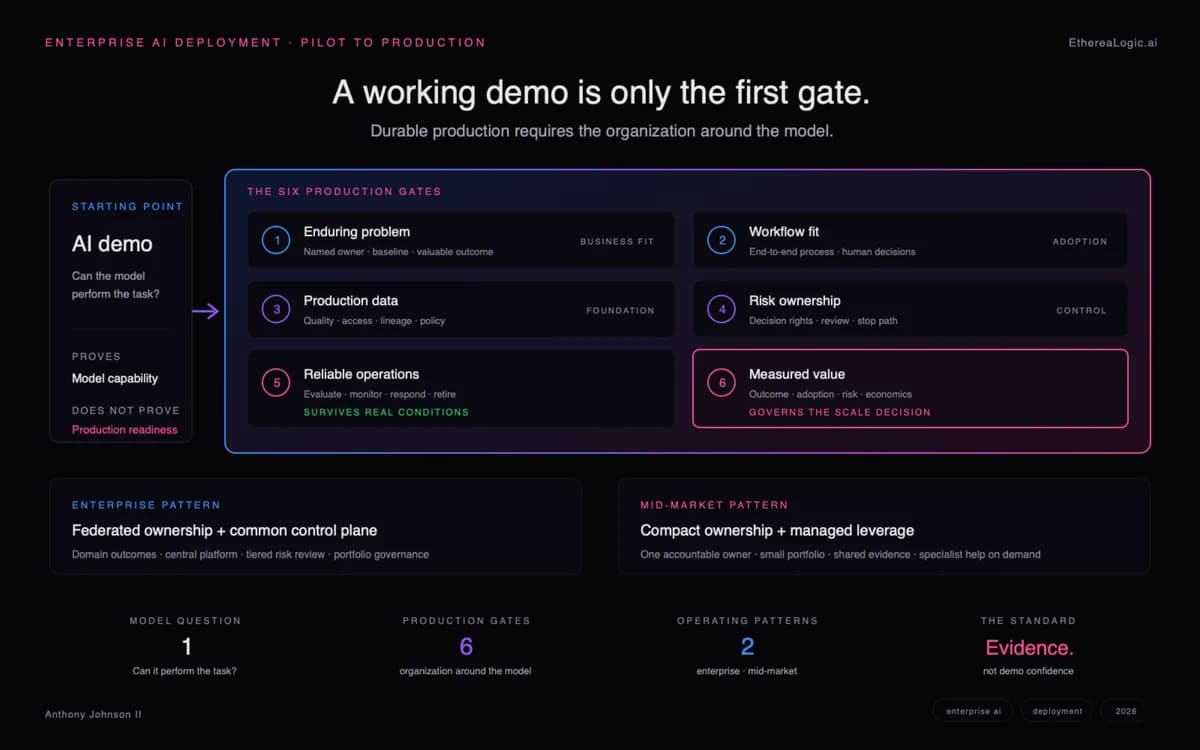
اگر تصور میکنید مشکل استقرار هوش مصنوعی در سازمان شما مربوط به قدرت استدلال مدلهاست، در اشتباهید. طبق گزارش پژوهشی مؤسسه RAND Corporation، بیش از ۸۰٪ پروژههای هوش مصنوعی سازمانی شکست میخورند که این رقم تقریباً دو برابر نرخ شکست در پروژههای سنتی فناوری اطلاعات است. این آمار تکاندهنده سیگنالی است مبنی بر اینکه سد اصلی در مسیر بهرهوری، هوشِ مدل نیست، بلکه شکست ساختاری سازمان در اطراف آن است. این موضوع یادآور تحلیلهای پیشین ماست که در آن بررسی کردیم چگونه رکود در فرآیندهای کسبوکار منجر به شکست ۹۰ درصدی پروژههای هوش مصنوعی سازمانی شده است.
این مقاله، اولین بخش از سری جدید EthereaLogic در مورد استقرار هوش مصنوعی در سطح بازار متوسط (Mid-Market) و سازمانی است که هدف آن ترسیم «شکاف استقرار» و حالتهای شکستی است که این شکاف را پر میکنند. در واقع، اکثر شرکتها استقرار هوش مصنوعی را یک مسئلهٔ فنی میبینند، اما واقعیت این است که با یک چالش عملیاتی روبرو هستند. در حالی که یک دمو (نمونه اولیه) را میتوان در یک آخر هفته ساخت، انتقال آن دمو به یک سیستم تولیدی تحت نظارت و حکومتی، نیازمند عبور از ۶ لایه «بافت زخمی» سازمانی است: شناسایی مسائل ماندگار، تطبیق با گردش کار، دادههای تولیدی، مالکیت ریسک، عملیات قابلاتکا و ارزشسنجی دقیق. این ۶ دروازه مربوط به سازمانِ پیرامونِ مدل هستند، نه خودِ مدل. یک دموی فعال صرفاً نقطه شروع است و تنها گامی است که عمدتاً به خودِ مدل مربوط میشود.
با تکیه بر بحثهای پیشین ما دربارهی اعتماد به دادهها و ضرورت اعتبارسنجی ورودیهای هوش مصنوعی، این گذار به سمت محیط تولیدی، یک «شکاف مواجهه» (Exposure Gap) خطرناک را آشکار میکند. شرکتها ابزارهای هوش مصنوعی را سریعتر از نردههای ایمنی (Guardrails) — که شبیه به حفاظهای کنار جاده برای جلوگیری از خروج خودرو از مسیر هستند — مستقر میکنند و بدین ترتیب در را به روی ریسکهای سیستماتیک باز میگذارند. ریسکهایی که استقرار هوش مصنوعی در یک سازمان بزرگ را نابود میکنند، اغلب در همان لایههای بافت زخمی نهفتهاند؛ با این حال، بسیاری از سازمانها هیچ نقشهای از این لایهها ندارند، هیچ مسئولی برای آنها تعیین نکردهاند و هیچ ردیف بودجهای در برنامههای مالیشان وجود ندارد که به نام آنها باشد.
کالبدشکافی شکست در استقرار
بر اساس بررسی منابع و پژوهشهای متعدد از جمله RAND، S&P Global Market Intelligence و MIT NANDA، پنج الگوی شکست ساختاری به طور مکرر تکرار میشوند. این موارد در واقع همان ۶ دروازه هستند که از درون دیده میشوند و نیازمند یک تعریف «ابطالپذیر» (Falsifiable) از موفقیت هستند که بازه زمانی و عملیاتی آن از دروازه «مسئله ماندگار» تا دروازه «ارزشسنجی» را در بر گیرد. اگرچه این مطالعات جمعیتها و نتایج متفاوتی را اندازهگیری میکنند و یک نرخ شکست جهانی و واحد برای هوش مصنوعی تعیین نمیکنند، اما همگی بر روی یک تز مشترک متمرکز هستند: موانع، ساختاری هستند.
- فقدان تعریف ابطالپذیر از موفقیت: مؤسسه RAND دریافت که ریشه اصلی و رایجترین علت شکست، درک نادرست یا انتقال نادرست مسئلهٔ تجاری است؛ از جمله مواردی که رهبران سازمان به دنبال معیارهای غلط میروند. بسیاری از پروژههای آزمایشی (Pilots) بهجای اینکه برای رسیدن به یک عدد یا هدف مشخص طراحی شوند، صرفاً برای «کاوش» در یک قابلیت تعریف میشوند. بدون یک «معیار توقف» (Kill Criterion) شفاف، پروژهها به «ابتکارات زامبی» تبدیل میشوند که ظرفیتهای یکپارچهسازی و پلتفرم را میبلعند اما هرگز با یک تصمیم قطعی برای تولید (Production) مواجه نمیشوند. راه حل این مشکل، نوشتن دقیقِ معیار (Metric)، آستانه پذیرش (Threshold)، مالک اندازهگیری و تاریخ تصمیمگیری است، پیش از آنکه پروژه آزمایشی آغاز شود. این انضباط دقیقاً مشابه انضباط «معیارهای پذیرش» است که توسعهمحور بر یک عامل کدنویسی تحمیل میکند، اما در اینجا یک سطح بالاتر اعمال میشود. اگر تعریف موفقیت نتواند به صورت مکتوب درآید، پروژه آزمایشی آماده شروع نیست؛ بلکه صرفاً یک «علاقه پژوهشی» است که لباس پروژه به تن کرده است.
- به تأخیر انداختن یکپارچهسازی: یک یادداشت پژوهشی مقدماتی از MIT NANDA (اوت ۲۰۲۵) که بر روی سیستمهای وظیفهمحور (Task-specific) گزارش داده بود، اشاره کرد که تنها ۵٪ از پیادهسازیها توانستند به آستانهای از بهرهوری چشمگیر و پایدار یا تأثیر ملموس بر صورت سود و زیان (P&L) برسند. ابزارها اغلب متوقف شدند زیرا با گردش کارهای عملیاتی یکپارچه نشدند یا با بازخوردهای کاربران سازگار نبودند. پروژههای آزمایشی استاندارد معمولاً روی دادههای استخراجشده در محیطهای ایزوله (Sandboxes) اجرا میشوند؛ شرایطی که محیط واقعی تولید هرگز بازتولید نمیکند. پروژهای که ثابت میکند مدل روی دادههای پاک و استخراجشده کار میکند، در واقع هیچ چیز دربارهی «استقرار» ثابت نکرده است. طبق گزارش McKinsey، بازطراحی بنیادین گردشهای کار (Workflows) بیشترین همبستگی را با تأثیر گزارششده بر سود عملیاتی (EBIT) از هوش مصنوعی زاینده داشته است، با این حال تنها ۲۱٪ از سازمانها این کار را انجام دادهاند. اکثر استقرارها، موتور جدیدی را در یک مدل عملیاتی قدیمی نصب میکنند و سپس موتور را سرزنش میکنند.
- خلاء «میانهٔ کسلکننده»: میان علم دادهای که مدل را میسازد و واحد تجاری که خواهان نتیجه است، کارهای غیرجذاب و خستهکنندهای قرار دارد: تخصیص دسترسیها، مانیتورینگ، مسیریابی حوادث (Incident Routing)، انضباط در نسخهبندی مدل و پرامپت، و ردیابی هزینهها. در نرمافزارهای سنتی، این بخش تحت عنوان «مهندسی پلتفرم» یا SRE (مهندسی قابلیت اطمینان سایت) شناخته میشود. در هوش مصنوعی، این بخش اغلب به اشتباه بهعنوان «نوآوری» تلقی میشود تا «تحویل نرمافزار». وقتی این کارها نامگذاری و تعریف نشوند، ناپدید نمیشوند؛ بلکه بر دوش هر کسی که در لحظه شکست سیستم نزدیکتر است میافتند و منجر به وضعیت «عامل شکست تکنفره» (Bus Factor of One) میشوند (یعنی اگر آن یک نفر نباشد، کل سیستم فرو میپاشد).
- حاکمیت بهعنوان یک فکر بعدی: وقتی حاکمیت (Governance) بهعنوان یک مرحلهی بعدی در نظر گرفته شود، به محض ورود افسران تطبیق (Compliance Officers) به اتاق جلسات، مذاکرات تبدیل دمو به تولید از نقطه صفر شروع میشود. نظرسنجی ۲۰۲۵ McKinsey اشاره کرد که ۲۸٪ از پاسخدهندگان نظارت مدیرعامل بر حاکمیت هوش مصنوعی داشتند و ۱۷٪ نظارت هیئتمدیره را تجربه کردند. نظارت مدیرعامل یکی از اقداماتی بود که با تأثیرات قویتر بر سود خالص مرتبط بود. پروژهای آزمایشی که تحت کنترلهای دسترسی واقعی و ردپاهای بازرسی (Audit Trails) اجرا شود، شواهدی تولید میکند که یک افسر ریسک میتواند واقعاً آن را بپذیرد. سازمانهایی با نرخ شکست پایینتر، تمایل داشتند از اولویتبندیهای جامعتری استفاده کنند و هنگام انتخاب پروژهها، انطباق، ریسک و در دسترس بودن دادهها را لحاظ کنند.
- بنیانهای دادهای تأییدنشده: ضعف در بنیانهای دادهای در هر نظرسنجی مربوط به شکستها تکرار میشود. سازمانها مکرراً آنچه را که هوش مصنوعی «تولید» میکند اعتبارسنجی میکنند اما آنچه را که مدل «مصرف» میکند نادیده میگیرند. یک استقرار، هر نقص اندازهگیرینشده در دادههای زیرین خود را به ارث میبرد. این نقصها در مقیاس تولید ظاهر میشوند و لباس «مدل غیرقابلاعتماد است» را به تن میکنند، در حالی که در واقعیت، مسیر داده هرگز تحت حاکمیت نبوده است.
تفاوت چالشهای شرکتهای بزرگ و بازار متوسط
«استقرار هوش مصنوعی سازمانی» اغلب به عنوان یک مسئله واحد مورد بحث قرار میگیرد، اما در واقع دو مسئله متفاوت است. توصیههایی برای یک مورد، میتواند فعالانه به مورد دیگر آسیب بزند.
مسئله پرتفوی در Fortune 500
برای سازمانهای بزرگ، چالش یک مسئله پرتفوی (Portfolio) است. یک سازمان بزرگ میتواند از عهده ۲۰ پروژه آزمایشی برآید، اما حالت شکست آنها، اجرای این پروژهها بدون تعاریف موفقیت به اندازه کافی «تیز» است که بتوان بر اساس آنها پروژه را شکست داد. S&P Global Market Intelligence دریافت که ۴۲٪ از شرکتهای مورد بررسی، اکثر ابتکارات هوش مصنوعی خود را پیش از رسیدن به مرحله تولید در سال ۲۰۲۵ رها کردند (در حالی که این رقم سال قبل ۱۷٪ بود). بهطور متوسط، ۴۶٪ از پروژهها بین مرحله اثبات مفهوم (PoC) و پذیرش گسترده کنار گذاشته شدند. این دادهها محیطی را منعکس میکنند که در آن سازمانها ممکن است اثباتهای مفهوم بیشتری را پشت سر بگذارند، هرچند نامعلوم است که این موضوع به دلیل انضباط بهتر در مدیریت پرتفو است یا اجرای ضعیفتر. سازمانهای بزرگ باید بر کنترل «کشآمد پرتفو» تمرکز کنند.
مسئله ظرفیت در بازار متوسط
شرکتهای بازار متوسط (با درآمد ۵۰ تا ۵۰۰ میلیون دلار) با مسئله ظرفیت روبرو هستند. آنها ممکن است تنها بودجه ۲ یا ۳ پروژه آزمایشی را داشته باشند و نمیتوانند هزینه شکست یک پروژه را در یک پرتفوی بزرگ سرشکن (Amortize) کنند. آنها اغلب فاقد یک تیم اختصاصی پلتفرم هوش مصنوعی برای جذب کارهای یکپارچهسازی هستند، که این امر باعث میشود حلقههای تصمیمگیری کوتاه و محدود کردن دامنه پروژهها، ضروری باشد.
در یک نظرسنجی ژوئن ۲۰۲۶ توسط Netrio از سازمانهای آمریکایی با ۲۰۰ تا ۵۰۰۰ کارمند، دادهها شکافی تکاندهنده را آشکار میکند:
- استفاده گسترده: ۸۲٪ گزارش دادند که هوش مصنوعی در محیط تولید یا به طور گسترده در جایی از سازمان در حال استفاده است.
- عقبماندگی حاکمیتی: تنها ۲۶٪ گفتند که هوش مصنوعی در سطح سازمان مقیاسبندی شده و تحت حاکمیت است.
- مواجهه امنیتی: ۴۲٪ یک حادثه امنیتی یا مواجهه تأییدشده مرتبط با هوش مصنوعی را در ۱۲ ماه گذشته گزارش کردند؛ ۳۱٪ دیگر نیز موارد «نزدیک به حادثه» (Near-miss) را گزارش نمودند.
علاوه بر این، نظرسنجی سال ۲۰۲۵ RSM در مورد بازار متوسط نشان داد که ۶۲٪ از مدیران، پیادهسازی هوش مصنوعی زاینده (Generative AI) — که شبیه به دستیاری است که متن و کد تولید میکند — را سختتر از حد انتظار دانستند. موانع اصلی ساختاری بودند: کیفیت دادهها نگرانی اصلی برای ۴۱٪ از کسانی بود که با مشکلات پیادهسازی مواجه شدند و فقدان تخصص داخلی، مشکل اصلی برای ۳۹٪ از کسانی بود که احساس میکردند برای این مسیر آماده نیستند.
موج عاملمحور و ریسکهای امنیتی
گذار به هوش مصنوعی عاملمحور (Agentic AI) — جایی که مدلها بهجای صرفاً تولید متن، اقدام (Action) میکنند — شکاف استقرار موجود را به ارث میبرد و یک بُعد حیاتی در اجرا اضافه میکند.
شکاف آزمایشگاهی
فاصله عمیقی میان آزمایشگری و استقرار مقیاسشده وجود دارد. Gartner پیشبینی میکند که تا پایان سال ۲۰۲۶، ۴۰٪ از اپلیکیشنهای سازمانی دارای عاملهای وظیفهمحور (Task-specific Agents) خواهند بود (در حالی که در سال ۲۰۲۵ این رقم زیر ۵٪ بود). با این حال، گزارش نوامبر ۲۰۲۵ McKinsey نشان داد در حالی که ۶۲٪ سازمانها حداقل در حال آزمایش عاملها بودند، نظرسنجی IDC (به سفارش AWS) از بیش از ۹۰۰ سازمان نشان داد که تنها ۳٪ در حال مقیاسبندی هوش مصنوعی عاملمحور در سطح دپارتمانها هستند.
Gartner انتظار دارد بیش از ۴۰٪ از پروژههای هوش مصنوعی عاملمحور تا پایان سال ۲۰۲۷ لغو شوند. دلایل اصلی ذکر شده عبارتند از: هزینههای رو به افزایش، ارزش تجاری نامشخص یا کنترلهای ریسک ناکافی.
ریسکهای اقدام در برابر تولید
یک پروژه آزمایشی هوش مصنوعی زاینده اگر شکست بخورد، یک سند غلط تولید میکند؛ اما عاملی که شکست بخورد، یک «اقدام غلط با دسترسیهای مدیریتی» انجام میدهد. در این حالت، حالتهای شکست دیگر «خجالتآور» نیستند، بلکه «گزارششدنی» (Reportable) میشوند. این ریسکها در ابعاد وسیعتر میتوانند به نتایج فاجعهباری ختم شوند، مشابه آنچه در تجربه شکست یک شرکت در مدیریت کامل توسط هوش مصنوعی مشاهده شد. نظرسنجی سال ۲۰۲۶ Cloud Security Alliance (به سفارش Token) از ۴۱۸ متخصص IT و امنیت نشان داد:
- عاملهای ناشناخته: ۸۲٪ از سازمانها عاملهای هوش مصنوعی ناشناختهای را در محیطهای خود کشف کردند.
- نرخ حوادث: ۶۵٪ حداقل یک حادثه امنیتی مرتبط با عاملها را در ۱۲ ماه گذشته گزارش کردند.
- شکست کنترل: تنها ۱۱٪ از سازمانها توانستند بهطور خودکار مانع از اقدام عاملی شوند که سعی داشت خارج از محدوده تأیید شده خود عمل کند.
مسیر رسیدن به تولید
استقرارهای موفق با پیادهسازی یک «ساختار حداقل پذیرفتنی» (Minimum Viable Structure) پیش از شروع پروژه آزمایشی، این حالتهای شکست را معکوس میکنند. انضباط در اینجا مربوط به ترتیب عملیات است، بهطوری که ساختار به جای آنکه یک استثناء باشد، به حالت پیشفرض تبدیل شود:
۱. تدوین منشور پروژههای آزمایشی با معیارهای توقف: یک معیار خاص، یک آستانه، یک مالک اندازهگیری و یک تاریخ سخت برای تصمیمگیری تعیین کنید. حتی اگر پروژه آزمایشی محبوب است، بر روی تاریخ تصمیمگیری پافشاری کنید.
۲. گنجاندن محدودیتهای تولید در مراحل اولیه: یک محدودیت «شبیه به تولید» را در دمو قرار دهید؛ مانند دسترسی زنده به دادهها از طریق مدل دسترسی واقعی، تریگر واقعی گردش کار، یا بودجه واقعی تأخیر (Latency Budget). پروژهای که از یک محدودیت تولید جان سالم به در ببرد، به اندازه ۱۰ پروژهای که در محیط ایزوله (Sandbox) اجرا شدهاند ارزش دارد.
۳. تعیین مالکیت عملیاتی: نام یک مالک برای «میانهٔ کسلکننده» (مانیتورینگ، نسخهبندی، ردیابی هزینه) تعیین کنید و بودجه آن را بهعنوان «تحویل نرمافزار» تخصیص دهید، نه بهعنوان هزینه «نوآوری».
۴. اعمال حاکمیت تولید: پروژه آزمایشی را تحت همان کنترلهای دسترسی و ردپاهای بازرسی اجرا کنید که برای سیستم نهایی مورد نیاز است. این تنها مدرکی است که میتواند به یک افسر ریسک منتقل شود و او را متقاعد کند.
۵. اعتبارسنجی مسیر داده: دادههایی را که هوش مصنوعی مصرف میکند پیش از اعتماد به خروجی، تأیید کنید. مدل معمولاً مشکلی ندارد؛ این مسیر داده است که نیاز به حاکمیت دارد.
برای شرکتهای بازار متوسط، محدودیت بودجه کوچک تبدیل به یک انضباط میشود؛ وقتی شما تنها میتوانید سه پروژه آزمایشی اجرا کنید، نمیتوانید اجازه دهید هیچکدام از آنها «غیرقابل توقف» باشند. برای سازمانهای بزرگ، چالش این است که اجازه ندهند ساختار حاکمیتی، حجم بوروکراسی را سه برابر کند.
به زودی همین شواهد و مدارک توسط سه چارچوب همپوشان مطالبه خواهد شد: NIST AI RMF، ISO/IEC 42001 و EU AI Act. در مورد قانون هوش مصنوعی اتحادیه اروپا (EU AI Act)، تعهدات مربوط به هوش مصنوعی عمومی در اوت ۲۰۲۵ اجرایی شد و قدرتهای نظارتی از ۲ اوت ۲۰۲۶ آغاز میشود. بسیاری از سازمانها در مسیری هستند که برای رضایت از هر سه چارچوب، سه برنامه موازی و تکراری را بدون یک پردازش یکپارچه اجرا کنند.
این تغییر سازمانی، تعریف موفقیت را از «مدل کار میکند» به «سیستم تحت حاکمیت است» تغییر میدهد.
دریافت الگوها
«ساختار حداقل پذیرفتنی» توصیفشده در اینجا، یک نقطه شروع ملموس دارد. کیت حاکمیتی آماده — شامل CONSTITUTION.md ،DIRECTIVES.md ،SECURITY.md ،AGENTS.md ،CLAUDE.md ،یک هوک برای شاخه محافظتشده (Protected-branch hook) و یک گردش کار CI با پین SHA — در سایت etherealogic.ai/agentic-governance-stack-templates منتشر شده است. این موارد در فرمتی آماده برای کپی-پیست همراه با یک دستور نصب تکمرحلهای (One-shot install prompt) برای عاملهای کدنویسی ارائه شدهاند.
این عناصر اولیه — ابزارهای تایید شده، صلاحیت تصمیمگیری، اجرای زمان اجرا (Runtime Enforcement) و ردپاهای بازرسی — قطعات تحملکننده بار در هر استقرار حاکمیتی هوش مصنوعی، صرفنظر از مقیاس آن هستند. آنها تضمین میکنند که قوانین یک عامل در زمان اجرا (Runtime) اعمال شوند، نه اینکه صرفاً مستند شوند و سازمان امیدوار باشد که رعایت گردند.
این تغییر رویکرد، تعریف موفقیت را از «مدل کار میکند» به «سیستم تحت حاکمیت است» تغییر میدهد. اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو