اگر یک فروشنده کالای دستدوم هستید، یک اشتباه کوچک در شناسایی مدل یک اسباببازی میتواند شما را با جریمههای سنگین قوانین فدرال آمریکا روبرو کند. مشکل اینجاست که در هزاران آگهی آنلاین، شماره مدل محصولاتی که به دلیل نقص فنی فراخوانده شدهاند، تقریباً هیچجا ذکر نمیشود.
طبق بررسیهای تیم توسعهدهنده، از میان ۱۲,۵۶۲ آگهی eBay برای محصولات فراخواندهشده، تنها ۴۵ مورد شماره مدل دقیق را ذکر کرده بودند. این شکاف دادهای باعث شد تا RecallDesk متولد شود؛ سامانهای که هر هفته موجودی فروشگاهها را با اطلاعیههای کمیسیون ایمنی محصولات مصرفی (CPSC) تطبیق میدهد. این سیستم توسط توسعهدهندگان @dronzer2code و @soumyadeepdey ساخته شده تا دشواری بررسی هفتگی موجودی را به صورت خودکار مدیریت کند.
تصور کنید والدینی یک کیسه اسباببازی را به فروشگاه میآورند؛ از ماشین آتشنشانی گرفته تا برج یادگیری چوبی، دستگاه تولید صدای خواب و لباس خواب کودک. کارکنان فروشگاه تنها دو دقیقه برای هر کالا وقت دارند تا بفهمند آیا آن محصول ایمن است یا خیر. بسیاری از اطلاعیههای CPSC در متون ریز و پیچیده پنهان شدهاند؛ مثلاً در اطلاعیه ۱۷ سپتامبر برای ماشین آتشنشانی Melissa & Doug (که حدود ۸۴,۰۰۰ عدد از آن در Target فروخته شده)، برای شناسایی مدل معیوب باید عقربههای تاریخ زیر جعبه باتری را چک کنید. واحدهای آسیبدیده دارای یک عقربه به سمت ۲۵ و عقربه دوم به سمت ۴ یا ۵، یا یک عقربه به سمت ۲۶ و عقربه دوم به سمت ۳ هستند. نام برند یا برچسب قیمت کافی نیست و باید محصول را فیزیکی بررسی کرد.
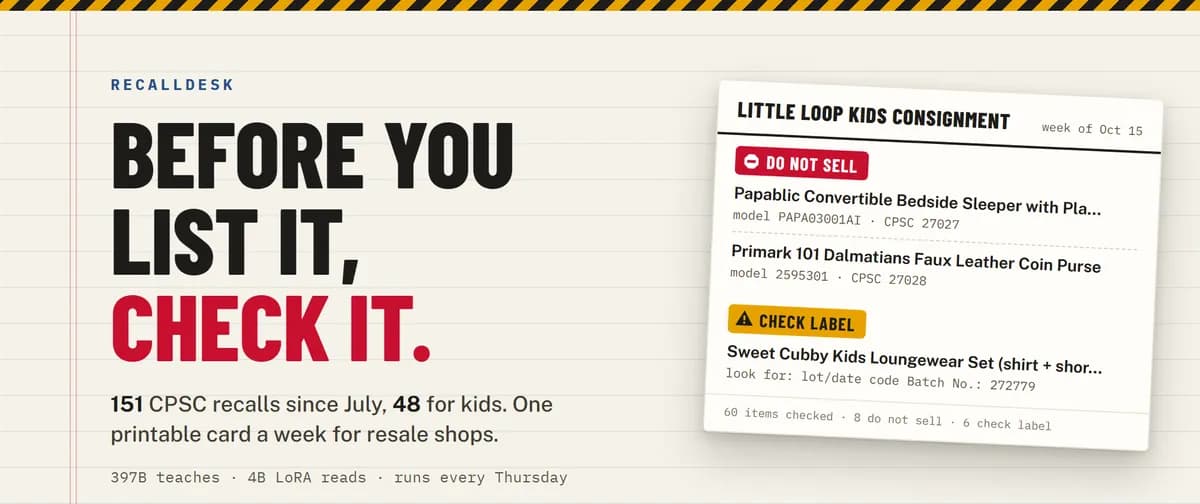
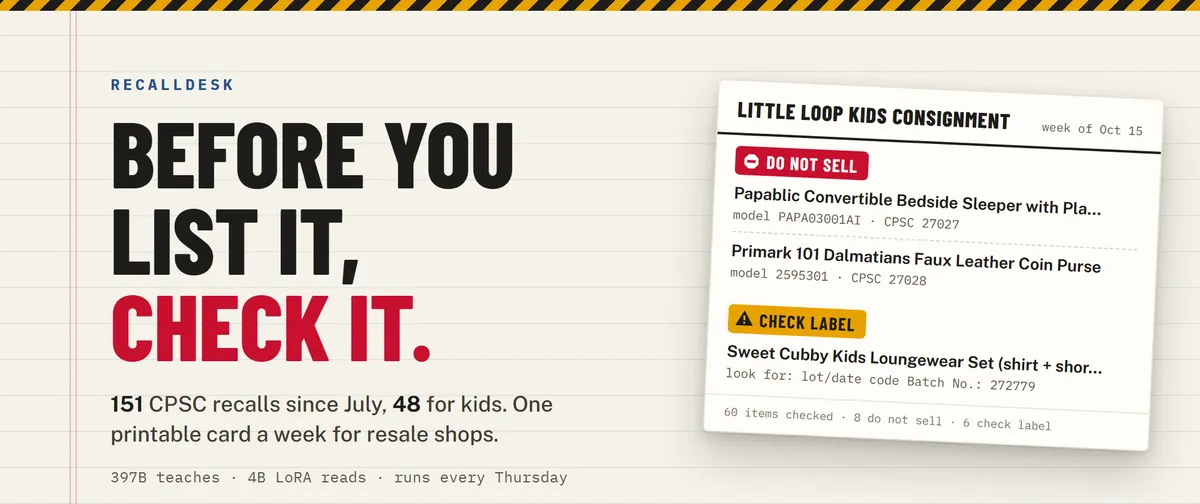
RecallDesk دقیقاً همین شکاف را پر میکند. این سیستم هر پنجشنبه ساعت ۲ بعد از ظهر به وقت شرق آمریکا، اطلاعیههای جدید را میخواند، موجودی فروشگاه و صفحه eBay را بررسی میکند و کارتی چاپ میکند که دقیقاً میگوید چه کالایی باید از قفسه جمع شود و کدامیک نیاز به بررسی فیزیکی برچسب دارد.
شکاف دادهها در بازار کالاهای دستدوم
قبل از ساخت این ابزار، تیم توسعهدهنده ۱۵۱ فراخوان CPSC منتشر شده بین ۱۸ ژوئیه تا ۱۵ اکتبر ۲۰۲۶ را تحلیل کرد. آنها متوجه یک شکست سیستماتیک در نحوه ثبت محصولات آنلاین شدند:
- شناسههای پنهان: در ۷۳ مورد از ۱۵۱ اطلاعیه، شماره مدل، آیتم، استایل یا SKU فقط در بخش توضیحات آمده بود و هرگز در عنوان ذکر نشده بود. در محصولات کودکان، این اتفاق در ۲۴ مورد از ۴۸ اطلاعیه رخ داد. برای مثال، در فراخوان «پلههای آشپزخانه کودکان Woodure»، نام برند در عنوان است، اما ذکر شده که شماره مدل روی قسمت زیرین پله پایین حک شده است.
- حجم آگهیها: با استفاده از موتور جستجوی SerpApi در eBay، آنها ۲۳۷ فراخوان (۱۵۱ مورد اخیر به علاوه ۸۶ مورد قدیمیتر کودکان) را جستجو کردند که منجر به ۱۴,۰۶۸ نتیجه و ۱۲,۵۶۲ آگهی منحصربهفرد شد. این کار شامل ۲۳۵ جستجوی پولی بود، زیرا دو فراخوان از یک کوئری کششده استفاده میکردند.
- شکاف شناسهها: تنها ۴۵ آگهی در عنوان خود شناسهی فراخواندهشده را داشتند که مربوط به تنها ۱۳ فراخوان بود. برای محصولات کودکان، تنها ۲ مورد از ۶,۹۰۱ آگهی مطابقت داشتند که هر دو مربوط به یک برند خاص از استیکهای غواصی استخر بودند.
- ریسک کالاهای دستدوم: فروشندگان دستدوم کمترین احتمال را دارند که شماره مدل را تایپ کنند. در حالی که ۱۷.۱٪ از کل آگهیها دستدوم بودند (۲۰.۲٪ برای کودکان)، تنها ۹٪ از آن ۴۵ مورد تطبیق دقیق، کالاهای دستدوم بودند.
این دادهها ثابت میکند که فیلترهای کلمات کلیدی میتوانند چند مورد را شناسایی کنند، اما نمیتوانند ۱۲,۵۱۷ آگهی دیگر را تایید کنند، زیرا عنوانی که شماره مدل ندارد، هیچ چیزی را اثبات نمیکند.
معماری هوش مصنوعی «معلم-شاگرد»
برای مدیریت این پیچیدگی، تیم از یک استراتژی مدل لایهای استفاده کرد. آنها از یک مدل عظیم «معلم» به نام Qwen3.5-397B-A17B استفاده کردند تا مشخصات ساختاریافته (برند، شماره مدل، کدهای تاریخ، بازه زمانی فروش) را برای ۵۹۱ فراخوان بنویسد. این فرآیند ۱۰۰ ثانیه زمان برد و ۲.۲۱ دلار هزینه داشت. مدل معلم همچنین ۳,۳۰۰ جفت (فراخوان، آگهی) را برچسبگذاری کرد.
با این حال، اجرای یک مدل ۳۹۷ میلیاردی برای هر فروشگاه در هر هفته از نظر هزینه غیرمنطقی بود (حدود ۲.۲۰ دلار به ازای هر ۱۰۰۰ بررسی). برای حل این مشکل، آنها از Tinker برای تنظیم دقیق (Fine-tuning) یک مدل «شاگرد» بسیار کوچکتر به نام Qwen3.5-4B (با استفاده از LoRA rank 32) استفاده کردند.
جزئیات آموزش
- مجموعه داده: ۳,۰۰۷ جفت داده برای آموزش استفاده شد. تیم از ۲ اپوک (Epoch) ثابت و ۳۷۶ گام با اندازه دسته (Batch) ۱۶ استفاده کرد.
- ابرپارامترها: نرخ یادگیری ۴.۹۱e-۴ بود که به صورت خطی کاهش یافت و تابع زیان (Loss) فقط روی خروجیهای JSON اعمال شد. زیان دادههای کنار گذاشته شده (Held-out loss) از ۰.۷۲۴ به ۰.۲۲۸ بهبود یافت.
- بهینهسازی: تیم از یک تابع سفارشی به نام
is_generic_lookalikeاستفاده کرد تا زمانی که مدل معلم به اشتباه کالاهای مشابه بدون برند را به عنوان «بررسی کن» علامت میزد، آن را بازنویسی کند. این تابع روی ۳۹۱ جفت (۳۵۷ در آموزش، ۳۴ در تست) اجرا شد تا مدل شاگرد یاد بگیرد که آگهی بدون برند یا شناسه، یکno_matchاست، مگر اینکه نام یک شخصیت دارای لایسنس را ذکر کرده باشد. - بهرهوری هزینه: این تغییر هزینه را از ۲.۲۰ دلار به ۰.۱۹ دلار به ازای هر ۱۰۰۰ بررسی کاهش داد. کل هزینه Tinker برای استخراج مشخصات (۲.۲۱ دلار)، برچسبگذاری (۶.۸۰ و ۷.۴۷ دلار)، آموزش (۲.۳۹ دلار) و ارزیابی (۰.۲۳ دلار) تقریباً ۱۹.۱۰ دلار بود.
عملکرد و دقت
نتایج تنظیم دقیق بسیار چشمگیر بود. در ۲۹۳ جفت تست کنار گذاشته شده، مدل پایه ۴ میلیاردی دقتی معادل ۰.۵۱۲ داشت. اما نسخه RecallDesk LoRA به دقت ۰.۹۱۸ (با فاصله اطمینان ۹۵٪ بین ۰.۸۸۴ تا ۰.۹۴۹) رسید.
مهمتر از آن برای صاحبان کسبوکار، سیستم به شدت «نویز» را کاهش داد. مدل پایه ۱۲۰ هشدار اشتباه (ارسال کالاهای ایمن به بخش CHECK LABEL) از ۲۵۵ آگهی ایجاد میکرد. مدل LoRA تنظیمشده این مقدار را به تنها ۱۲ هشدار اشتباه کاهش داد.
تحلیل خطاها
از ۱۲ خطای باقیمانده، ۹ مورد مربوط به درپوش تخلیه استخر Sviyatp بود که هیچ برچسبی روی خود محصول ندارد. مدل LoRA به درستی اینها را به عنوان کالاهای مشابه شناسایی کرد، اما یک قانون کدنویسی شده آنها را در وضعیت «بررسی کن» نگه داشت زیرا عنوانها عبارت «dual suction outlet» را با بستهبندی محصول به اشتراک داشتند. سایر خطاها شامل اسباببازیهای بدون برند بود، مانند یک بسته ۱۴ تایی چراغ انگشتی که با فراخوانی برای بستههای ۲۸ و ۳۰ تایی مقایسه شده بود.
مهندسی گردش کار (Workflow)
این سیستم تنها یک مدل نیست، بلکه یک خط لوله تولیدی است که با فناوریهای کلیدی زیر ساخته شده است:
- Temporal: مدیریت زمانبندی هفتگی (پنجشنبهها، ساعت ۱۴:۰۰ به وقت نیویورک). این ابزار از سیاستهای تلاش مجدد (Retry) و جایگزین (Fallback) برای هر فعالیت استفاده میکند. در «تستهای کرش»، تیم فرآیند Worker را در میانه اجرا (مثلاً کشتن pid 12764 در ثانیه ۷۳.۲) متوقف کرد. یک Worker جدید تاریخچه را بازپخش کرد و کارت را بدون تکرار کارها به پایان رساند و اطمینان داد که ۶۰ فعالیت دقیقاً یک بار اجرا شوند. سیستم تغییرات ساعت تابستانی (DST) را نیز مدیریت میکند (مثلاً اجرا در ساعت ۱۸:۰۰ UTC در ۲۲ و ۲۹ اکتبر و سپس ۱۹:۰۰ UTC در ۵ نوامبر).
- Backboard: مدیریت «حافظههای فروشگاه». اگر کارمندی به صورت دستی تأیید کند که یک آیتم خاص نسخه فراخواندهشده نیست (مثلاً برج کودک HARPPA مدل ۲۰۲۲ است، نه مدل معیوب)، این مورد به عنوان یک حافظه معنایی ذخیره میشود. این رویکرد در مدیریت حافظه عاملهای هوشمند اهمیت زیادی دارد و مشابه استانداردهایی است که در بازرسیهای فنی برای ورود به فهرست Awesome-Agent-Memory بررسی میشوند. سیستم در اجراهای آینده، این اصلاح را با استفاده از یک گارد «همپوشانی ۶۰ درصدی کلمات» بازیابی میکند تا از پاک شدن اشتباه آیتمهای غیرمرتبط جلوگیری شود.
- Next.js & BoardUI: داشبورد تنظیمات و حسابرسی. این بخش به مالکان اجازه میدهد متن CPSC را با شناسههای هایلایت شده در کنار مشخصات استخراج شده ببینند تا بفهمند «چرا این مورد علامتگذاری شد؟»
هزینه ایمنی
برای یک فروشگاه دمو با ۶۰ آیتم، یک بررسی کامل ۱۷۹ فراخوانی مدل نیاز داشت و حدود ۰.۰۳۵ دلار هزینه برد. توسعهدهندگان قیمت سرویس را ۱۵ دلار در ماه برای هر فروشگاه و ۴۹ دلار برای هر رویداد کنسایمنت (امانی) تعیین کردند.
آنها به یک محدودیت حیاتی اذعان دارند: هوش مصنوعی نمیتواند برچسب را در عکس «ببیند». به همین دلیل سیستم سه حکم متمایز صادر میکند:
- DO NOT SELL (نفروش): برای تطابقهای دقیق (مثلاً تخت کنار تختی Papablic مدل PAPA03001AI).
- CHECK LABEL (برچسب را چک کن): برای آیتمهایی که نیاز به چشم انسان دارند، همراه با ذکر دقیق محل بررسی (مثلاً «شماره مدل WD1764... حک شده در زیر پله پایین» یا «شماره سری: ۲۷۲۷۷۹» روی برچسب دوخته شده در یقه).
- no_match (بدون تطابق): برای کالاهای ایمن.
نوآوری باز و استقرار
این پروژه نشان میدهد که مدلهای Open-weight اجازه ساخت ابزارهای بسیار تخصصی و کمهزینه را میدهند که اجرای آنها روی APIهای بسته و گرانقیمت ممکن نبود. آداپتور نهایی به صورت وزنهای PEFT برای سرورهای vLLM یا llama.cpp شخصی فروشگاه صادر میشود.
برای توسعهدهندگان، کل استک را میتوان از طریق Render Blueprint یا به صورت محلی با استفاده از uv برای پایتون ۳.۱۲ مستقر کرد. معماری به چهار دایرکتوری تقسیم شده است:
ml/: شامل جمعآوری داده، مشخصات، جستجوی eBay، برچسبگذاری، آموزش و ارزیابی.agent/: شامل گردشکارهای Temporal، API و حافظه فروشگاه.web/: داشبورد Next.js.shared/: شاملschema.pyکه قرارداد واحد بین سه دایرکتوری دیگر است.
زمینه و جزئیات پیادهسازی
زمینه قانونی و بازار
- تخلفات فدرال: کمپین «Resale Round-up» کمیسیون CPSC صراحتاً به فروشگاههای دستدوم و فروشندگان آنلاین هشدار میدهد که فروش محصولات فراخواندهشده، نقض قانون فدرال است.
- بقا در بازار: هشدار Consumer Reports از طریق News4Jax در ۶ اکتبر اشاره کرد که تجهیزات ممنوعه کودک همچنان در Craigslist، eBay و Facebook Marketplace فعال هستند.
- مقیاس اجرا: تحلیل سال ۲۰۲۶ توسط Buchalter نشان داد که CPSC صدمین هزارمین اخطاریه حذف (Takedown notice) را برای محصولات ممنوعه یا فراخواندهشده در فضای آنلاین صادر کرده است.
- پاسخ پلتفرمها: eBay گزارش داد که مدلهای هوش مصنوعی، قوانین کلمات کلیدی و بررسیهای دستی آن در سال ۲۰۲۵ مانع از انتشار ۲۱ میلیون آگهی بالقوه ناایمن در سراسر جهان شده است.
لبههای فنی و شکستها
- محدودیتهای API: شش اطلاعیه CPSC غیرقابل خواندن بود زیرا شماره مدلها فقط در سایت cpsc.gov ذکر شده بود و این سایت درخواستهای خودکار را مسدود میکند.
- اختلالات آموزش: یک خطای ۴۰۲ زمانی که اعتبار Tinker تمام شد، آموزش را متوقف کرد؛ تیم با افزودن تایماوتهای ۳۰۰ ثانیهای به تمام انتظارها این مشکل را حل کرد.
- ناپایداری حافظه: جستجوی معنایی با نامهای طولانی آیتمها مشکل داشت. سیستم اکنون نام برند، نام محصول و مدل را به صورت جداگانه جستجو میکند تا اصلاحات حتماً پیدا شوند.
- خطاهای مدل معلم: مدل ۳۹۷ میلیاردی به طور مداوم در اجرای «قانون ۷» (کالاهای مشابه بدون برند) شکست میخورد، که باعث شد تیم این قانون را از طریق کد روی اهداف آموزشی تحمیل کند.
استقرار و راهاندازی
- اجرای محلی: کاربران میتوانند مخزن را کلون کرده و از دستور
python -m uv venv --python 3.12برای ایجاد محیط استفاده کنند. - زمان اجرا: سیستم یک Runtime برای Agent و یک داشبورد را اجرا میکند و کلیدهای اختیاری برای Tinker، SerpApi و Backboard میطلبد.
- بازیابی: دستور
agent.demo_crashبه کاربران اجازه میدهد Worker را در میانه بررسی متوقف کنند تا شاهد بازیابی خودکار Temporal باشند.
برای کسانی که فروشگاههای دستدوم در آمریکا دارند، تیم در حال حاضر اجراهای آزمایشی رایگان ارائه میدهد تا بازخوردهای واقعی درباره مسئولیتهای قانونی و اصطکاکهای ورود داده جمعآوری کند. آنها حدس میزنند که ادغام با سیستمهای POS (نقطه فروش) برای وارد کردن موجودی، ویژگی حیاتی بعدی برای پذیرش گسترده این ابزار خواهد بود.



گفتگو