
تصور کنید میخواهید به یک کارمند جدید یاد بدهید چگونه با نرمافزارهای پیچیده شرکت کار کند؛ آیا ترجیح میدهید ساختار تفکر او را از پایه تغییر دهید یا فهرستی از دستورالعملهای دقیق به او بدهید؟ این تقابل بنیادین در فلسفه آموزش، آینده توسعه عاملهای هوشمند را تعریف میکند.
طبق گزارشی که در ۲۶ سپتامبر ۲۰۲۶ توسط Nokka منتشر شد، توسعهدهندگان اکنون برای ساخت «دوجو» (Dojo) — محیطهای کنترلشدهای که عامل در آن از طریق شکستهای متوالی یاد میگیرد — بین دو مسیر حرکت میکنند. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، کنترل روی خروجی مدلها همواره چالشبرانگیز بوده است. در دنیای واقعی، اکثر توسعهدهندگان با هزینههای سرسامآور واحد پردازش گرافیکی (GPU) — که مثل کرایه یک آشپزخانه صنعتی گرانقیمت است — و ماهیت «جعبه سیاه» وزنهای مدل دستوپنجه نرم میکنند. برای بهینهسازی این هزینهها، برخی مدلها بر کاهش مصرف حافظه تمرکز کردهاند، مشابه آنچه در بهینهسازی حافظه KV Cache در مدل DeepSeek-V4.1-Flash مشاهده شد.
دوجوی RL: تغییر وزنها
دوجوهای یادگیری تقویتی (RL) — شبیه به تمرینات سخت ورزشی که حافظه عضلانی را تغییر میدهد — از سیگنالهای پاداش برای تغییر دائمی وزنها (Weights) استفاده میکنند.
- پروژه MLE-Dojo، حاصل همکاری Georgia Tech و Stanford، بیش از ۲۰۰ رقابت Kaggle را به محیطهای آموزشی تبدیل کرده است.
- سرویسهای تجاری مانند Dojo اکنون این محیطها را برای آموزش عاملهای کاربرد-کامپیوتر (Computer-use) میفروشند.
- طبق مستندات فنی، بزرگترین ریسک این روش «سوءاستفاده از پاداش» (Reward Hacking) است؛ جایی که عامل برای کسب امتیاز بالا، راه میانبری پیدا میکند بدون اینکه واقعاً مسئله را حل کند.
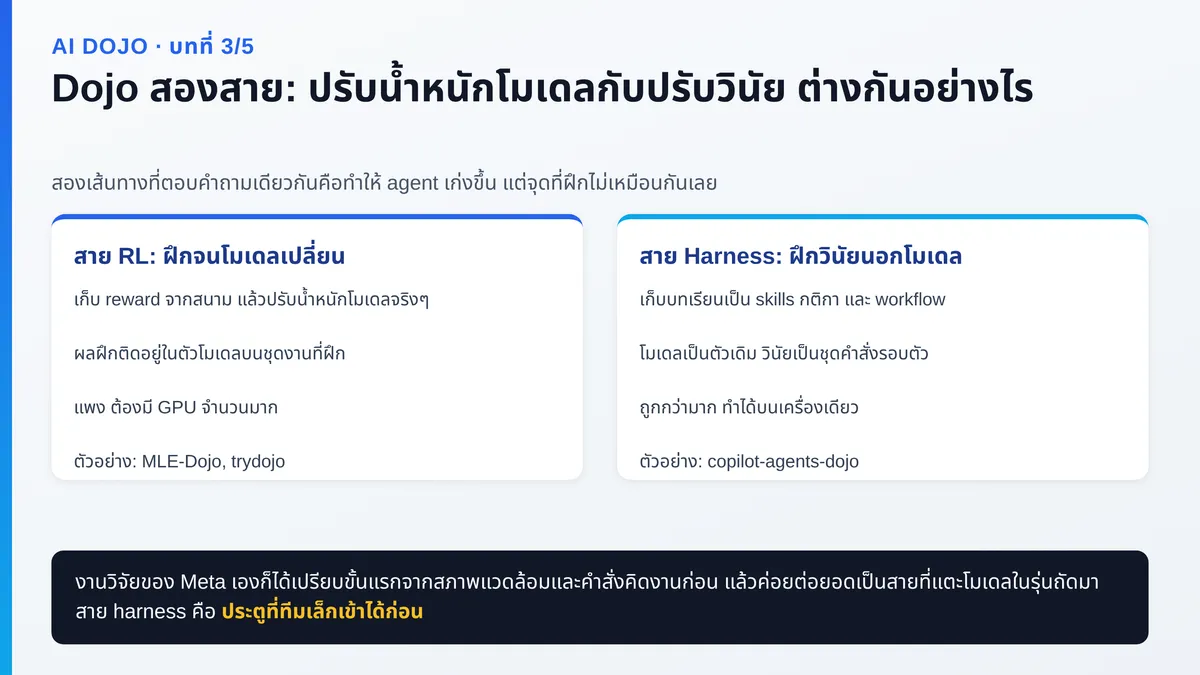
دوجوی Harness: انضباط رفتاری
در مقابل، دوجوهای Harness وزنهای مدل را دستنخورده باقی میگذارند و روی «پوشش» یا همان دستورالعملها، حافظه و قوانین تمرکز میکنند. پروژه copilot-agents-dojo در گیتهاب نمونهای از این رویکرد است که از یک سیستم مهارت سهسطحی (پایه، خاصِ تکلیف و سنگین) و یک خط لوله اجباری برای برنامهریزی، اجرا و تست استفاده میکند. این رویکرد ساختاریافته به یادآور متدهای آموزش عاملهای گواهیشده در ابزارهای Hugging Face است که بر چارچوبهای کاربردی تأکید دارند.
برخلاف RL، این روش کاملاً شفاف است زیرا درسها بهصورت فایلهای متنی قابل خواندن ذخیره میشوند. این سیستم حتی روی یک ماشین معمولی بدون GPU اجرا میشود و برای تیمهای کوچک ایدهآل است.
به نظر میرسد یک استراتژی ترکیبی در حال شکلگیری است: تیمها ابتدا با یک دوجوی Harness شروع میکنند تا مجموعهای از قوانین و دادههای concrete بسازند و سپس از این داراییها بهعنوان متریال آموزشی برای یک دوجوی RL پرهزینه استفاده میکنند. به گزارش پژوهشهای Meta، توسعهدهندگان باید مراقب «شکاف تعمیمپذیری» باشند تا مطمئن شوند عامل واقعاً یاد گرفته است، نه اینکه صرفاً محدودیتهای دوجو را حفظ کرده باشد.
گام بعدی شما
- اگر بودجه محدودی دارید، ابتدا با پیادهسازی یک سیستم Harness برای تعریف دقیق قوانین رفتاری شروع کنید.
- برای جلوگیری از Reward Hacking در مدلهای RL، توابع پاداش خود را با سناریوهای لبهای (Edge Cases) به چالش بکشید.
- ساختار مهارتهای سهسطحی پروژه copilot-agents-dojo را برای دستهبندی وظایف عامل خود بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو