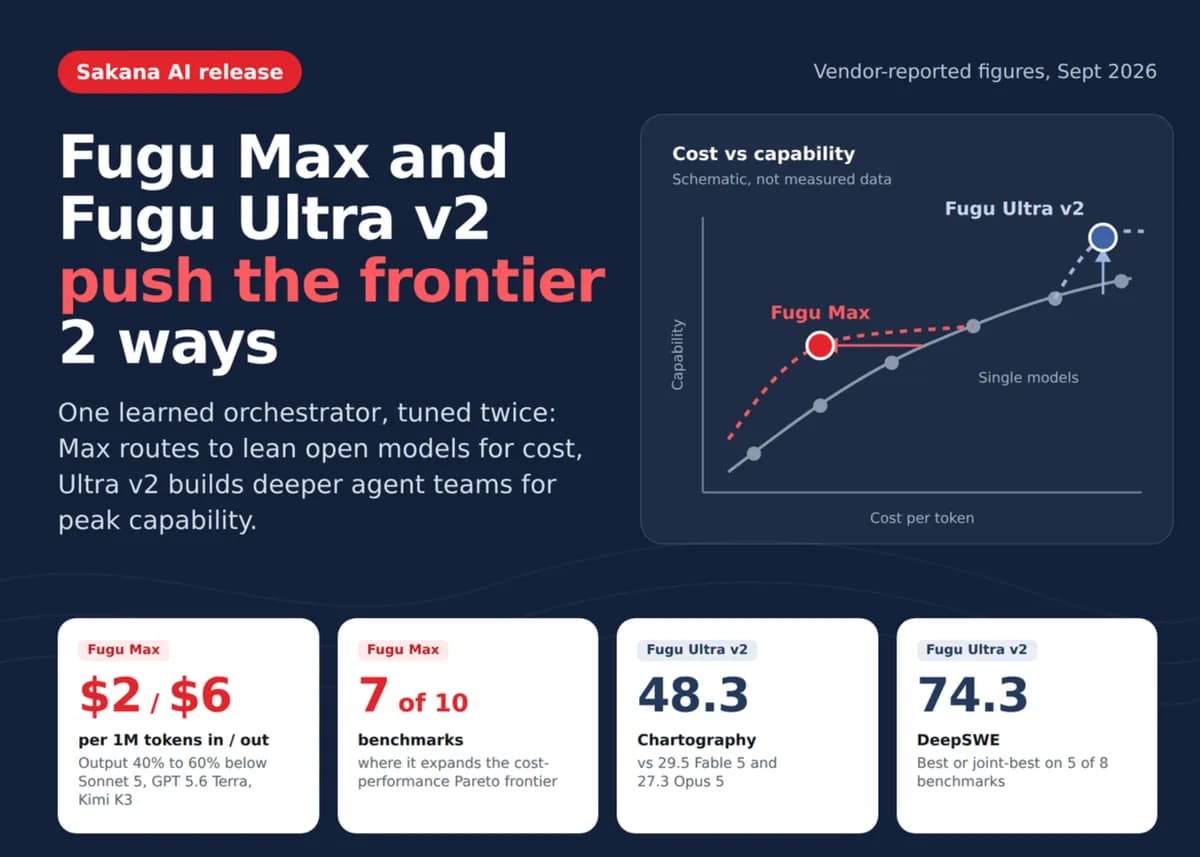
اگر امروز برای خروجیهای سطح بالا هزینه میپردازید، احتمالاً به زودی صورتحساب استنتاج شما ۴۰ تا ۶۰ درصد کاهش مییابد. در حالی که مدلهایی مانند Sonnet 5، GPT 5.6 Terra و Kimi K3 سطح نخبهی هوش مصنوعی را تعریف میکنند، شرکت Sakana AI با معرفی دو ارکستراتور جدید به نامهای Fugu Max و Fugu Ultra v2، بازی هزینههای مدلهای سطح بالا را تغییر داد.
این سیستمها برخلاف مدلهای بنیادی (Foundation Model) — که شبیه به یک دانشمند همهفنحریف هستند که برای هر سوال سادهای هم از تمام دانشش استفاده میکند — به عنوان مسیریابهای هوشمند عمل میکنند. آنها هر درخواست را تحلیل کرده و آن را به ارزانترین مدلی که قادر به حل مسئله است میسپارند. این رویکرد در واقع به ناکارآمدی رو به رشدی در استک هوش مصنوعی پاسخ میدهد: استفاده از مدلهای تریلیون-پارامتری برای جستوجوهای سادهی دادهها. همانطور که در تحلیل قبلی ما دربارهی OpenAI Agents API اشاره کردیم، اتوماسیونِ مدیریت مدلها در حال تبدیل شدن به استاندارد جدید است، اما رویکرد Sakana مستقیماً روی «مرز پارتو» (Pareto frontier) تمرکز دارد تا توازن میان کیفیت و قیمت را بهینه کند. این تلاش برای بهینهسازی هزینهها در راستای روندی است که در آن مدلهای کوچک و وزنباز به طور متمرکز هزینهی استنتاج عاملهای هوش مصنوعی را کاهش دادهاند.
زمینه و توسعه
توسعه Fugu با سرعت بسیار بالایی پیش رفته است. این سیستم ابتدا در ماه آوریل وارد مرحله بتا شد، در ژوئن به دسترسی عمومی (GA) رسید و در ماه جولای با معرفی Fugu-Cyber و یک رابط کاربری Claude Code گسترش یافت.
شرکت Sakana استدلال میکند که بارهای کاری واقعی باید بر اساس ترکیب «قابلیت» و «هزینه» قضاوت شوند. در مرز پارتو، افزایش کیفیت هزینه بیشتری میطلبد و کاهش هزینه منجر به افت کیفیت میشود. Fugu Max و Fugu Ultra v2 از یک معماری ارکستراسیون هستهای مشترک استفاده میکنند، اما اهداف بهینهسازی آنها با یکدیگر متفاوت است.
سیستم Fugu یک ارکستراتور یادگیرنده است که پرسوجو را میخواند و در لحظه یک داربست عاملمحور (Agentic Scaffold) میسازد. طبق گزارش فنی شرکت، این سیستم از ترکیبی از تنظیم دقیق در مقیاس بزرگ، الگوریتمهای تکاملی و یادگیری تقویتی استفاده میکند. این معماری بر دو مقاله پژوهشی ICLR ۲۰۲۶ استوار است:
- TRINITY: از یک هماهنگکننده تکاملیافته و سبک استفاده میکند تا نقشهای «متفکر» (Thinker)، «کارگر» (Worker) یا «راستیآزم» (Verifier) را در هر نوبت گفتگو تخصیص دهد.
- The Conductor: با یادگیری تقویتی آموزش دیده است تا پرامپتهای متمرکز و استراتژیهای هماهنگی به زبان طبیعی را کشف کند.
Fugu Max: بهینهسازی برای ارزش
Fugu Max با هدف بهینهسازی ارزش طراحی شده است. این مدل مجموعه مدلهای در دسترس را گسترش داده تا شامل طیف وسیعی از مدلهای وزنهای باز (Open Weights) و مدلهای تخصصی باشد؛ از جمله خانواده NVIDIA Nemotron که از طریق همکاری با انویدیا اضافه شده است. Fugu Max وظایف را به کمحجمترین مدلی که قادر به حل آنهاست مسیریابی میکند. این رویکرد یادآور موفقیتهای اخیر در مدلهای تخصصی است، مشابه آنچه در مدلهای Smaug برای کاهش ۱۰۰ برابری هزینههای عملیاتی عاملها مشاهده شد.
شاخصهای کلیدی این مدل عبارتند از:
- قیمتگذاری: ۲ دلار برای هر میلیون توکن ورودی و ۶ دلار برای هر میلیون توکن خروجی.
- عملکرد: کسب بالاترین امتیازات کلی در ۶ بنچمارک: Terminal Bench 2.1، GPQA Diamond، AA-LCR، GDP.pdf، AutomationBench و SWEFish (یک بنچمارک کدنویسی داخلی Sakana).
- کارایی: گسترش مرز هزینه-عملکرد در ۷ مورد از ۱۰ بنچمارک، که آن را در فاصله بسیار نزدیکی به مدلهای نخبه قرار میدهد، در حالی که هزینه آن ۲ تا ۶ برابر کمتر است.
Fugu Ultra v2: جابهجایی سقف تواناییها
Fugu Ultra v2 برای استدلالهای پیچیده، پژوهشهای خودمختار و توسعه فولاستک طراحی شده است. این مدل پیشرفتهای قابل توجهی در استدلالهای مستمر روی دادههای بصری و ساختاریافته نشان میدهد.
- Chartography (استدلال بصری): نمره ۴۸.۳ را کسب کرد که به طور چشمگیری از Opus 5 (نمره ۲۷.۳) و Fable 5 (نمره ۲۹.۵) پیشی گرفته است.
- DeepSWE (مهندسی نرمافزار): به نمره ۷۴.۳ رسید و مدلهایی را شکست داد که قیمت هر توکن آنها ۳ تا ۵ برابر بیشتر است.
- دامنه توانایی: در ۵ مورد از ۸ بنچمارک (GDP.pdf، Chartography، SWEFish، DeepSWE و Toolathon) رتبه اول یا مشترک اول را کسب کرد.
- ثبات: در ۷ مورد از ۸ بنچمارک، در بین دو رتبه برتر قرار گرفت.
نکته قابل توجه این است که Ultra v2 این نتایج را بدون گنجاندن مدلهای Fable 5، Fable 5.1 یا GPT-6-Astra در استخر مدلهای خود به دست آورده است. تاریخ قطع آموزش (Training Cutoff) برای این مدلها ۲۸ اوت ۲۰۲۶ است.
برای صاحبان کسبوکار، این تحول به معنای پایان وابستگی مطلق به یک ارائهدهنده (Vendor Lock-in) است. شما دیگر مجبور نیستید برای دسترسی به کیفیت سطح اول، تنها به یک مدل انحصاری متکی باشید. این نوع بهینهسازی در مقیاس صنعتی، مشابه کاهش ۵۰ درصدی هزینههای هوش مصنوعی در پلتفرم Accio برای تجارت الکترونیک است. تیم پژوهشی بیان میکنند که این رویکرد، میزان مواجهه با لغو دسترسی به APIها و قطع ناگهانی سرویسها را کاهش میدهد.
این معماری، استک هوش مصنوعی را از یک خودروی تکموتوره به یک ناوگان تبدیل میکند؛ جایی که «مغز» (ارکستراتور) از «عضله» (مدلهای Worker) جدا شده است. با این جداسازی، Sakana به کاربران اجازه میدهد قابلیتها را بدون افزایش خطی صورتحساب ابری خود، مقیاسبندی کنند.
هر دو مدل هماکنون به عنوان یک سرویس میزبانی شده از طریق API سازگار با OpenAI در دسترس هستند. کاربران میتوانند تنها با یک خط کد به Fugu سوییچ کنند، هرچند این سرویس در حال حاضر در اتحادیه اروپا و منطقه اقتصادی اروپا (EU/EEA) در دسترس نیست. همچنین هیچ وزن بازی برای میزبانی شخصی (Self-hosting) ارائه نشده است.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای کارهای تکراری استفاده میکنید، API مدل Fugu Max را برای کاهش هزینههای عملیاتی تست کنید.
- در پروژههای کدنویسی پیچیده، عملکرد Ultra v2 را در برابر مدلهای فعلی خود در محک DeepSWE بسنجید.
- استراتژی زیرساخت خود را از تکمدلی به مدلهای ارکسترهشده تغییر دهید تا ریسک قطع سرویس یک شرکت را کاهش دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو