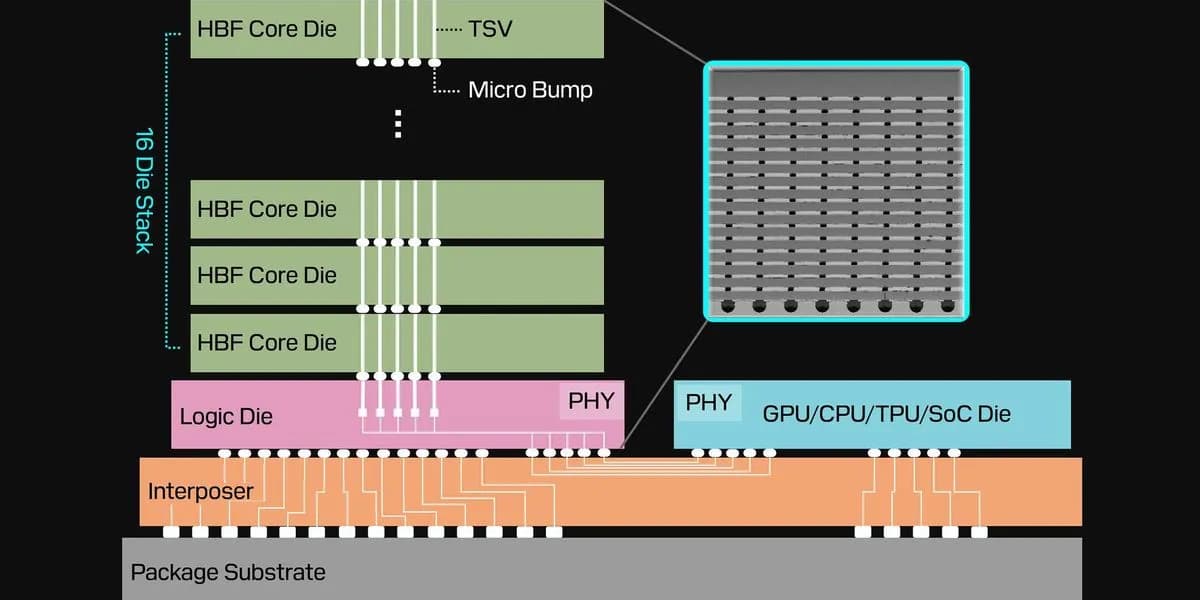
اگر امروز برای اجرای یک مدل زبانی عظیم با محدودیت حافظه مواجه هستید، معماری جدید حافظهها میتواند تعداد شتابدهندههای مورد نیاز شما را به شدت کاهش دهد. شرکتهای Sandisk و SK Hynix در حال توسعه فناوری جدیدی به نام حافظه فلش با پهنای باند بالا (HBF) هستند تا مشکل کمبود فضای حافظه در مدلهای غولآسای هوش مصنوعی را حل کنند. طبق گزارش وبسایت spectrum.ieee.org، هدف این پروژه رسیدن به پهنای باند خواندن ۱.۶ ترابایت بر ثانیه در نسل اول محصولات است. این یعنی مراکز داده میتوانند مدلهای بزرگتر را با تعداد کمتری از شتابدهندهها (Accelerators) — همان تراشههای گرانقیمتی که محاسبات سنگین را انجام میدهند — اجرا کنند.
مدلهای زبانی بزرگ (LLM) با افزایش تعداد کاربران و مقیاسپذیری تقاضا، به حافظهای عظیم نیاز دارند. صنعت تاکنون برای تأمین این نیاز بر حافظه پهنای باند بالا (HBM) و DRAM تکیه کرده است، اما این فناوریها بسیار گران هستند و مصرف برق آنها بسیار بالاست. تولیدکنندگان حافظه برای جبران این نیاز، برنامههای ساخت کارخانههای جدید (Fabs) را تسریع کردهاند و برخی از خطوط تولید HBM برای شروع فعالیت در سال ۲۰۲۷ برنامهریزی شدهاند. برای پر کردن این شکاف زمانی و فنی، فناوری HBF سعی میکند موفقیتهای دستهبندی سهبعدی (3D-stacking) در HBM را به حافظه NAND Flash — همان فناوری موجود در فلشمِموریهای USB و گوشیهای هوشمند — منتقل کند.
تصور کنید حافظه کامپیوتر شما مثل یک فضای کاری است. HBM میزِ سریع است که محاسبات فعال روی آن انجام میشود و فلشهای معمولی مثل یک بایگانی دور از دسترس هستند. فناوری HBF در واقع آن بایگانی دور را به یک سیستم بازیابی خودکار و فوقسریع تبدیل میکند تا دادهها را بسیار سریعتر از آنچه استانداردهای ذخیرهسازی قبلی اجازه میدادند، به روی میز محاسبات منتقل کند.
سازوکار فنی و جزئیات
حافظه NAND دادهها را به صورت بارهای الکتریکی بهدامافتاده در آرایههایی از ترانزیستورهای گیت شناور (Floating-gate transistors) ذخیره میکند. این دادهها به جای بایتهای منفرد، در قالب بلوکها و صفحات سازماندهی میشوند. از آنجایی که این حافظه غیرفرار (Non-volatile) است، دادهها حتی پس از قطع جریان برق نیز باقی میمانند.
این ویژگیها باعث میشود فلش یک انتخاب برتر برای ذخیرهسازی بلندمدت باشد. این فناوری میتواند بایتهای بیشتری را در همان مساحت نسبت به DRAM ذخیره کند و از خازنهای پرمصرفی که برای حفظ بار الکتریکی نیاز به تازهسازی (Refreshing) مداوم دارند، اجتناب میکند. با این حال، این مکانیسمها یک نقطه ضعف ایجاد میکنند: انتقال بار الکتریکی به داخل و خارج از یک گیت عایق، زمان بیشتری نسبت به شارژ یک خازن میبرد و همین امر باعث میشود سرعت نوشتن در حافظههای فلش پایین باشد.
جیم هندی، مدیر ارشد مؤسسه پژوهشی بازار نیمههادیها Objective Analysis، اشاره میکند که اگرچه سرعت نوشتن در فلشها «به شدت پایین» یا حتی «فاجعهبار» است، اما میتوان آنها را برای رسیدن به سرعتهای خواندن بسیار بالا «ترغیب» کرد. HBF دقیقاً برای بهرهبرداری از این پتانسیل سرعت خواندن طراحی شده است.

مشخصات فنی و نقشه راه
SK Hynix برای رفع کندی ذاتی NAND، از روی هم چیدن چندین لایه حافظه (Die) به صورت عمودی برای افزایش پهنای باند استفاده میکند. هوشیک کیم، نایبرئیس ارشد پژوهشهای سیستمهای حافظه در این شرکت، تأکید میکند که بهکارگیری این تکنیکهای بستهبندی سهبعدی باعث میشود HBF پهنای باند بسیار بیشتری نسبت به ذخیرهسازهای استاندارد NVMe ارائه دهد.
- ظرفیت: نسل اول HBF تا ۱۶ تراشه NAND را به صورت عمودی روی هم میچیند تا به ظرفیت کل ۵۱۲ گیگابایت در هر دسته (Stack) برسد.
- عملکرد خواندن: هدف محصول اولیه رسیدن به ۱.۶ ترابایت بر ثانیه است. نقشه راه Sandisk پیشبینی میکند که نسل دوم و سوم به ترتیب به ۲ ترابایت و ۳.۲ ترابایت بر ثانیه برسند.
- مقایسه: آخرین استاندارد رابط فلش تنها تا ۴.۸ گیگابایت بر ثانیه برای هر لایه (Die) را پشتیبانی میکند. در مقابل، DDR5 تا ۷۰.۴ گیگابایت بر ثانیه برای هر DIMM فراهم میکند و HBM4E میتواند به ۳.۶ ترابایت بر ثانیه در هر دسته برسد؛ این یعنی HBM4E حدود ۷۵۰ برابر سریعتر از فلشهای معمولی است.
برتری در مرحله استنتاج
این حافظه برای آموزش (Training) مدلهای هوش مصنوعی ساخته نشده است. فرآیند آموزش شامل ارائه توکنهای ورودی و تغییر مداوم وزنها از طریق پسانتشار (Back-propagation) است. چون آموزش نیازمند خواندن و نوشتن شدید در میلیاردها یا تریلیونها وزن مدل است، حافظه فلش گزینه مناسبی نیست.
در مقابل، HBF روی مرحله استنتاج (Inference) تمرکز دارد. در این فاز، وزنهای مدل «منجمد» شدهاند و عملاً فقط خواندنی (Read-only) هستند. در این حالت، سرعت پایین نوشتن در فلش دیگر اهمیتی ندارد و تراکم بالای حافظه فلش به مزیت تبدیل میشود.
به گفته هوشیک کیم، دادههای حجیم با نیاز به خواندن زیاد — مانند وزنهای ایستا با چندین میلیارد پارامتر یا KV Cache پیشمحاسبه شده — میتوانند به طور ایمن در لایهی HBF قرار گیرند. این رویکرد به تقویت روشهای مدیریت حافظه کمک میکند، مشابه آنچه در تلاشها برای کاهش ۸ برابری حافظه KV Cache با استراتژیهای کوانتش مشاهده شده است. این کار باعث میشود HBM فقط به عنوان یک «تختهسیاه سریع» (High-speed scratchpad) برای محاسبات لحظهای عمل کند و جریان دادهها در طول درخواست کاربر بهینه شود. جیم هندی این رویکرد را یک کاربرد منطقی از سیستمهای کشینگ (Caching) ابتدایی برای بارهای کاری استنتاج میداند.
استانداردسازی صنعتی
بر اساس مستندات، استقرار گسترده این فناوری چندین سال زمان میبرد و عرضه تجاری HBF حداقل یک سال دیگر اتفاق میافتد. در ۲۵ فوریه ۲۰۲۶، شرکتهای Sandisk و SK Hynix همکاری مشترکی را برای استانداردسازی HBF در قالب یک جریان کاری اختصاصی در پروژه Open Compute Project (OCP) آغاز کردند. این اقدام تضمین میکند که سختافزار مذکور بتواند در مشخصات استاندارد مراکز داده در سراسر جهان ادغام شود، هرچند هنوز زمانبندی دقیقی برای انتشار این استاندارد تعیین نشده است.
در حالی که HBM در حال حاضر محصولی با حاشیه سود بالاتر است و درآمدهای رکوردشکنی را برای SK Hynix به ارمغان آورده، کیم HBF را یک ابزار مکمل میبیند. با کاهش گلوگاههای ظرفیتی HBM بدون قربانی کردن سرعت تحویل داده، HBF میتواند تعداد شتابدهندههای مورد نیاز برای اجرای مدلهای مقیاسبزرگ را کاهش دهد. این بهینهسازی در سطح سختافزار، یادآور پیشرفتهای اخیر در پردازش است که در آن روش DFlash توان عملیاتی تراشههای Blackwell انویدیا را ۱۵ برابر کرد.
برای مدیران کسبوکار، این تغییر به این معناست که هزینه مقیاسبندی استنتاج هوش مصنوعی ممکن است به شدت کاهش یابد. با کاهش تعداد کل GPUهای مورد نیاز برای «زنده نگه داشتن» یک مدل عظیم در حافظه، اپراتورها میتوانند هم هزینههای سرمایهای (CapEx) و هم قبوض برق خود را پایین بیاورند.
اگر HBF با موفقیت مکمل HBM شود، مانع اصلی برای استقرار مدلهای تریلیون-پارامتری از «هزینه سختافزاری» به «بهینگی الگوریتمی» تغییر میکند. صنعت در حال حرکت به سوی یک سلسلهمراتب حافظه لایهای است که در آن تراکم و سرعت دیگر یک بازی با مجموع صفر (Zero-sum trade-off) نیستند.
گام بعدی شما
- اگر مدیر زیرساخت هستید، نقشه راه جایگزینی بخشی از VRAM با لایههای ذخیرهساز سریع را در استراتژی ۲۰۲۷ خود بگنجانید.
- روی بهینهسازی مدلها برای معماریهای حافظه لایهای (Tiered Memory) تمرکز کنید تا از کاهش هزینههای استنتاج بهرهمند شوید.
- تغییرات استانداردهای OCP را برای ادغام سختافزارهای HBF در سرورهای نسل جدید دنبال کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو