
آیا یک کارت گرافیک RTX 3090 میتواند مدل بازیابی تخصصی بسازد که از غولهای هوش مصنوعی دنیا قدرتمندتر باشد؟ در ۲۶ اوت ۲۰۲۶، Hugging Face جزئیاتی را منتشر کرد که نشان میدهد بهروزرسانی نسخه ۶.۰ کتابخانه Sentence Transformers، آموزش مدلهای بردار معنایی (Embedding) چندبرداری را ممکن کرده است؛ مدلهایی که در حوزههای تخصصی مثل پزشکی، مدلهای متراکم استاندارد را شکست میدهند.
بیشتر سامانههای بازیابی، کل یک سند را در یک بردار واحد فشرده میکنند. این کار شبیه این است که بخواهید تمام جزئیات یک کتاب ۱۰۰ صفحهای را در یک جمله خلاصه کنید؛ در نتیجه، جزئیات ظریفی که برای پرسوجوهای پیچیده حیاتی هستند، حذف میشوند. این همان محدودیتی است که در پوشش قبلی ما دربارهی RollTab مشاهده کردیم، جایی که دقت در لحظه نیازمند معماریهای ترنسفورمر تخصصی برای مدیریت جریانهای داده خاص بود. مدلهای چندبرداری یا مدلهای سبک ColBERT با اختصاص یک بردار مجزا برای هر توکن (Token) — یعنی تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — این مشکل را حل میکنند و سیگنالهای دقیقی را حفظ میکنند که مدلهای تکبرداری دور میاندازند. این رویکرد در واقع پاسخی به چالشهای فشردهسازی در متدهای سنتی RAG است که پیشتر بررسی کرده بودیم.
معماری تعامل دیرهنگام
برخلاف بردارهای متراکم، مدلهای چندبرداری از مکانیزم «تعامل دیرهنگام» (Late Interaction) استفاده میکنند. در اینجا بهجای یک ضرب داخلی ساده بین دو خلاصه، سیستم از عملگر MaxSim استفاده میکند. به این ترتیب، هر توکن در پرسوجو، بهترین توکن متناظر خود را در سند پیدا میکند و این امتیازها با هم جمع میشوند.
این رویکرد برای اسناد طولانی بسیار قدرتمند است. بسیاری از مدلهای رایج، متن را در ۱۸۰ تا ۵۱۲ توکن قطع میکنند و بقیه دادهها را بیصدا دور میریزند. در یک ارزیابی پزشکی با اسنادی که بهطور میانگین ۹۴۱ توکن داشتند، این قطعشدگی باعث کاهش ۰.۲۴ در معیار NDCG@10 شد. توسعهدهندگان اکنون میتوانند با آموزش یک مدل سفارشی، طول سند را دقیقاً مطابق نیاز دادههای خود تنظیم کنند تا هیچ دادهای در اثر محدودیتهای پیشفرض حذف نشود.
زمینه: چرا تنظیم دقیق مدلهای چندبرداری ضروری است؟
تنظیم دقیق (Fine-tuning) — که مثل وقتی است به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — حیاتی است؛ چون واژگان، سبک پرسوجو و مفهوم «مرتبط بودن» در هر حوزه بهشدت متفاوت است. مدلی که برای جستوجوی وب بهینه شده، در بررسی اسناد حقوقی، جستوجوی کد یا مرور متون علمی شکست میخورد. مدلهای چندبرداری به دلیل تطبیق توکنبهتوکن (بهجای میانگینگیری)، به مقدار کمی دادههای تخصصی واکنش بسیار بهتری نشان میدهند.
علاوه بر این، اکثر مدلهای منتشرشده برای متون کوتاه پیکربندی شدهاند. نقاط بازرسی (Checkpoints) کلاسیک ColBERT معمولاً در ۱۸۰ یا ۳۰۰ توکن قطع میشوند. وقتی اسناد طولانی باشند، این مدلها پیش از امتیازدهی، بخش بزرگی از متن را بیصدا دور میریزند. این یک شکست سیستمی در حوزههایی مثل پزشکی یا حقوق است، جایی که پاسخ ممکن است در اعماق یک سند طولانی نهفته باشد.
زمینه: انطباق با حوزههای تخصصی
به نقل از مستندات Hugging Face، مدلهای عمومی اغلب روی دادههایی مثل MS MARCO آموزش دیدهاند که بهندرت از چند صد توکن فراتر میروند. این موضوع باعث ایجاد یک سوگیری سیستمی به سمت بازیابی متون کوتاه شده است. برای مثال، شرکت LightOn در بازیابی کدها با همین پویایی مواجه شد؛ آنها دریافتند که مدل عمومی LateOn برای این کار ناکافی است و همین موضوع منجر به توسعه مدل تخصصی LateOn-Code برای آن حوزه شد.
چه هدف شما متون پزشکی باشد و چه اسناد حقوقی، مالی یا مستندات داخلی شرکت، مدلهای رسمی برای هر گوشه از تخصصها وجود ندارند. بهروزرسانی نسخه ۶.۰ اجازه میدهد این مدلهای تخصصی را در عرض چند ساعت و تنها با یک GPU خانگی بسازید، بهجای اینکه به مدلهای عمومی تکیه کنید که سیگنالهای حیاتی حوزه شما را در اثر میانگینگیری حذف میکنند.
جزئیات دستورالعمل تنظیم دقیق
آموزش یک MultiVectorEncoder شامل چندین جزء کلیدی است: مدل، مجموعهدادهها، توابع زیان، آرگومانهای آموزش، ارزیابها و کلاس Trainer. تمام اینها با دستور pip install -U "sentence-transformers[train]" اجرا میشوند.
انتخاب و پیکربندی مدل
- نقاط شروع: انتخاب نقطه شروع حیاتی است. نقاط بازرسی «بدون نظارت» (Unsupervised) — مدلهایی که روی دادههای تقابلی مقیاسبزرگ آموزش دیدهاند اما هنوز روی بازیابی عمومی نظارت نشدهاند — بسیار بهتر از مدلهای نهایی با حوزههای جدید سازگار میشوند. نقاط بازرسی نهایی اغلب در طول آموزش دامنه یا بهسختی تغییر میکنند یا حتی دچار پسرفت (Regression) میشوند. اگر نقطه بازرسی پیشنظارتی در دسترس نباشد، بهترین گزینه بعدی، ایجاد یک لایه تصویر (Projection) تازه روی یک ستون فقرات قوی پیشآموزشدیده برای بازیابی است.
- ترنسفورمرهای پایه: شما میتوانید
MultiVectorEncoderرا روی هر ترنسفورمر پایهای (مثل ModernBERT-base) قرار دهید. این کار یک لایه Dense تصادفی اضافه میکند که بردارها را به ۱۲۸ بُعد کاهش میدهد، و سپس یک لایهMultiVectorMaskو یک لایهNormalizeرا دنبال میکند. آزمایشها نشان میدهد که یک لایه تصویر تازه رویAlibaba-NLP/gte-modernbert-baseمیتواند تنها با ۲۵ هزار جفت داده آموزشی، به دقتی در فاصله ۰.۰۳ از نقاط بازرسی موجود برسد. - برداشتن سقفها: برای جلوگیری از قطع متن، توسعهدهندگان باید
model[0].query_length = Noneوmodel[0].document_length = Noneرا تنظیم کنند. این کار به مدل اجازه میدهد از حداکثر طول توکنساز (مثلاً ۸۱۹۲ توکن برای خانواده mLateOn) استفاده کند. برای مثال، GTE-ModernColBERT-v1 با طول پرسوجوی ۴۸ و طول سند ۳۰۰ عرضه میشود؛ این محدودیتها باید برای متون طولانیتر برداشته شوند. - لیستهای حذف علائم: افزودن یک لیست حذف علائم نگارشی به ماژول
MultiVectorMaskمیتواند کیفیت را کمی بهبود بخشد و حجم ایندکس سند را ۹.۶٪ کاهش دهد. این کار با تنظیمmodel[2].skiplist_words = list(string.punctuation)و فراخوانیresolve_with_tokenizerانجام میشود.
دادهها و توابع زیان
- فرمت داده: سیستم از
datasets.DatasetیاDatasetDictاستفاده میکند. برای تست پزشکی، ۱ میلیون جفت داده از مجموعه MIRIAD استفاده شد (از مجموع ۴.۴ میلیون جفت موجود). فرمت معمولاً ساختار (پرسوجو، متن مرتبط) را دنبال میکند. بهطور پیشفرض، ستون اول به عنوان پرسوجو و ستونهای بعدی به عنوان سند در نظر گرفته میشوند. - تابع زیان: ابزار اصلی CachedMultiVectorMultipleNegativesRankingLoss است. این تابع با استفاده از GradCache، اندازه دسته (Batch Size) مؤثر را از محدودیتهای حافظه GPU جدا میکند و اجازه میدهد دستههای تقابلی بزرگ (مثلاً ۱۲۸) را با تکههای کوچک (مثلاً ۱۶) برای کنترل VRAM اجرا کنید. برای طولهای متغیر سند، میتوان از
mini_batch_num_tokensبرای بستهبندی تکهها بر اساس بودجه توکن (مثلاً ۱۵,۰۰۰ توکن) استفاده کرد. - تله مقیاس: برخلاف مدلهای متراکم که از
scale=20.0برای شباهت کسینوسی استفاده میکنند، توابع زیان چندبرداری بهصورت پیشفرض رویscale=1.0هستند. چون MaxSim امتیازات را در توکنهای پرسوجو جمع میکند، یک پرسوجوی ۳۲ توکنی میتواند امتیازی تا ۳۲ بگیرد؛ استفاده از مقیاس ۲۰.۰ باعث اشباع سافتمکس و نابودی گرادیانها میشود. - تقطیر دانش: برای کسانی که مدل معلم قدرتمندتری دارند، میتوان از
MultiVectorDistillKLDivLossبرای تقطیر دانش به مدل چندبرداری استفاده کرد.
آرگومانهای آموزش و ارزیابی
- بهینهسازی: نرخ یادگیری ۱e-4 مؤثرترین مقدار بود (پس از بررسی بازه 5e-6 تا 2e-4). آموزش روی ۵۱۲ توکن بهجای طول کامل، سرعت را ۲ برابر کرد اما حدود ۰.۰۱۵ از امتیاز NDCG@10 را کاهش داد.
- پرامپتها: آموزش نیازمند نگاشت صریح نشانگرهاست، مانند
[Q]برای سؤالات و[D]برای متون، تا آموزش با استنتاج (Inference) سازگار باشد. اینها از طریق آرگومانpromptsدرMultiVectorEncoderTrainingArgumentsارسال میشوند. - ارزیابها: از
MultiVectorInformationRetrievalEvaluatorاستفاده میشود. برای جلوگیری از اشباع امتیاز، توسعهدهندگان باید اسناد مزاحم (Distractors) — مثلاً اسناد آموزشی حذفتکرار شده — را اضافه کنند تا «زیرِ کاه» واقعبینانه باشد. در تست MIRIAD، استفاده از تنها ۱۰ هزار سند طلایی منجر به امتیازات بالای ۰.۹۷ شد، که افزودن ۱۹۰ هزار سند مزاحم برای پخش کردن امتیازات را ضروری کرد. - گزارشدهی: Trainer از
WandbCallback،TensorBoardCallbackوCodeCarbonCallbackاز طریق آرگومانreport_toبرای ردیابی معیارها و میزان انتشار کربن پشتیبانی میکند.
آموزش با مجموعهدادههای چندگانه
مدلهای برتر معمولاً نیاز به آموزش روی چندین مجموعه داده دارند. MultiVectorEncoderTrainer این قابلیت را با پذیرش دیکشنری از دادهها فراهم میکند. این سیستم اجازه میدهد برای هر مجموعه داده از توابع زیان متفاوتی استفاده شود و دو استراتژی نمونهبرداری از طریق multi_dataset_batch_sampler ارائه میدهد:
- ROUND_ROBIN: نمونهبرداری برابر از هر مجموعه تا اتمام یکی از آنها.
- PROPORTIONAL: نمونهبرداری متناسب با اندازه هر مجموعه، تا اطمینان حاصل شود که تمام نمونهها استفاده میشوند.
محکزنی نتایج
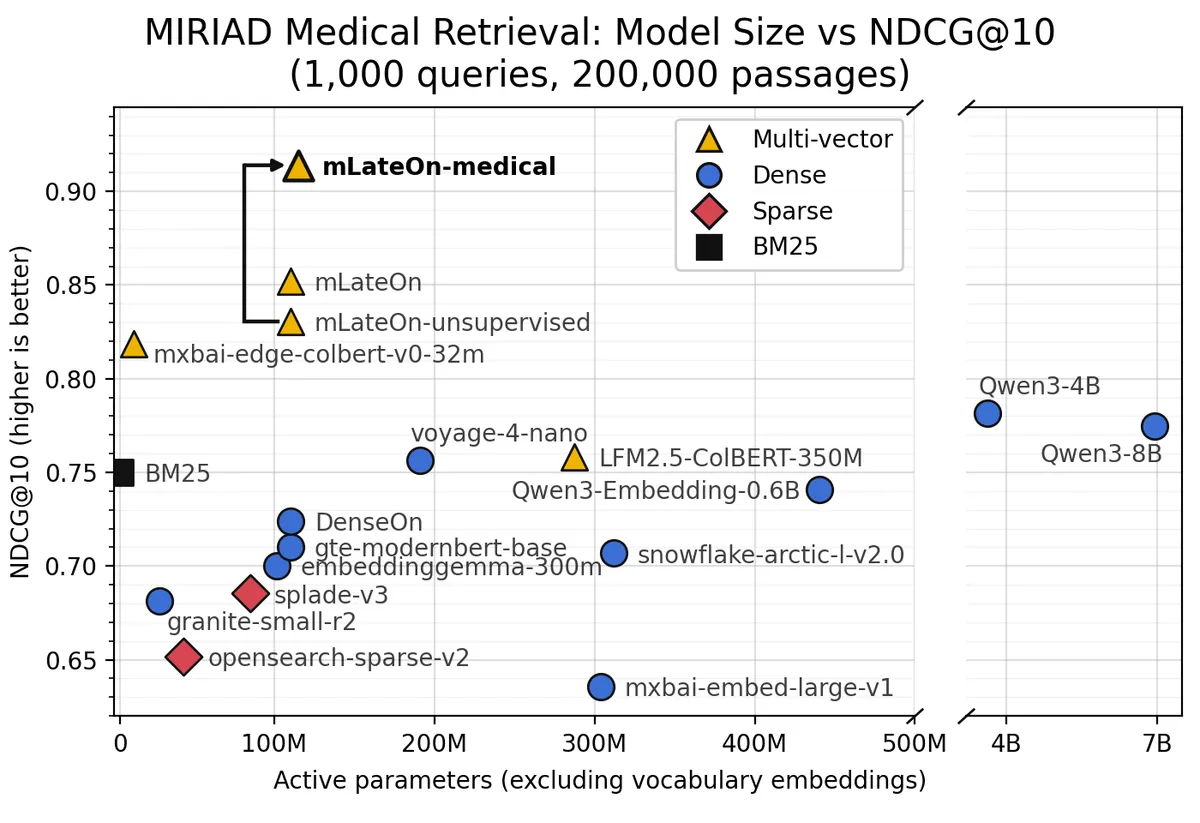
مدل حاصل یعنی mLateOn-medical در ۱۴.۵ ساعت روی یک RTX 3090 آموزش دید و اوج مصرف VRAM آن ۱۷.۵ گیگابایت بود. در تست روی ۲۰۰ هزار سند منحصربهفرد (۱,۰۰۰ سؤال خارج از مجموعه در مقابل ۱۰ هزار سند طلایی و ۱۹۰ هزار سند مزاحم)، این مدل توانست مدل Zero-shot قدرتمندترین را با ۰.۰۶۲+ در NDCG@10 شکست دهد.
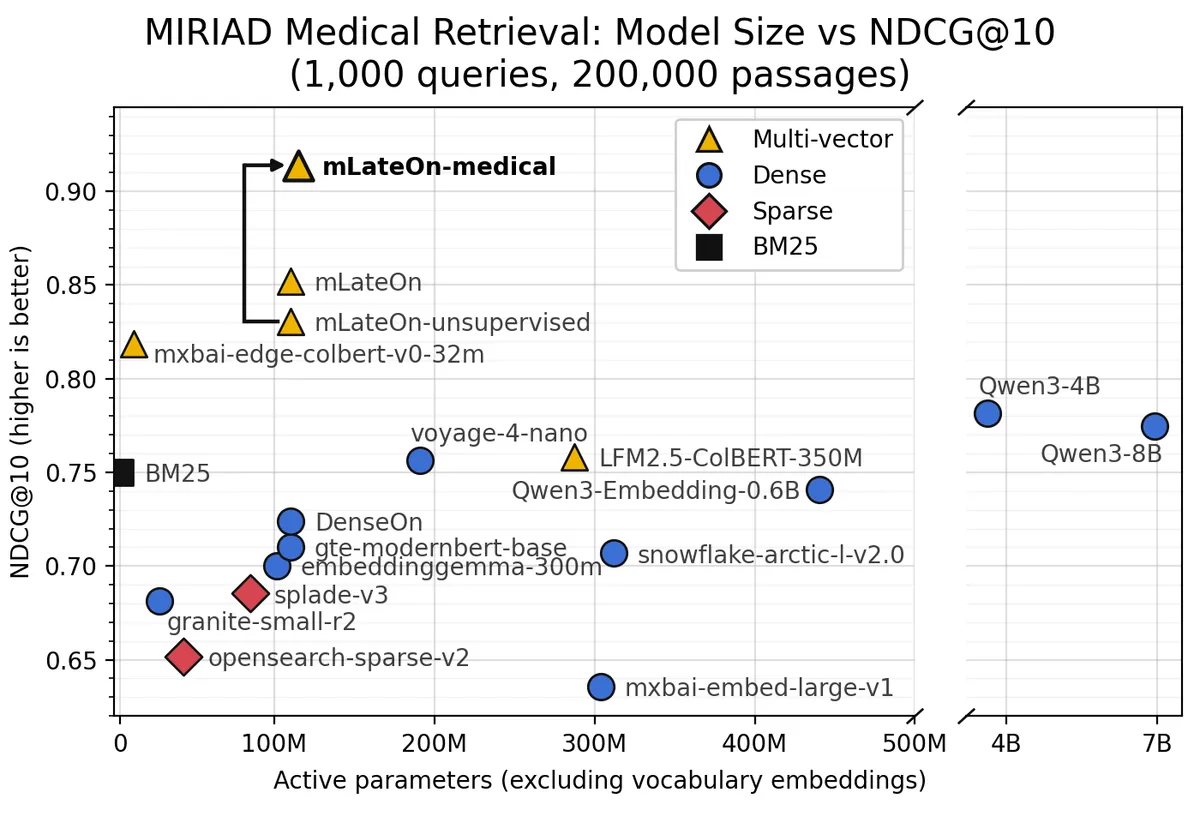
در حالی که مدل متراکم عظیم Qwen3-Embedding-4B حدود ۳۳ برابر پارامتر فعال بیشتری دارد، باز هم با اختلاف ۰.۱۳ از مدل چندبرداری تنظیمشده عقب ماند. حتی نسخه 8B مدل Qwen3 هم امتیاز کمتری گرفت. این ثابت میکند که در کارهای بازیابی، معماری و تنظیم تخصصی بسیار مهمتر از تعداد خام پارامترهاست.
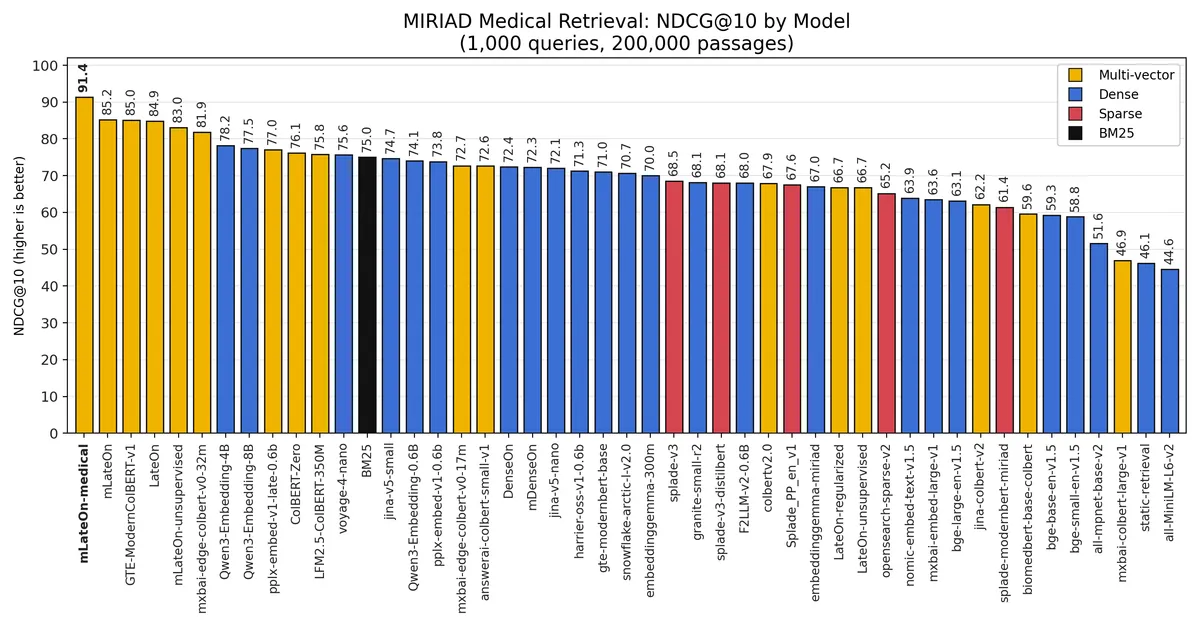
جالب است که BM25 بهطور شگفتانگیزی خوب عمل کرد و هر مدل پراکنده (Sparse) و اکثر مدلهای متراکم را شکست داد. احتمالاً به این دلیل که سؤالات MIRIAD از خود متون تولید شدهاند و همپوشانی واژگانی بالایی وجود دارد که BM25 با طول متن نامحدود خود میتواند از آن بهره ببرد؛ اما این برتری در دادههایی با همپوشانی واژگانی کمتر، تکرار نخواهد شد.
حل مشکل حجم ایندکس
عیب اصلی مدلهای چندبرداری، حجم ایندکس است. ذخیره یک بردار برای هر توکن در ۲۰۰ هزار سند، ۴۵ گیگابایت فضا در حالت fp16 اشغال کرد، در حالی که مدل متراکم کمتر از ۱ گیگابایت نیاز داشت. اما دو راه برای حل این مشکل وجود دارد:
۱. تجمع توکنها: استفاده از HierarchicalTokenPooling برای خوشهبندی بردارها و ذخیره میانگین خوشهها. کاهش تعداد بردارها به یکچهارم حجم اصلی (۱۱.۲ گیگابایت) تنها امتیاز را به ۰.۸۹۹۱ کاهش داد. نصف کردن تعداد بردارها تنها ۰.۰۰۳۳ در NDCG@10 هزینه داشت.
۲. کوانتیزاسیون (Quantization): پیادهسازی fast-plaid با کوانتیزاسیون باقیمانده ۱ بیتی، شناسههای مرکزیت ۱۷ بیتی فشرده و شناسههای سند ۱۸ بیتی. این کار حجم ایندکس را به ۳.۳۷ گیگابایت (کاهش ۱۳ برابری) رساند در حالی که دقت ۰.۸۹۸۴ در NDCG@10 حفظ شد.
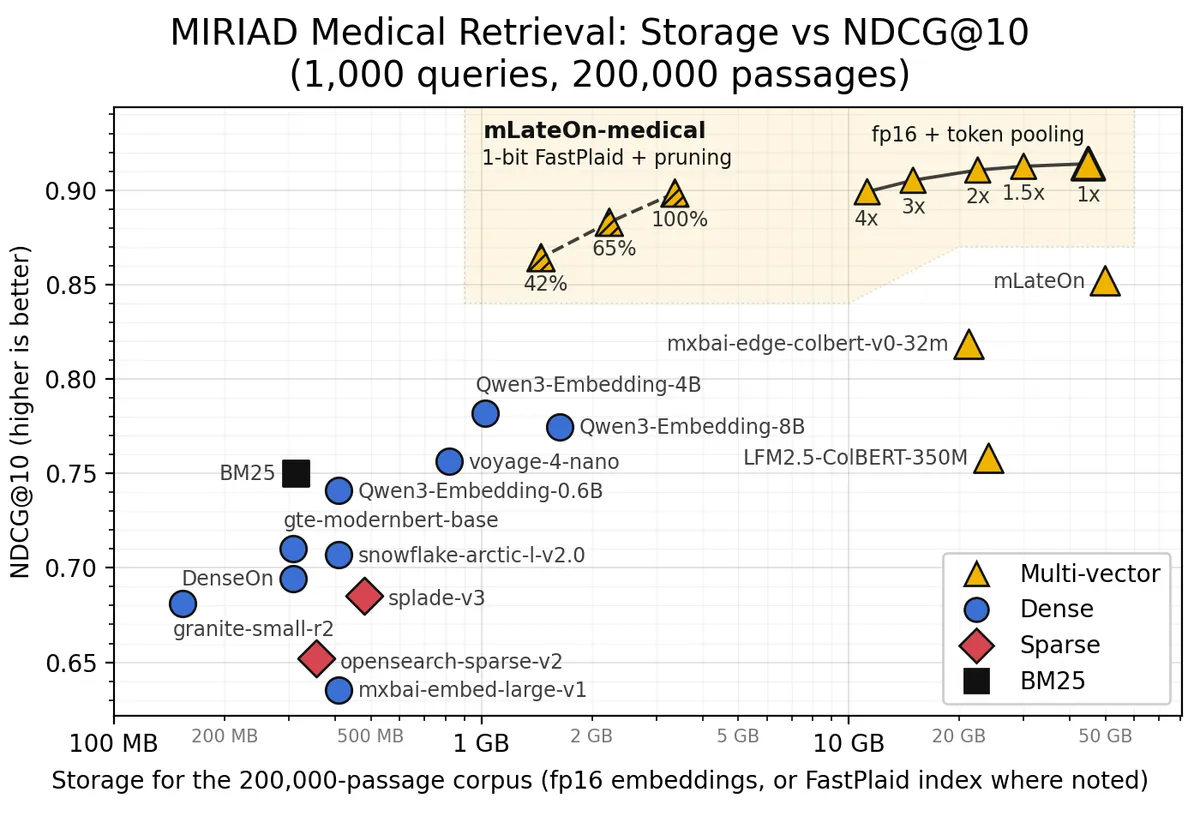
هرس کردن بیشتر میتواند حجم را به ۱.۴۵ گیگابایت (حفظ ۴۲٪ بردارها) برساند که حتی از بردارهای fp16 مدل Qwen3-Embedding-8B (۱.۶۴ گیگابایت) کوچکتر است، در حالی که امتیاز ۰.۰۸۹۵ بالاتری میگیرد.
تحلیل تحریریه
این تغییر سیگنالی است برای فاصله گرفتن از رویکرد «یک اندازه برای همه» در مدلهای Embedding. سالهاست که صنعت بر مدلهای متراکم عظیم تکیه کرده و فرض کرده است که مقیاس، شکافهای دامنه را پر میکند. این شواهد نشان میدهد که برای حوزههای حساس — پزشکی، حقوقی یا مالی — یک مدل کوچک با تعامل دیرهنگام که روی چند هزار جفت داده تخصصی آموزش دیده، مؤثرتر از یک مدل عمومی با میلیاردها پارامتر است.
برای متخصصان، این موضوع سد ورود را پایین میآورد. شما دیگر برای ساخت یک بازیاب در سطح جهانی به کلاستر GPU نیاز ندارید؛ یک کارت گرافیک خانگی و چند ساعت آموزش میتواند اکنون مدلهای بزرگ صنعت را شکست دهد. برای کسانی که بودجه کمتری دارند، آزمایشهای مقیاسبندی نشان میدهد که ۱۰۰ هزار جفت داده (۷۵ دقیقه آموزش) به دقت ۰.۰۱۲ در NDCG@10 نسبت به اجرای کامل با یک میلیون جفت میرسد.
برای شروع پیادهسازی، توسعهدهندگان باید مستندات نسخه ۶.۰ Sentence Transformers را بررسی کنند و MultiVectorEncoder را روی مجموعهدادههای تخصصی خود تست کنند.



گفتگو