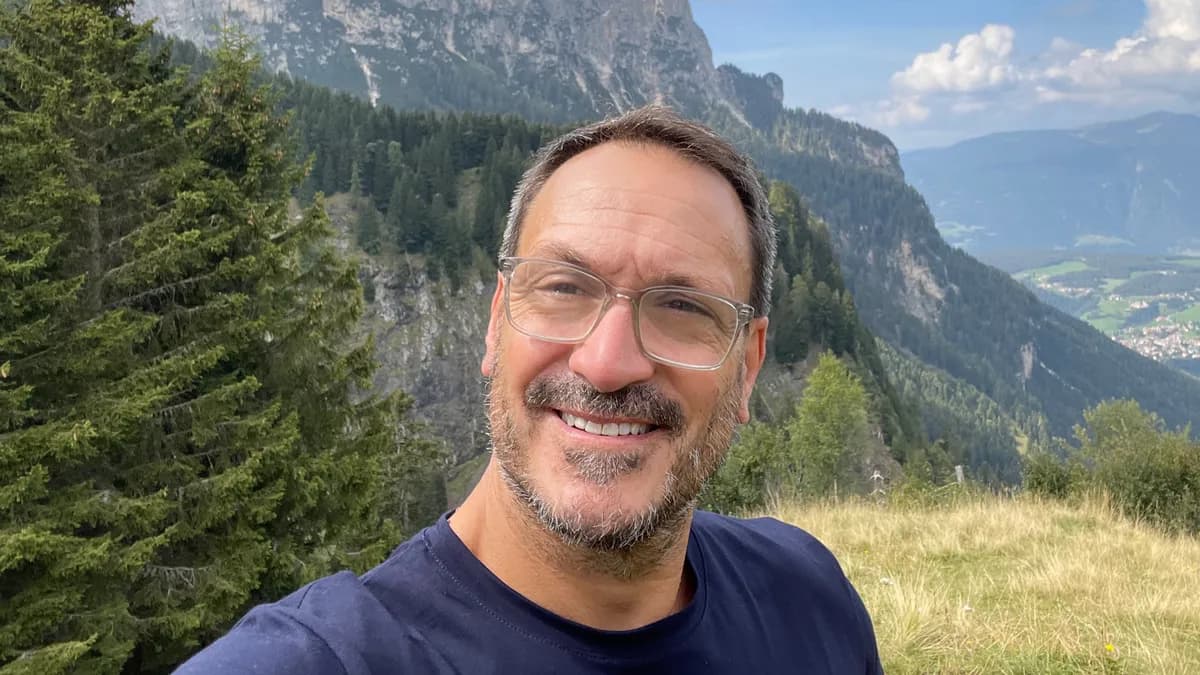
تصور کنید تنها با یک کلیک، دستنوشتههای شما به کتاب صوتی چندصدایی تبدیل شود که کیفیتش با استودیوهای حرفهای برابری میکند. Spoken که در سال ۲۰۲۴ توسط فیل مارشال (Phil Marshall) تأسیس شد، اکنون از یک گردشکار عاملمحور (Agentic) — شبیه به تیمی از دستیاران متخصص که هر کدام بخشی از پروژه را مدیریت میکنند — برای حذف موانع هزینهای و زمانی در تولید کتابهای صوتی استفاده میکند. این موانع سالها باعث شده بود بسیاری از دستنوشتهها هرگز به فرمت صوتی تبدیل نشوند.
فیل مارشال پیشینهای بسیار متنوع به این سرمایهگذاری میآورد. او همزمان پزشک، مخترع، کارآفرین حوزه فناوری و نویسنده داستانهای علمی-تخیلی است. مسیر شغلی او حوزههای گستردهای از جمله مراقبتهای بهداشتی، رسانههای دیجیتال، هوش مصنوعی و نوآوری در محصول را در بر گرفته است. پیش از تأسیس Spoken، او بیش از یک دهه به عنوان معاون استراتژی محصول در WebMD فعالیت کرد و همچنین سمت معاون ارشد مدیریت محصول در Press Ganey Associates را بر عهده داشت. علاوه بر این، او مؤسس استارتاپ JumperCut بود که در زمینه فناوری ویدئوهای مشارکتی فعالیت میکرد.
برای چندین دهه، بازار کتابهای صوتی به دو بخش تقسیم شده بود: تولیدات گرانقیمت با حضور گروهی از بازیگران (Full-cast) و نسخههای ارزانتر با یک راوی واحد. اکثر نویسندگان مستقل به دلیل هزینههای گزاف، توان مالی برای تولیدات چندصدایی را نداشتند، در حالی که نسخههای تکگوینده اغلب نمیتوانستند انرژی پویا و جذاب دیالوگهای شخصیتمحور را به درستی منتقل کنند. Spoken به عنوان یک راهکار ترکیبی وارد میدان شده است تا با استفاده از هوش مصنوعی، یک گروه بازیگران کامل را بدون نیاز به هزینههای سنگین استودیویی شبیهسازی کند.
خط لوله تولید عاملمحور
همانطور که در تحلیلهای قبلی ما دربارهی اتوماسیون محتوا اشاره کردیم، کلید موفقیت در این ابزارها، عبور از تولید ساده به سمت مدیریت هوشمند فرآیند است. این رویکرد با جایگزینی ابزارهای تکبعدی با جریانهای کاری هوشمند در حل مسائل عملیاتی همسو است. در Spoken، این اتفاق از طریق یک خط لوله تولید رخ میدهد.
طبق اعلام مارشال در مصاحبه با unite.ai، هسته اصلی این پلتفرم تنها سنتز صدا نیست، بلکه یک فرآیند «شدیداً عاملمحور» است که پیش از تولید اولین کلمه رخ میدهد. او اشاره میکند که حجم محاسبات هوش مصنوعی برای آمادهسازی روایت، حدود ۵ برابر بیشتر از حجم مورد نیاز برای تولید خودِ صدا است. این فرآیند که بیش از دو سال روی آن کار شده و در حال حاضر موضوع چندین درخواست ثبت اختراع (Patent) است، شامل لایههای تحلیل زیر است:
- مبانی داستان: سیستم ابتدا ژانر، زبان و قوس کلی روایت (Narrative Arc) را شناسایی میکند.
- ضربآهنگ و سبک: بر اساس سبک نوشتاری، لهجههای مورد نیاز و ریتم بیان (Delivery) را تعیین میکند.
- انسجام صحنه: هوش مصنوعی نحوه تعامل چندین شخصیت در یک صحنه خاص را نقشهبرداری میکند تا از زمانبندی و جریان درست گفتگو اطمینان حاصل شود.
- تخصیص شخصیت: سیستم بر اساس نقش و شخصیت هر فرد، «بهترین صدا» را برای او استخراج میکند.
مارشال این مرحله را «حالت جادویی» (Magic Mode) مینامد و آن را به ترکیب رنگها برای رسیدن به یک طیف خاص تشبیه میکند. پس از اینکه تحلیلها کامل شد، سیستم «لایه رنگ» یا همان روایت صوتی نهایی را اعمال میکند. این پلتفرم از تولیدات تکگوینده، دوگوینده و چندصدایی (Multi-cast) پشتیبانی میکند.
برابری انسان و هوش مصنوعی در اجرا
برای سنجش کیفیت و اثربخشی این رویکرد، مطالعهای توسط Edison Research خروجیهای چندصدایی Spoken را با نسخههای انسانی تکگوینده مقایسه کرد. نتایج یک شکاف ظریف در ادراک شنوندگان را نشان داد:
- صحنههای شخصیتی: تولیدات چندصدایی Spoken در صحنههایی که محوریت آنها دیالوگ و تعامل شخصیتها بود، امتیازات بالاتری دریافت کردند.
- بخشهای توصیفی (Exposition): در پاساژهای غیردیالوگی و روایتهای کلی، گویندگان انسانی عملکرد بهتری داشتند.
مارشال این تفاوت را به «دینامیکهای» موجود در هوش مصنوعی نسبت میدهد. در حالی که یک گوینده انسانی تکنفره ظرافتهای بینظیری در تغییر لحن دارد، سیستم چندصدایی هوش مصنوعی واقعگرایی را از طریق تنوع طنین صداها (Timbres) و تعاملات بین صداهای مختلف ایجاد میکند. او معتقد است با افزایش دینامیکهای صوتی در هوش مصنوعی، فاصله کیفیت در بخشهای توصیفی نیز به سرعت پر خواهد شد.
ادراک و پذیرش کاربران
مطالعه Edison Research همچنین تغییر قابلتوجهی را در پذیرش کاربران بر اساس میزان مواجهه نشان داد. در ابتدا، تنها ۳۱٪ از شرکتکنندگان علاقه کلی خود را به کتابهای صوتی روایتشده توسط هوش مصنوعی ابراز کردند. اما زمانی که شرکتکنندگان صدای واقعی را شنیدند، دادهها تغییر کرد:
- تست کور (Blind Testing): ۶۵٪ از شرکتکنندگان اعلام کردند که حاضرند کل یک کتاب صوتی را با روایتی که شنیدهاند گوش دهند، پیش از آنکه متوجه شوند این صدا متعلق به هوش مصنوعی است.
- نرخ تشخیص: تنها ۳۹٪ از کسانی که نسخه چندصدایی Spoken را شنیدند، شک کردند که صدا مصنوعی باشد؛ در حالی که ۳۵٪ از کسانی که نسخههای انسانی را شنیدند، گمان کردند شاید این صداها مصنوعی باشند.
- تغییر پس از افشا: پس از اینکه مشخص شد صداها توسط هوش مصنوعی تولید شدهاند، تمایل به گوش دادن از ۳۱٪ به ۴۳٪ افزایش یافت.
مارشال این نتایج را به عنوان یک معیار (Benchmark) میبیند و شرکت او فعالانه در حال بهینهسازی است تا شکاف موجود را بسته و به نرخ پذیرش ۶۵٪ برسد.
کنترل کاربر و اخلاقیات
با وجود اتوماسیون گسترده، Spoken فلسفه «انسان در حلقه» (Human-in-the-loop) را حفظ کرده است. نویسندگان کنترل مطلق بر تولید نهایی دارند و میتوانند تغییراتی در لحن احساسی، لهجهها و زمانبندیها ایجاد کنند.
ابزار خاصی به نام «Speak It» به نویسندگان اجازه میدهد تا خودشان نحوه بیان یک بخش را ضبط کنند تا دقیقاً نشان دهند که آن پاساژ چگونه باید ادا شود. سپس هوش مصنوعی آن شیوه بیان را شبیهسازی کرده و در صدای شخصیت انتخابی پیاده میکند. نویسندگان میتوانند از صداهای تولید شده سفارشی استفاده کنند، از بین بیش از ۱۰۰ گوینده حرفهای پرداختشده انتخاب کنند یا صدای خودشان را شبیهسازی کنند. همچنین، آنها مالکیت کامل اثر، نسخههای مستر و حقوق توزیع را حفظ میکنند.
در لایه اخلاقی، Spoken مدلی را به کار میگیرد که در آن آثار مکتوب برای آموزش سیستمهایش استفاده نمیشوند. این پلتفرم با گویندگان حرفهای، از جمله گویندگان ElevenLabs، همکاری میکند و هر بار که صدای آنها توسط یک نویسنده استفاده شود، به آنها دستمزد پرداخت میشود. همچنین سیستمهای شناسایی برای جلوگیری از شبیهسازی غیرمجاز صدای افراد مشهور تعبیه شده است. برای ناشرانی که کاتالوگهای بزرگی از آثار دارند، Spoken یک API ارائه میدهد تا تولید را در مقیاس بالا و با حفظ این استانداردهای اخلاقی گسترش دهند.
فلسفه اتوماسیون
رویکرد مارشال تحت تأثیر تجربه او در Conversa Health است؛ استارتاپی که در سال ۲۰۲۱ توسط Amwell خریداری شد. Conversa بر اتوماسیون ارتباطات شخصیسازی شده و پیگیریهای بالینی برای بخشهای پزشکی تمرکز داشت. مأموریت آن گسترش صدای تیم مراقبت بود تا راهنماییها و سوالات پیگیری را که یک سیستم بهداشتی بزرگ در صورت داشتن زمان، تلفنی انجام میداد، خودکار کند.
در ابتدا، این بات شخصیتی به نام «کیت» (Cate) داشت که از ضمیر اول شخص استفاده میکرد. اما مارشال در نهایت این شخصیت را حذف کرد و به ضمیر جمع «ما» تغییر داد، زیرا احساس میکرد تظاهر به انسان بودن، فریبکارانه است. او معتقد بود چون «کیت» یک شخص واقعی نبود، بیماران نباید فکر کنند که با یک انسان طرف هستند. این تجربه به او آموخت که راهکارهای خودکار میتوانند بدون تظاهر به انسان بودن، به عنوان یک امتداد اصیل از مراقبت انسانی عمل کنند.
او همین منطق را در Spoken به کار میبرد و با صداهای هوش مصنوعی به عنوان «شخصیتهای یک داستان» برخورد میکند، نه «انسانهای شبیهسازی شده». این تمایز باعث میشود از تضاد «دره وهمناک» (Uncanny Valley) که اغلب در عوامل هوش مصنوعی که سعی در شبیهسازی دلسوزی یا گپوگفتهای انسانی دارند دیده میشود، جلوگیری شود. چون آنها شخصیتهای یک داستان هستند، هیچ تظاهری به انسان بودن وجود ندارد.
هنر، علم و علمی-تخیلی
مارشال به عنوان نویسنده علمی-تخیلی «سخت» (Hard Sci-Fi)، در نقطه تلاقی هنر و فناوری زندگی میکند. او اغلب در داستانهایش محصولات و شرکتهایی را طراحی میکند که معتقد است روزی وجود خواهند داشت. برای مثال، او دامنه و کانسپت «کارخانه بادبادک» (The Kite Factory) را طراحی کرده است؛ شرکتی خیالی که تصور میکند روزی فناوری ضد جاذبه را خلق خواهد کرد و سیاره را متحول میکند. او حتی مجسمهای در مقابل خانهاش دارد که بر اساس لوگوی این کارخانه ساخته شده است.
نوشتههای او بازتابدهنده این باور است که اطلاعات به سمت بلادرنگ بودن، مشارکتی بودن و ادغام فیزیکی پیش میروند. او استدلال میکند که در سال ۲۱۰۰، مردم دیگر برای پرسیدن سوالات واقعی از تلفن استفاده نخواهند کرد. با این حال، او یک بیزاری شخصی از ایمپلنتها دارد. در پیشزمینه داستانهایش، ایمپلنتهای مغزی غیرقانونی شدند، زیرا ایلان ماسک ماهوارههای استارلینک را به ایمپلنتهای نورالینک متصل کرد تا پیامها را مستقیماً در مغزها پخش کند.
واگرایی هوش مصنوعی و هنر
مارشال متوجه واگرایی شدیدی بین واقعیت هوش مصنوعی و آینده تخیلیاش در مورد خلاقیت شده است. در حالی که او اتوماسیون سوالات مبتنی بر حقیقت را یک اجتناب ساده میبیند، اما «امور قلبی» مانند هنر، موسیقی و داستانها را متفاوت میبیند.
از آنجایی که هوش مصنوعی بر اساس الگوهای موجود آموزش میبیند، مارشال تأکید میکند که طبق تعریف، هرگز نمیتواند چیزی «واقعاً جدید» خلق کند. اگرچه مردم در حال حاضر از هوش مصنوعی برای آهنگسازی یا نوشتن داستان استفاده میکنند، اما او معتقد است این تنها به این دلیل ممکن است که هنر همیشه مجبور نیست منحصربهفرد باشد. در نتیجه، او باور دارد که در آینده، خلقهای انسانی که واقعاً «قالبها را میشکنند»، حتی ارزشمندتر و گرانبهاتر خواهند شد.
پیامدهای بازار و آینده داستانسرایی
این تغییر در هزینه تولید میتواند بازار کتابهای صوتی را به طور بنیادی گسترش دهد. با اقتصادی کردن تولیدات چندصدایی — که اکنون به جای هزینههای سرسامآور یک گروه انسانی، تنها با چند صد دلار و یک کلیک ممکن است — Spoken نه تنها کتابهای سنتی، بلکه سریالهای کوتاه، فنفیکشنها و خاطرات شخصی را هدف قرار داده است.
مارشال استدلال میکند که تحول بازار شاید کمتر درباره نبرد بین استعدادهای صوتی انسانی و هوش مصنوعی باشد و بیشتر درباره تکامل کنترل نویسنده/تولیدکننده و تغییر عادات شنیداری باشد. او آیندهای ترکیبی از فناوری و انسانها را متصور است.
در نهایت، هدف Spoken ارائه یک تجربه صوتی غوطهورکننده برای تقاضای رو به رشد داستانهای شخصیتمحور است. این پلتفرم با ترکیب تولید، نشر، کشف اثر، استریم، جامعهسازی و درآمدزایی، میکوشد تا صدا را به حالت غالب مصرف داستانها تبدیل کند. برای خواننده، این به معنای آیندهای است که در آن مرز بین یک داستان مکتوب و یک تجربه صوتی سینمایی از بین میرود و تمرکز از هزینه تولید به کیفیت خودِ داستانسرایی منتقل میشود.
گام بعدی شما
- اگر نویسنده هستید، بررسی کنید که آیا ساختار داستان شما برای تبدیل به فرمت چندصدایی (Multi-cast) مناسب است یا خیر.
- ابزارهای شبیهسازی صدا را برای ایجاد «نمونههای اولیه» (Prototype) از شخصیتهای داستانتان آزمایش کنید.
- مدلهای پرداخت به گویندگان در پلتفرمهای جدید را بررسی کنید تا از حقوق مالکیت فکری خود محافظت کنید.
اما تأثیر این اتوماسیون بر اقتصاد نشر دیجیتال بسیار عمیقتر است — به تحلیل ما دربارهی آینده مدلهای درآمدی محتوا مراجعه کنید.



گفتگو