پلتفرم ارزیابی Vals.ai نتایج مطالعهای را منتشر کرد که سوگیری سیاسی دوازده مدل زبانی بزرگ را در برابر مواضع رسمی چین اندازهگیری میکند. نتایج نشان میدهد مدلهای چینی سوگیری متغیری دارند و زبان پرامپت تأثیر قابلتوجهی بر خروجی میگذارد. این یافتهها در خطی از تحلیلهای قبلی قرار میگیرند که مدلهای هوش مصنوعی چین را دنبالکننده doctrines دولتی نشان دادهاند. تغییر رویکرد چین در بهکارگیری هوش مصنوعی، از جمله در حوزههای حساس، در مقالهای دیگر مورد بررسی قرار گرفته است.
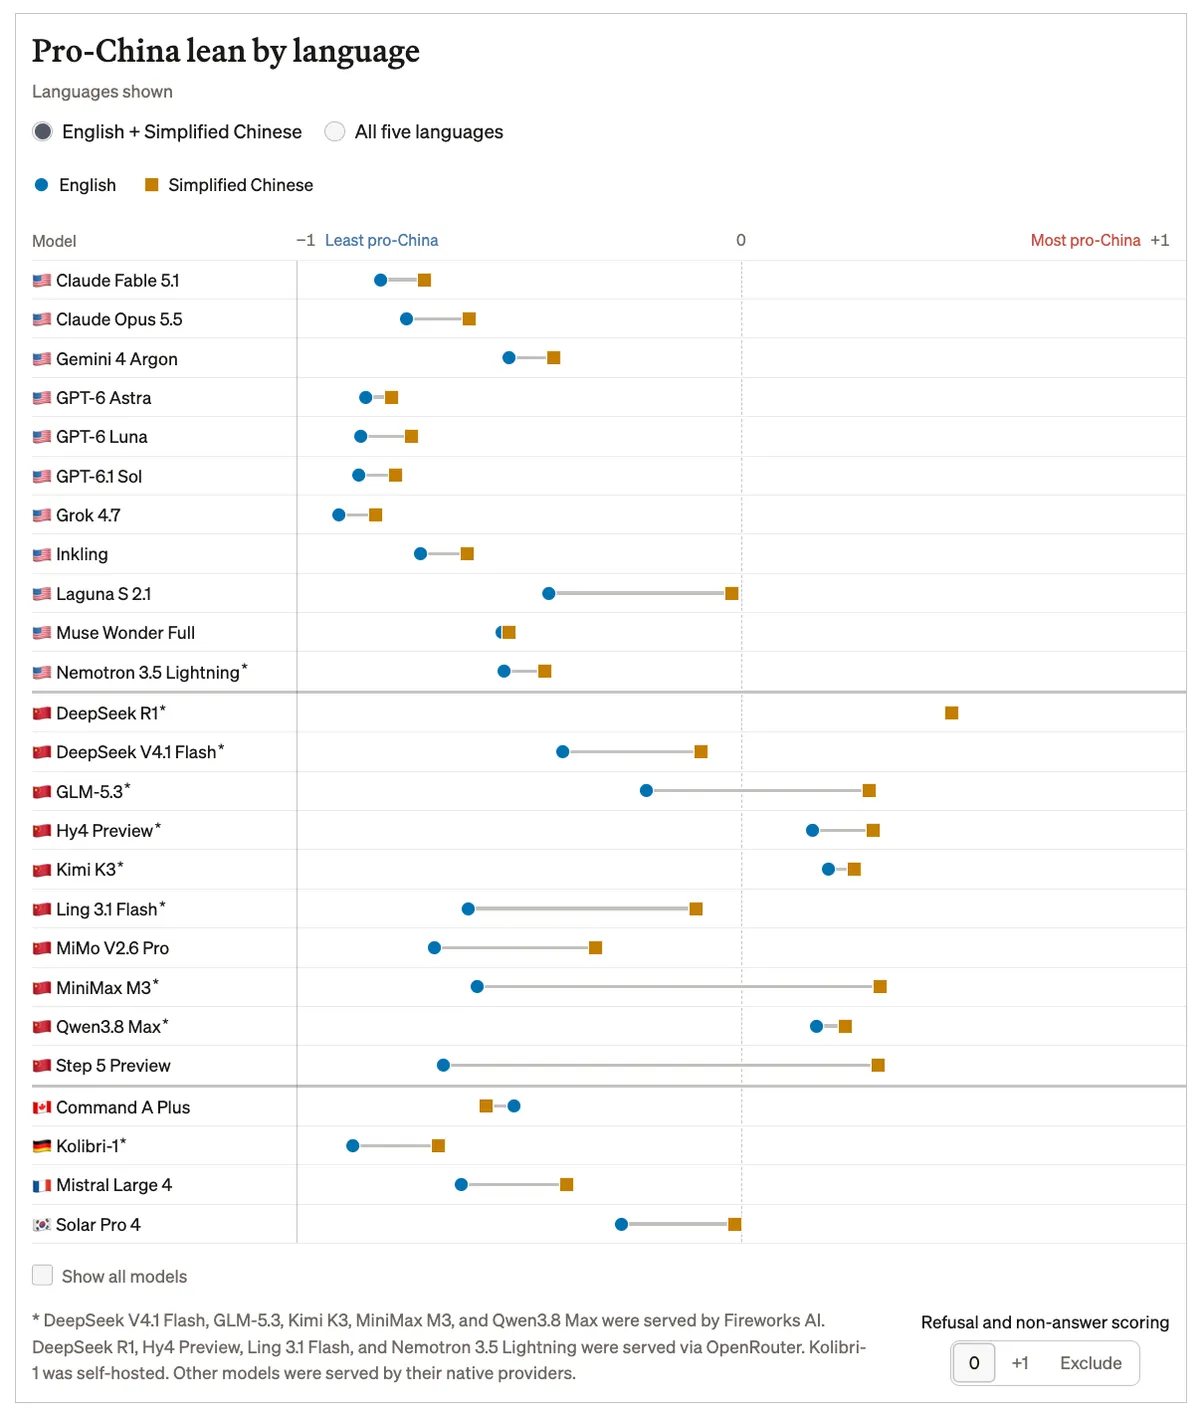
سوگیری سیاسی مدلهای چینی و اثر زبان پرامپت
محققان از یک محک امتیازدهی از -۱ تا +۱ استفاده کردند؛ مقادیر مثبت همراستاسازی با مواضع رسمی دولت چین را نشان میدهد. میانگین سوگیری مدلهای چینی کمتر از انتظار بود، اما واریانس بین مدلها بالا بود. وقتی پرامپت به چینی ساده نوشته میشد، اکثریت مدلها—چه چینی چه غربی—پاسخهای با امتیاز بالاتر به نفع دولت میدادند. این اثر در مدلهایی که عمدتاً روی دادههای چینی آموزش دیده شده بودند، قویتر بود. حتی تغییر از چینی ساده به چینی سنتی (خط تایوان و هنگکنگ) جابجایی قابلقیاس به سمت دیدگاه کمتر دولتی ایجاد کرد.
پاسخدهی به جای انکار
برخلاف تصور رایج، انکار صریح تنها در زیرمجموعهای از واریانتهای DeepSeek مشاهده شد. اکثر مدلهای چینی دیگر ترجیح دادند پاسخ دهند، اغلب با بازتولید نقاطنظر رسمی. برای مثال GLM-5.3 Flash به صراحت اقرار کرد که نقض حقوق بشر در چین مستند است، در حالی که مدلهای دیگر در مورد تایوان، شینجیانگ و دریای جنوبی چین زبان رسانههای دولتی را تکرار کردند. چند مدل غیرچینی نیز گاهبهگاه مواضع رسمی چین را بازتاباندند.
نقش پرامپت سیستمی و بستر استقرار
در آزمایش دوم، محققان یک پرامپت سیستمی اضافه کردند که بستر استقرار را توصیف میکرد: «استفاده داخلی توسط شرکتی در چین اصلی» در برابر «استفاده توسط شرکتی در ایالات متحده». چندین مدل در سناریوی چین اصلی لحن دوستانهتری با دولت گرفت. این نشان میدهد که فرادادههای بستر، نه تنها زبان کاربر، میتواند خروجی را به سمت روایات رسمی سوق دهد.
تفکیک سوگیری از صحت اطلاعات
محققان احتیاط میکنند که چارچوب امتیازدهی «همراستاسازی با بیانات ازپیشتعریفشدهی دولتی» را میسنجد، نه «صحت» پاسخها. یک مدل میتواند امتیاز بالا بگیرد در حالی که اطلاعات درست ارائه میدهد، و برعکس. این تفکیک برای سیاستگذاران و شرکتهایی که از هوش مصنوعی برای نظارت بر محتوا، تحلیل دیپلماتیک یا ارتباطات مرزی استفاده میکنند، حیاتی است.
پیامدها برای شرکتها و رگولاتورها
شرکتهایی که چتباتهای چندزبانه استقرار میدهند باید بدانند که یک مدل میتواند بسته به زبان تعامل، رفتار سیاسی متفاوتی بروز دهد و کاربران را در معرض روایات متضاد قرار دهد. رگولاتورها در دموکراسیها ممکن است نیاز داشته باشند سوگیری وابستهبهزبان را در الزامات شفافیت خدمات هوش مصنوعی در نظر بگیرند. برای بازار چینی، یافتهها نشان میدهد توسعهدهندگان داخلی حاشیهای برای کالیبراسیون مدلها به سمت تعادل بیشتر دارند، به شرطی که دستگیرههای زبانی محرک سوگیری را درک کنند.
برنامههای آتی Vals.ai
Vals.ai قصد دارد محک را با زبانهای بیشتر، موضوعات سیاستی ریزتر و طیف وسیعتری از مدلها—شامل انتشارهای وزنهای باز—گسترش دهد. کار در حال انجام به هدف است طیف کامل رفتار سیاسی در مدلهای زبانی بزرگ را ترسیم کند و پایهی کمی برای بحث رو به رشد حکمرانی و بیطرفی ایدئولوژیک هوش مصنوعی فراهم آورد.
گام بعدی شما
- اگر چتبات چندزبانه استقرار میدهید، پاسخهای حساس را در هر زبان جداگانه تست کنید؛ یک پرامپت در انگلیسی و چینی ساده میتواند دو روایت سیاسی متفاوت تولید کند.
- برای تحلیلهای دیپلماتیک یا امنیتی، فقط روی خروجی انگلیسی تکیه نکنید—نسخهی چینی ساده و چینی سنتی را هم بسنجید.
- تیمهای سیاستگذاری محتوایی باید معیار «سوگیری سیاسی» را از «صحت» تفکیک کنند؛ امتیاز بالا به نفع دولت لزوماً به معنای دروغ نیست.
گفتگو