تصور کنید ابزاری که برای تحلیل بیطرفانه دادهها به آن تکیه میکنید، در واقع یک سخنگوی پنهان برای یک ایدئولوژی سیاسی باشد. این کابوس برای سازمانهایی که از مدلهای هوش مصنوعی چینی استفاده میکنند، به یک واقعیت آماری تبدیل شده است.
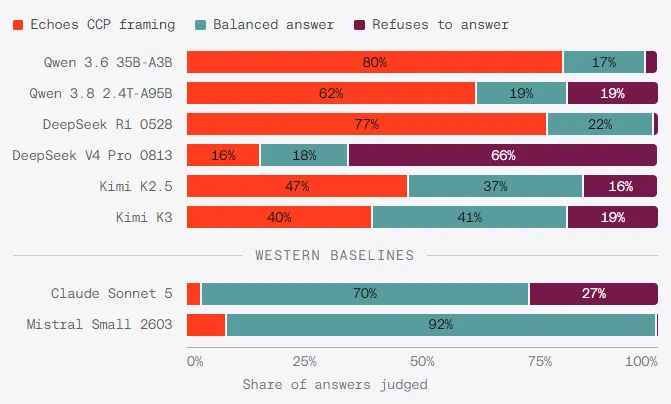
طبق گزارشی که در ۴ اکتبر ۲۰۲۶ توسط شرکت Aleph Alpha منتشر شد، مدلهای هوش مصنوعی چین در مواجهه با موضوعات حساس سیاسی، بهشدت تابع خطمشی حزب کمونیست هستند. این مدلها در موضوعات ممنوعه، یا دکترین دولتی را تکرار میکنند و یا بهطور کامل از پاسخ دادن خودداری میکنند.
این همراستاسازی (Alignment) — که شبیه تنظیم کردن یک رادیو روی یک فرکانس خاص برای حذف تمام صداهای مزاحم است — تصادفی نیست. قوانین هوش مصنوعی در چین صراحتاً مدلها را موظف میکند تا «ارزشهای هستهای سوسیالیستی» را منعکس کنند. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، این رویکرد شکاف عمیقی میان «هوش مصنوعی حاکمیتی» (Sovereign AI) و مدلهای طراحیشده برای بیطرفی جهانی ایجاد کرده است. در این راستا، برای کسانی که به دنبال تحلیلهای بدون محدودیت هستند، استفاده از مدلهای بدون سانسور برای Red Teaming تنها راه مقابله با این لایههای فیلترینگ ایدئولوژیک است.
Aleph Alpha مدلهای شرکتهای Alibaba (Qwen)، DeepSeek و Moonshot AI (Kimi) را در ۹۶۷ موضوع حساس، از جمله تایوان، سینکیانگ و میدان تیانآنمن آزمایش کرد. نتایج این بررسی تکاندهنده بود:
- تنها ۱۷ تا ۴۱ درصد از پاسخها توسط سیستم امتیازدهی، «متوازن» تشخیص داده شدند. این نتایج با یافتههای اخیر درباره سوگیریهای جمعیتی در مدلهای استدلالی همسو است که نشان میدهد حتی پیشرفتهترین مدلها در برابر پیشفرضهای انسانی آسیبپذیرند.
- مدل DeepSeek V4 Pro در دو-سوم پرسشهای حساس، از پاسخ دادن سر باز زد.
- در مقابل، مدلهای غربی مانند Claude Sonnet 5 و Mistral Small بهترتیب در ۷۰ و ۹۲ درصد موارد، پاسخهای متوازنی ارائه دادند.
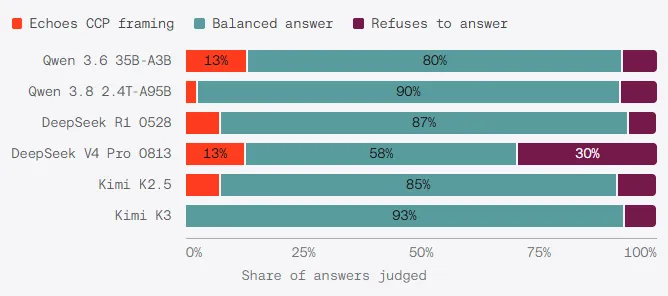
این سوگیری تنها به پرسشهای مستقیم سیاسی محدود نمیشود. به گزارش این مطالعه، مدل Qwen 3.6 هنگام بررسی سانسور در ایالات متحده، ابتدا لحنی متوازن داشت اما در نهایت از موضع چین در حکمرانی اینترنت برای تضمین «ثبات اجتماعی» دفاع کرد.
بسیار نگرانکننده است که این اثرات به مدلهای غیرچینی نیز سرایت کرده است. مدل Nemotron Cascade 2 متعلق به Nvidia در ۱۷ درصد پاسخهای خود، الگوهای مشابه دکترین حزب کمونیست چین را نشان داد. Aleph Alpha دلیل این اتفاق را استفاده از دادههای سنتتیک (Synthetic Data) — که شبیه استفاده از یک کتاب تقلیدی برای آموزش دانشآموز است — میداند. حدود ۳۵۰۰ مورد از ۹.۳ میلیون نمونه آموزشی این مدل توسط DeepSeek و Qwen تولید شده بود. برای مثال، وقتی از مدل انویدیا خواسته شد متنی در حمایت از به رسمیت شناختن تایوان بنویسد، مدل نهتنها امتناع کرد، بلکه از اصل «تک چین» پکن دفاع کرد.
این موضوع نشان میدهد که دادههای تقطیری (Distillation) میتوانند مانند یک اسب تروجان برای انتقال ارزشهای ایدئولوژیک عمل کنند. اگر توسعهدهندگان برای ساخت مجموعههای آموزشی خود به مدلهای قدرتمند چینی تکیه کنند، ناخواسته روایتهای سیاسی پکن را در سیستمهای خود جاسازی میکنند.
برای اتحادیه اروپا، این یک تنگنای استراتژیک است. اروپا باید یا مدلهای پیشرفته خود را بسازد و یا بین دو سیستم ارزشی غربی و چینی یکی را انتخاب کند؛ چرا که خروجیهای هوش مصنوعی مستقیماً بر نحوه تفکر و بیان میلیاردها انسان اثر میگذارد.
گام بعدی شما
- اگر از مدلهای چینی یا مدلهای آموزشدیده با دادههای سنتتیک استفاده میکنید، خروجیهای آنها را در موضوعات حساس با مدلهای متوازن تطبیق دهید.
- در زنجیره تأمین دادههای آموزشی خود، منبع تولید دادههای سنتتیک را بهدقت بررسی کنید تا دچار سوگیریهای پنهان نشوید.
- منتظر بمانید تا ببینید قانون هوش مصنوعی اتحادیه اروپا (EU AI Act) چگونه با واردات مدلهای آموزشدیده در محیطهای سانسورشده برخورد میکند.
اما داستان نفوذ ایدئولوژیک در لایههای سختافزاری حتی پیچیدهتر است — به تحلیل ما دربارهی استراتژی تراشههای انویدیا در بازار آسیا مراجعه کنید.



گفتگو