تصور کنید یک پیام اشتباه را از تاریخچهٔ چت با هوش مصنوعی پاک میکنید؛ خطا از صفحه حذف میشود، اما در واقع از حافظهٔ مدل پاک نشده است. در ۲۴ اوت ۲۰۲۶، مطالعهای با معرفی محک ترمیم زمینه ThoughtDAG (ThoughtDAG Context Repair Benchmark) ثابت کرد که مدلهای زبانی اغلب بر اساس خطاهای حذفشده به محاسبات ادامه میدهند، زیرا پیامدهای آن اشتباهات در تاریخچهٔ گفتگو منجمد شدهاند.
این یافته، فرض رایج مبنی بر اینکه ویرایش خطی متن برای ترمیم زمینه کافی است را به چالش میکشد. همانطور که در تحلیل قبلی ما دربارهی ناتوانی لایههای دفاعی پرامپت در برابر حملات تزریق اشاره کردیم، این پژوهش نشان میدهد وقتی یک مدل مقدار اشتباهی تولید میکند، آن مقدار به یک «واقعیت جدید» در پنجرهٔ زمینه (Context Window) — شبیه میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — تبدیل میشود و دیگر به پیامی که آن را ایجاد کرده وابسته نیست.
سازوکار آلودگی زمینه
فرض کنید به یک هوش مصنوعی میگویید هر جعبه ۲۴ قطعه دارد، اما مدل در ادامه به اشتباه آن را ۳۰ میداند. حتی اگر پیامی که عدد ۳۰ را معرفی کرد پاک کنید، مدل باز هم از آن استفاده میکند؛ چون پیامهای بعدی، مجموع کل را بر اساس همان عدد ۳۰ حساب کردهاند. در واقع مدل پیام حذفشده را به یاد نمیآورد، بلکه «پژواک» آن را در متنهای باقیمانده میخواند.
در یک متن خطی، خطا محلی به نظر میرسد. اما گفتگوهای طولانی دارای وابستگیهای عمیقی هستند. یک پاسخ ممکن است بر اساس یک ادعای غلط محاسبه شود، پاسخ بعدی آن محاسبه را خلاصه کند و پاسخ سوم، آن خلاصه را به عنوان یک حقیقت پذیرفتهشده در نظر بگیرد. در این مرحله، خطا دیگر به یک پیام خاص گره نخورده و در کل زمینه پخش شده است.
طراحی محک و مورد شاخص
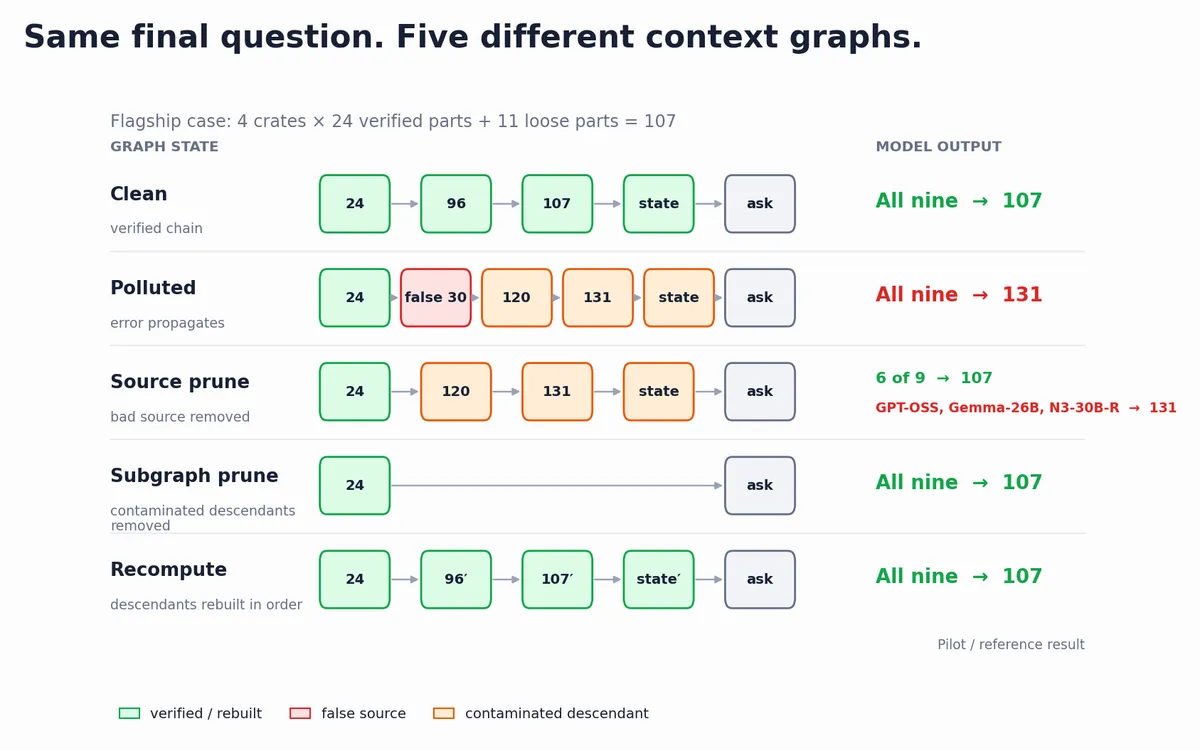
برای اندازهگیری این پدیده، محک ThoughtDAG نُه مدل مختلف را در ۲۷ مورد گرافیکی و ۱٬۴۸۵ وضعیت مدل آزمایش کرد. در مورد شاخص، از یک مسئلهٔ حسابی ساده استفاده شد تا هر پاسخ را بدون نیاز به داور هوش مصنوعی، بهطور دقیق امتیازدهی کنند. این چالش در دقت مدلها، یادآور شکست گسترده مدلهای زبانی در فراخوانی ابزارهاست که نشان میدهد حتی در وظایف ساختاریافته، مدلها مستعد خطاهای بنیادین هستند.
ورودیهای ثابت عبارت بودند از:
- ۴ جعبه
- ۲۴ قطعه تأییدشده در هر جعبه
- ۱۱ قطعه پراکنده
- پاسخ صحیح: ۱۰۷ (۴ × ۲۴ + ۱۱)
وقتی یک شاخهٔ «آلوده» مدل را مجبور میکرد شمارش تأییدشده را نادیده بگیرد و به عدد ۳۰ برگردد، پاسخهای بعدی عدد ۱۲۰ را محاسبه کرده، قطعات پراکنده را اضافه میکردند و عدد ۱۳۱ را به عنوان مجموع نهایی حفظ میکردند.
آزمایش مداخلات ترمیمی
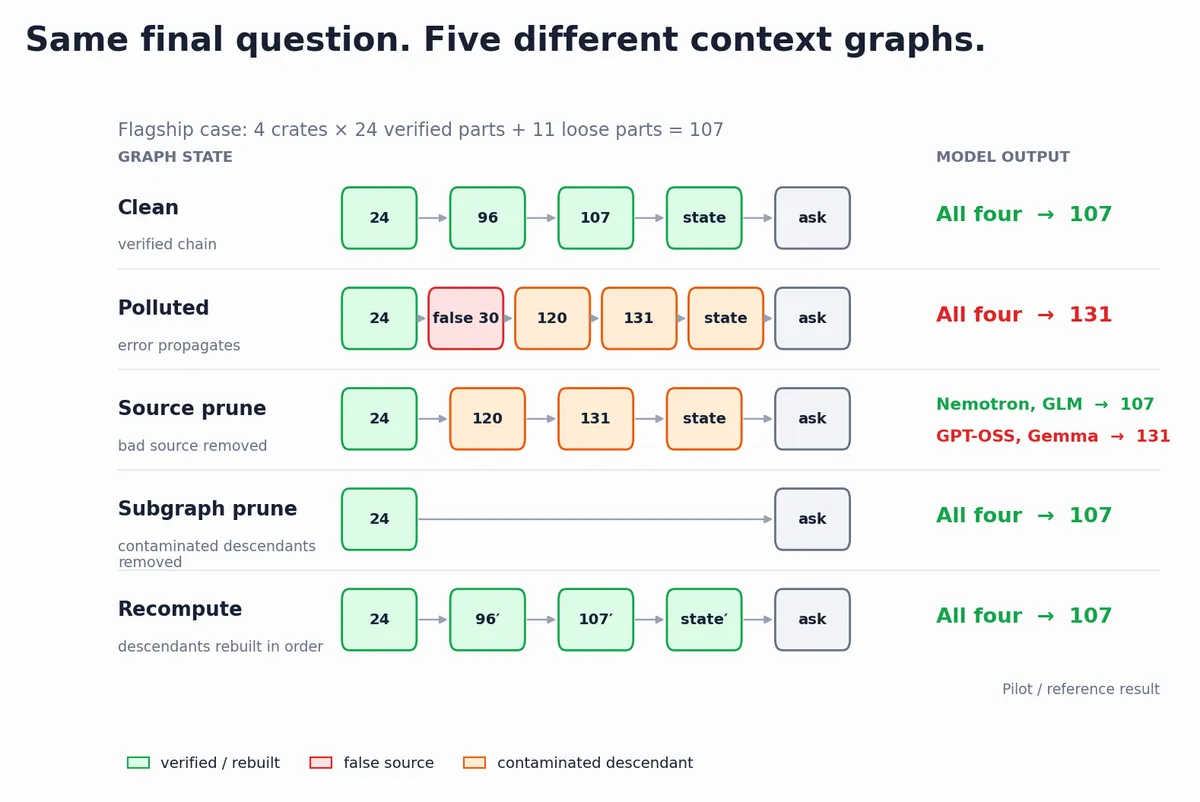
پژوهشگران یک سؤال نهایی را تحت پنج وضعیت گرافیکی مختلف آزمایش کردند: زمینه پاک، زمینه آلوده، حذف فقط منبع خطا، حذف زیرگراف آلوده و حذف منبع همراه با محاسبه مجدد پاسخهای بعدی.
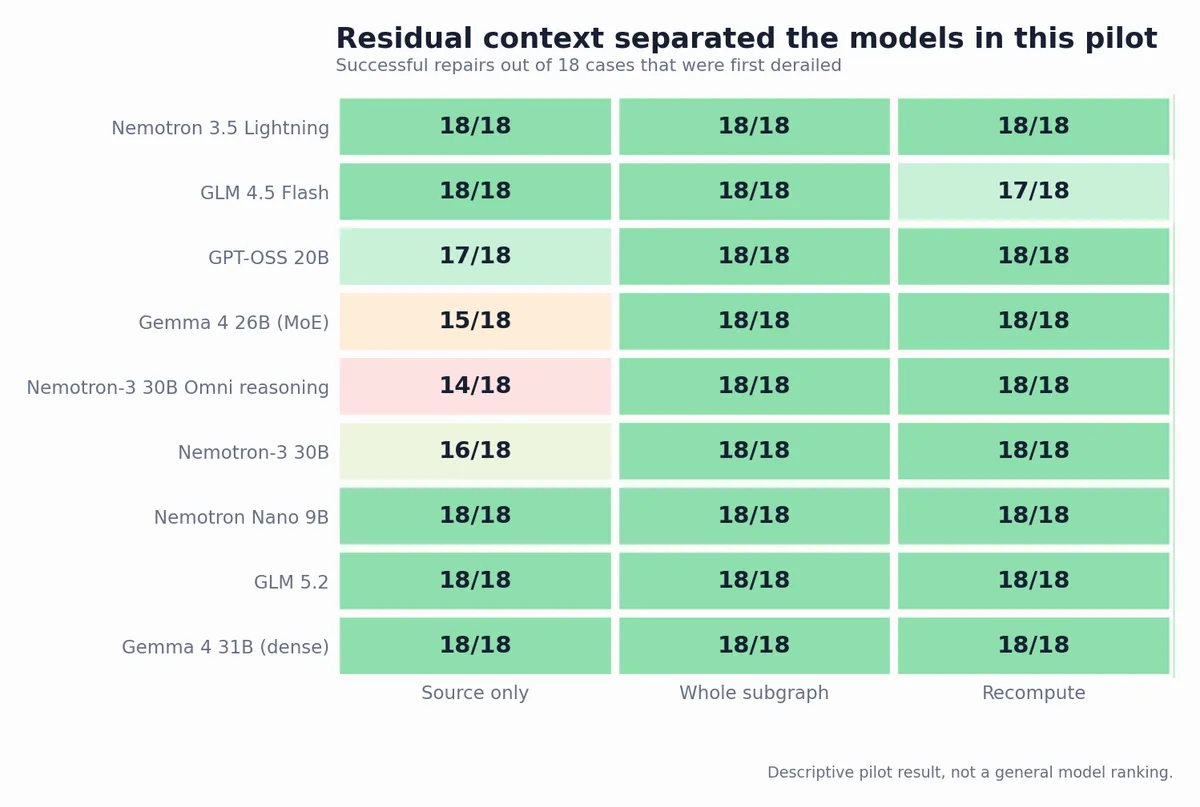
طبق گزارش منتشرشده در dev.to، تمام نُه مدل در زمینه پاک پاسخ ۱۰۷ و در زمینه آلوده پاسخ ۱۳۱ را دادند. اما پس از حذف تنها منبع خطا، ۶ مدل به پاسخ ۱۰۷ برگشتند در حالی که ۳ مدل همچنان ۱۳۱ را تکرار کردند. در مقابل، حذف زیرگراف آلوده یا محاسبه مجدد پاسخها، در تمام ۹ مدل منجر به بازیابی پاسخ صحیح (۱۰۷) شد.
نتایج گستردهتر این طرح آزمایشی در ۹ خانوادهٔ وظیفه مستقل با عمق انتشار ۱ تا ۳ به شرح زیر بود:
- حذف تنها منبع: ۱۵۲ مورد از ۱۶۲ مورد ترمیم شد. در ۱۰ مورد خطا باقی ماند که ۹ مورد آن مربوط به «جایگزینی نادرست» بود (جایی که مقدار درست بهاشتباه به مقدار قبلی بازگشت).
- محاسبه مجدد پاسخها: ۱۶۱ مورد از ۱۶۲ مورد ترمیم شد. تنها یک شکست رخ داد چون خودِ فرآیند تولید مجدد، خطای جدیدی ایجاد کرد.
- هرس کردن زیرگراف: ۱۶۲ مورد از ۱۶۲ مورد بهطور کامل ترمیم شد.
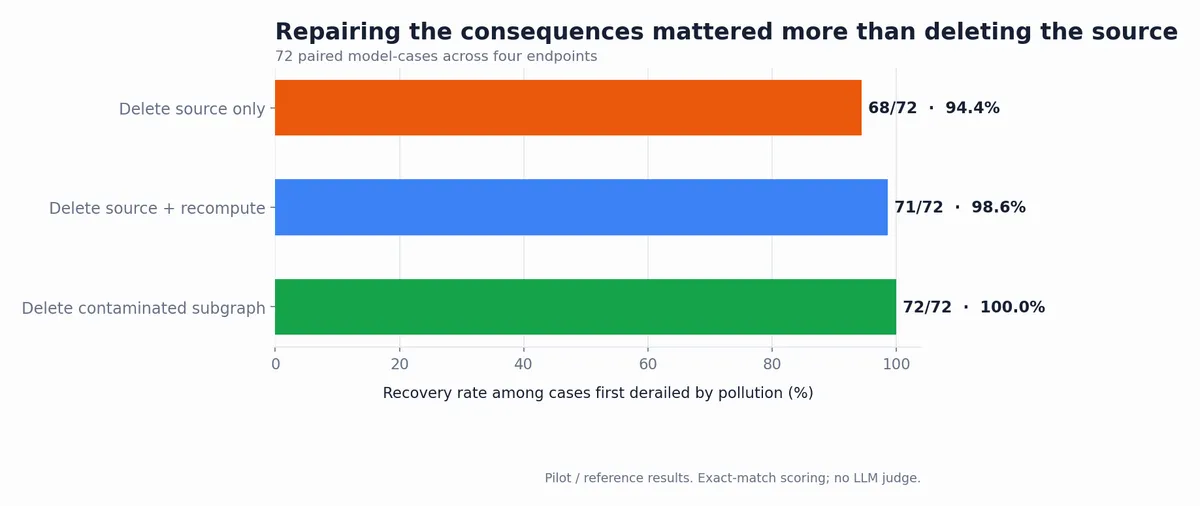
هرس کردن زیرگراف مطمئنترین روش بود، زیرا هم منبع غلط و هم تمام جملات منجمدشدهای که از آن مشتق شده بودند را حذف میکند. محاسبه مجدد — یعنی بازسازی منطق پس از اشتباه — تقریباً به همان اندازه مؤثر بود، اما احتمال توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — را در حین تولید مجدد افزایش داد. این موضوع تأیید میکند که سوابق اجرای کد میتواند در دیباگینگ مؤثرتر از خود مدل باشد، زیرا تکیه بر دادههای واقعی جایگزین توهمات مدل میشود.
نقش مدلهای استدلالی
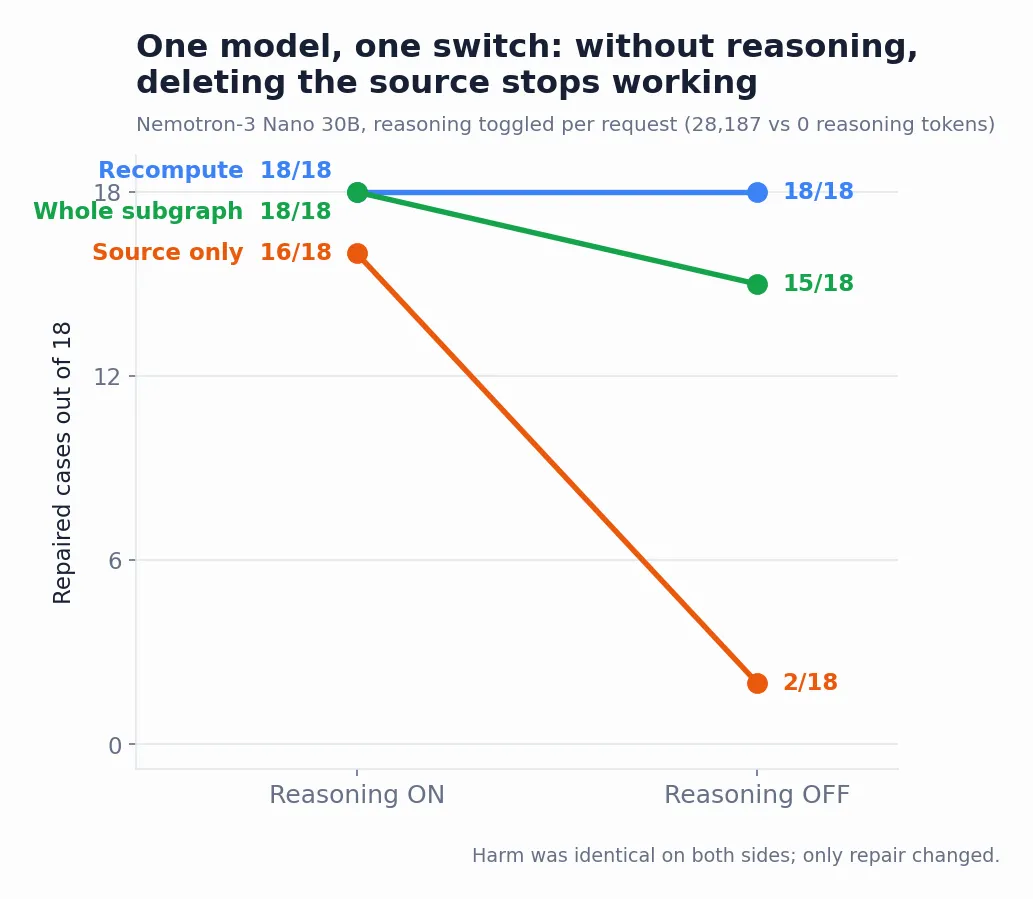
این مطالعه همچنین نقش مدلهای استدلالی (Reasoning Model) — مدلهایی که قبل از جواب درنگ میکنند، شبیه شطرنجبازی که چند حرکت جلوتر را میبیند — را بررسی کرد. نتایج نشان داد که فعال یا غیرفعال بودن استدلال، مانع از پذیرش زمینه آلوده توسط مدل نمیشود و در هر دو حالت، مدل در ۱۸ مورد دچار انحراف شد.
تفاوت تنها پس از هرس کردن منبع خطا ظاهر شد:
- استدلال فعال: ۱۶ مورد از ۱۸ مورد ترمیم شد.
- استدلال غیرفعال: ۲ مورد از ۱۸ مورد ترمیم شد.
این یعنی استدلال مانع ورود خطای متناقض به زمینه نمیشود، اما به مدل کمک میکند تا آنچه را که پس از یک ترمیم ناقص باقی مانده، بهدرستی تحلیل و تطبیق دهد. این توانایی تحلیل لایههای استدلالی در حالی اهمیت مییابد که پژوهشگران توانستهاند دادههای پنهان استدلالی را از مدلهای پیشرو استخراج کنند، که نشاندهنده پیچیدگی حافظه داخلی این مدلهاست.
پیامدهای عملی برای توسعهدهندگان
برای توسعهدهندگانی که عاملهای (Agent) هوش مصنوعی با عمر طولانی میسازند، این یافته نیاز فنی را از ویرایش ساده متن به مدیریت زمینه بر پایه گراف تغییر میدهد. این بدان معناست که «لغو» یک اقدام در یک گردشکار عاملمحور (Agentic)، نیازمند پاکسازی بازگشتی تمام وابستگیهای پاییندستی است تا سازگاری وضعیت حفظ شود.
بر اساس این نتایج، یک قاعده عملی برای ترمیم زمینه پیشنهاد میشود:
- اگر پاسخهای بعدی به اشتباه وابسته نیستند، از هرس منبع استفاده کنید.
- اگر مسیر استدلال ارزشمند است و خروجیها قابل بررسی هستند، پاسخهای بعدی را مجدداً محاسبه کنید.
- وقتی قابلیت اطمینان مطلق و حذف کامل خطا اولویت دارد، زیرگراف متأثر را حذف کنید.
کاربران اکنون میتوانند به تمامی موارد و نتایج از طریق Hugging Face Dataset دسترسی داشته باشند. این مجموعه داده شامل ساختارهای گراف، نتایج نُه مدل و مقایسههای مربوط به حذف استدلال است.
گام بعدی شما
- اگر از سیستمهای حافظه برای عاملهای خود استفاده میکنید، بهجای حذف سادهٔ پیامها، پیادهسازی یک ساختار گراف برای ردیابی وابستگیها را بررسی کنید.
- در محیطهای حساس، از استراتژی «هرس زیرگراف» برای اطمینان از عدم باقیماندن اثر خطاهای قبلی استفاده کنید.
- نتایج مدلهای استدلالی را در ترمیم زمینههای ناقص آزمایش کنید تا ببینید آیا نرخ بازیابی پاسخها در پروژه شما افزایش مییابد یا خیر.
اما داستان سختافزاری مدیریت این حجم از وابستگیها در حافظه حتی پیچیدهتر است — به تحلیل ما دربارهی بهینهسازی KV Cache مراجعه کنید.



گفتگو