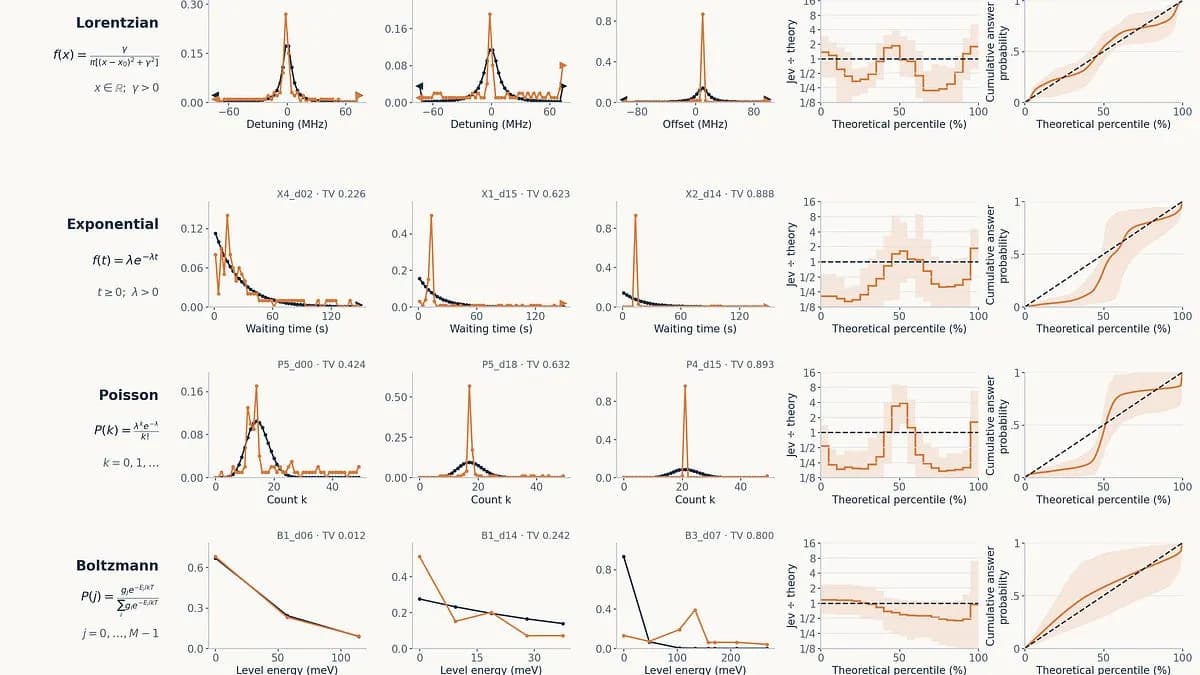
تصور کنید ابزاری دارید که برای تصمیمات سریع و دقیق طراحی شده، اما وقتی از او میخواهید احتمال وقوع یک پدیده فیزیکی را تخمین بزند، با اطمینانی کامل جواب غلط میدهد. این دقیقاً همان وضعیتی است که مدل تصمیمگیر Jev از شرکت TypeSafe با آن روبروست. طبق یک تحلیل جدید، مدل Jev در تولید توزیعهای احتمالی دقیق برای قوانین شناختهشده فیزیک بهطور مداوم شکست میخورد. این یافته یک نقص بحرانی در کالیبراسیون احتمالی (Probabilistic Calibration) مدل را آشکار میکند.
این یافته در حالی منتشر میشود که صنعت هوش مصنوعی در تلاش است از تولید متنهای آزاد (Freeform Text Generation) فاصله بگیرد و به سمت «مدلهای تصمیمگیر» (Decision Models) حرکت کند. برخلاف مدلهای زبانی بزرگ (LLM) استاندارد که خروجی آنها رشتههای متنی است، Jev طراحی شده تا یک توزیع احتمالی روی مجموعهای از گزینههای چندگزینهای برگرداند. این ساختار تئوریک، آن را برای کارهای طبقهبندی (Classification) که در آنها نیاز به یک امتیاز اطمینان (Confidence Score) است، ایدهآل میکند.
در فضای فعلی، تمایز بین تفکر «سیستم یک» (سریع و غریزی) و «سیستم دو» (کند و آگاهانه) — مفهومی از کتاب دانیل کانمن با عنوان تفکر، سریع و کند — برای دستهبندی مدلها به کار میرود. ترنسفورمرهای استاندارد مثل Claude یا GPT مدلهای سیستم دو محسوب میشوند. در مقابل، مدلهایی مثل Jev و پیشگام آن یعنی Laya، بهعنوان طبقهبندهای سیستم یک عمل میکنند. همانطور که در تحلیلهای پیشین ما دربارهی معماری مدلهای استدلالی اشاره کردیم، حذف لایههای تفکر کند در مدلهای سیستم یک، ریسک افزایش توهم را بالا میبرد.
معماری مدلهای تصمیمگیر
معماری ترنسفورمر (Transformer) ستون فقرات LLMهای مدرن است و یک پارادایم منعطف برای یادگیری عمومی فراهم میکند. با این حال، LLMها بهطور تقلیلناپذیری تصادفی (Stochastic) و خودبازگشتی (Autoregressive) هستند. سبک خروجی آنها یعنی متن آزاد، برای کارهای طبقهبندی مناسب نیست.
برای مثال، یک فراخوانی از LLM مثل claude("2 + 2 = ?") ممکن است جواب را بهصورت رشته متنی "4"، یک عدد صحیح (Integer) یا یک عدد اعشاری (Float) برگرداند. مدل Jev این مشکل را با متصل کردن یک طبقهبند به یک ترنسفورمر پیشآموزشدیده حل میکند. در این حالت، یک فراخوانی بهصورت jev("2+2?", "3 : int, 4 : int, 5 : int") خواهد بود که مقدار ۴ را بهطور دقیق با نوع داده عدد صحیح برمیگرداند. این ساختار اجازه میدهد مدل بدون نیاز به آموزش روی یک تسک خاص، بلافاصله از زمینه (Context) جدید استفاده کند و یک توزیع احتمالی روی چندین گزینه ارائه دهد.
آزمایش کالیبراسیون
برای سنجش دقت Jev، آزمایشی با ۱۰۰۰ تنظیم مختلف روی ۱۰ توزیع فیزیکی کاندید انجام شد. پژوهشگر برای پیادهسازی این آزمایشها، نوشتن پرامپتهای قالببندی شده (Templated Prompts) و مدیریت فراخوانیهای API از GPT-6 Astra و Claude Opus 5.5 استفاده کرد. همچنین از توانایی Opus 5.5 برای تولید نمودارهای دادهها بهره برد. کل این مجموعه آزمایشها بسیار مقرونبهصرفه بود و هزینهای کمتر از ۴ دلار داشت.
در این تست، از Jev خواسته شد تا روی مجموعهای از بازههای محدود (Binned Ranges) برای پارامترهای پیوسته، یک «انتخاب» کند. اگر Jev دارای کالیبراسیون مناسبی بود، احتمال داخلی آن برای هر بازه باید با تابع توزیع احتمال (PDF) فیزیکی مطابقت میداشت.
بهعنوان یک خط مبنا، توزیع ماکسول-بولتزمن بررسی شد. برای یک سیستم از ذرات کلاسیک غیربرهمکنش و غیرنسبیتی در تعادل ترمودینامیکی، کسری از ذرات در یک المان فضای سرعت سهبعدی توسط این توزیع تعریف میشود. توابع چگالی احتمال سرعت برای گازهای نجیب در دمای ۲۹۸.۱۵ کلوین (۲۵ درجه سانتیگراد)، یک مثال واقعی است که در آن محور y بر حسب متر بر ثانیه است و مساحت زیر منحنی بدون بعد است.
پارامترهای آزمایش و بازهها
پژوهشگر ۱۰ توزیع را انتخاب کرد: گاوسی، لورنتزی، ماکسول، گاما، نمایی، رایلی، یکنواخت، پوآسون، دوجملهای و بولتزمن. برای هر توزیع ۵ قالب پرامپت و برای هر قالب ۲۰ تغییر (مانند تغییر دمای محیط) اعمال شد که در مجموع ۱۰۰۰ تنظیم را میساخت. بازههای پاسخ برای هر قالب به شرح زیر ثابت بود:
- پاسخهای علامتدار (گاوسی، لورنتزی): ۴۸ بازه با عرض R/24 در بازه [−R, R]، بهعلاوه گزینههای «کمتر از −R» و «R یا بیشتر».
- پاسخهای غیرمنفی (ماکسول، گاما، نمایی، رایلی): ۴۹ بازه با عرض w که از صفر شروع میشود، بهعلاوه گزینه «۴۹w یا بیشتر».
- موقعیتهای یکنواخت: ۵۰ بازه در محدودهای که تمام نمونههای استخراج شده را شامل شود.
- پوآسون: شمارشهای ۰ تا ۴۸ و «۴۹ یا بیشتر».
- دوجملهای: بازه ۰ تا ۴۹، با N = ۴۹ کوشش.
- بولتزمن: سطوح انرژی خاصی که بهطور لیستشده ارائه شده بودند.
یافتههای کلیدی درباره صحت
پاسخهای Jev با استفاده از معیار «تغییر کل» (Total Variation یا TV) در تمام انتخابهای ممکن برای هر نمونه، با استفاده از فرمول ( \mathrm{TV}(q, p) = \frac{1}{2}\sum_{i=1}^{K} \lvert q_i - p_i \rvert ) امتیازدهی شدند. در این فرمول، q احتمال پاسخ Jev و p انتگرال PDF صحیح در آن بازه است. TV برابر با ۰ به معنای تطابق کامل و ۱ به معنای تضاد کامل جرم احتمالی است.
- امتیازات TV: میانگین TV مدل Jev برابر با ۰.۵۱۸ بود. برای مقایسه، مدلی که صرفاً احتمال را بهطور یکنواخت روی تمام گزینهها پخش میکرد (Flat Guess)، امتیاز ۰.۵۴۶ میگرفت. این یعنی Jev بهسختی بهتر از یک حدس تصادفی عمل میکند. در توزیع یکنواخت، Jev امتیاز ۰.۷۷ گرفت در حالی که حدس تصادفی ۰.۳۹ بود؛ برای پوآسون، این مقدار ۰.۶۵ در مقابل ۰.۶۴ بود.
- مشکل «پیکهای تیز»: Jev تمایل شدیدی به تولید توزیعهایی دارد که بیش از حد باریک و تیز (Peaky) هستند. این مدل با دنبالههایی که بهآرامی محو میشوند مشکل دارد و اغلب به بازههای دنبالهای که باید احتمالشان نزدیک به صفر باشد، وزن غیرصفر اختصاص میدهد. توزیع لورنتزی نسبتاً خوب عمل کرد، احتمالاً چون ذاتاً تیز و دارای دنبالههای پهن است.
- شکست در توزیع یکنواخت: در یکی از تکاندهندهترین شکستها، Jev هنگام پرسش درباره توزیع یکنواخت، یک تابع دلتای تقریباً کامل (اعتمادبهنفس شدید) حول صدک ۵۰ام تولید کرد که منجر به TV نزدیک به ۰.۸ شد.
- کپیبرداری در برابر استدلال: Jev در توزیعهایی که نقطه اوج (Peak) صراحتاً در پرامپت ذکر شده بود، خوب عمل کرد. برای مثال، در یک تست گاوسی که مرکز خط گسیل -۱۴.۰۳۳ مگاهرتز و نیمعرض در نصف بیشینه ۶.۸۳۶۴ مگاهرتز ذکر شده بود، Jev بهسادگی بازه «-۱۶ تا -۱۲ مگاهرتز» را با احتمال ۰.۷۴ انتخاب کرد. اما در توزیعهای ماکسول، رایلی و گاما — که نقطه اوج باید استخراج میشد و داده نشده بود — تنها در حدود ۲۰٪ موارد موفق به یافتن نقطه اوج درست شد و توزیعی بسیار تخت تولید کرد.
شکافهای ریاضی و منطقی
نکته جالب این است که Jev نسبت به تئوری نادان نیست. وقتی بهسادگی از او پرسیده شد کدام توزیع برای یک مسئله خاص مناسب است (مثلاً «کدام توزیع برای پاسخ به این سوال مناسب است؟»)، با دقت بسیار بالایی پاسخ داد. تنها استثنا توزیع گاما بود که در ۴۰ مورد از ۱۰۰ مورد، آن را «نمایی» تشخیص داد؛ هرچند در ۲۰ مورد از این موارد، توزیع گاما واقعاً به نمایی تبدیل میشود و پاسخ درست است.
برای بررسی این شکاف، یک نردبان توانمندی ریاضی توسط Opus 5.5 پیشنهاد شد که از سطح ۱ (کپیبرداری) تا سطح ۸ (محاسبات لازم برای سوالات ماکسول-بولتزمن) را شامل میشد:
۱. تسکهای پایه: Jev در کپیبرداری، جمع، ضرب و جذر مناسب است.
۲. دیوار محاسباتی: مدل در محاسبات چندمرحلهای میشکند. وقتی مجبور است بیش از دو مرحله متوالی را بهصورت داخلی انجام دهد، دچار خطا میشود.
۳. ردیابی توانها: مدل در ردیابی توانهای ۱۰ بهشدت ضعیف است.
فرضیه معماری
از آنجا که Jev فاقد ساختار زنجیره تفکر (Chain-of-Thought) برای ذخیره نتایج میانی است، باید تمام محاسبات چندمرحلهای را بهصورت داخلی انجام دهد. پژوهشگر معتقد است مدل احتمالاً آنقدر عمیق نیست که مکانیسمهای غیربازگشتی لازم برای این نوع محاسبات را تکامل دهد. این موضوع بهویژه در مسائلی مثل توزیع ماکسول-بولتزمن مشهود است، جایی که محاسبه میانگین از روی جرم و دما نیازمند ریاضیات چندمرحلهای غیرساده است.
این موضوع با یافتههای دیگران همسو است:
- کانتا هایاشی: در پژوهش «Jev تاس نمیاندازد»، دریافت Jev هنگام پیشبینی پرتاب تاسی که نمیدید، در ۴۰۰ مورد همیشه عدد «۱» را با احتمال متوسط ۸۳٪ انتخاب کرد، در حالی که فقط ۱۹٪ دفعات درست بود.
- یو شی چاو: در پژوهش «Jev سریع است اما هنوز نمیتواند سکه بیندازد»، دریافت Jev احتمال ۹۰.۰۱٪ را به وجه اول تاس و ۹۳.۲۳٪ را به شیر در پرتاب سکه عادلانه اختصاص میدهد.
- گو و همکاران: اشاره کردند که LLMها بهطور کلی در نمونهگیری از توزیعهای احتمالی ضعیف هستند و سوگیری (Bias) ایجاد میکنند.
نقش تنظیم دقیق
شواهد نشان میدهد در حالی که مدلهای پیشآموزشدیده اغلب کالیبره هستند، فرآیندهای پسآموزش مثل RLHF (یادگیری تقویتی با بازخورد انسانی) ممکن است این کالیبراسیون را تخریب کنند. این رفتار «جستوجوی مُد» (Mode-seeking) یا «جستوجوی میانگین» در مدلهایی که با توابع زیان از نوع KL divergence آموزش دیدهاند رایج است؛ الگویی که در گزارش فنی GPT-4 نیز ذکر شده است.
اگرچه بالدلی و همکاران دریافتند که کالیبراسیون احتمالی را میتوان از طریق تنظیم دقیق (Fine-tuning) بهبود بخشید، اما اشاره کردند که این دستاوردها گاهی تواناییهای پاییندستی، بهویژه استدلال ریاضی را کاهش میدهد و هزینههای آن بسته به مدل متفاوت است.
ریسکهای طراحی آزمایش
این مطالعه همچنین شکستی را در مدلهای پیشرو (Frontier Models) نشان داد که برای طراحی آزمایش استفاده شده بودند. GPT-6 Astra و Claude Opus 5.5 مکرراً متوجه نشدند که پاسخ بهطور تصادفی در خودِ پرامپت گنجانده شده است. آنها گزارش دادند که کالیبراسیون بهبود یافته، در حالی که در واقعیت، فقط توانایی Jev در کپی کردن متن از پرامپت را تست میکردند.
پژوهشگر به فقدان «فراشناخت خودبهخودی» (Spontaneous Metacognition) در این مدلها اشاره کرد؛ آنها نتوانستند آزمایش را دوباره بخوانند تا بپرسند آیا متغیر مورد نظر واقعاً تست میشود یا خیر. علاوه بر این، پژوهشگر متوجه تغییر عجیبی در خروجی Claude 5.0 شد و اشاره کرد که مدل «بریتانیایی» شده و از املایی مثل "centred" و "colour" استفاده میکند.
برای متخصصان، این بدان معناست که استفاده از مدلهای سبک Jev بهعنوان داوران خودکار (مانند JevEval) ریسک بالایی دارد. اگر توزیعهای احتمالی مدل برای مسائل شناختهشده کالیبره نباشند، امتیازات اطمینان آن را نمیتوان بهعنوان جایگزینی برای حقیقت پذیرفت.
این تغییر نشان میدهد که برای طبقهبندیهای حساس، صنعت هنوز نمیتواند به سرعت «سیستم یک» بدون تایید استدلال «سیستم دو» تکیه کند. بهای این بهرهوری هزینهای شدید — کل آزمایش کمتر از ۴ دلار بود — از دست دادن قابلتوجه قابلیت اطمینان احتمالی است.
گام بعدی شما
- اگر از مدلهای تصمیمگیر برای استخراج امتیاز اطمینان (Confidence Score) استفاده میکنید، حتماً آنها را با دادههای مرجع (Ground Truth) کالیبره کنید.
- برای تسکهای حساس، خروجیهای سیستم یک را با یک مدل استدلالی (Reasoning Model) در لایه سیستم دو اعتبارسنجی کنید.
- در طراحی پرامپتهای ارزیابی، مراقب نشت داده (Data Leakage) باشید تا مدل بهجای استدلال، پاسخ را کپی نکند.
اما داستان سختافزاری این تحول و تأثیر آن بر هزینه استنتاج حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو