آیا متنی که تکتک کلماتش توسط انسان نوشته شده، باز هم میتواند بهعنوان اثر هوش مصنوعی شناسایی شود؟ متدولوژی جدیدی از دانشگاه مریلند اکنون قادر است تشخیص دهد که آیا ایدههای یک متن از یک مدل زبانی نشأت گرفتهاند یا خیر، فارغ از اینکه چه کسی نثر نهایی را نوشته است. این تغییر رویکرد، خط مقدم تشخیص هوش مصنوعی را از تحلیل الگوهای زبانی به شناسایی منشأ مفاهیم زیربنایی تغییر میدهد.
سالهاست که صنعت بر ابزارهای تشخیص متنی تکیه کرده است که احتمال آماری توالی کلمات را بررسی میکنند. این ابزارها اغلب زمانی که انسانی متن را برای «انسانیتر کردن» بهطور گسترده بازنویسی میکند، شکست میخورند. فضای فعلی، نبردی است میان مدلهای زبانی بزرگ (LLM) که توکن بعدی را پیشبینی میکنند و تشخیصدهندههایی که سعی دارند این الگوهای پیشبینیپذیر را شکار کنند.
این موارد سنتی در واقع تنها برونسپاری یک وظیفه ارتباطی هستند. مدلهای زبانی مانند ChatGPT و Google Gemini صرفاً توکن محتمل بعدی را در پاسخ به پرامپت کاربر پیشبینی میکنند. آنها گامی به عقب نمیبرند تا ابتدا بوم کلی مسئله یا گزاره را بررسی کنند؛ آنها فقط کلمه محتمل بعدی را حدس میزنند.
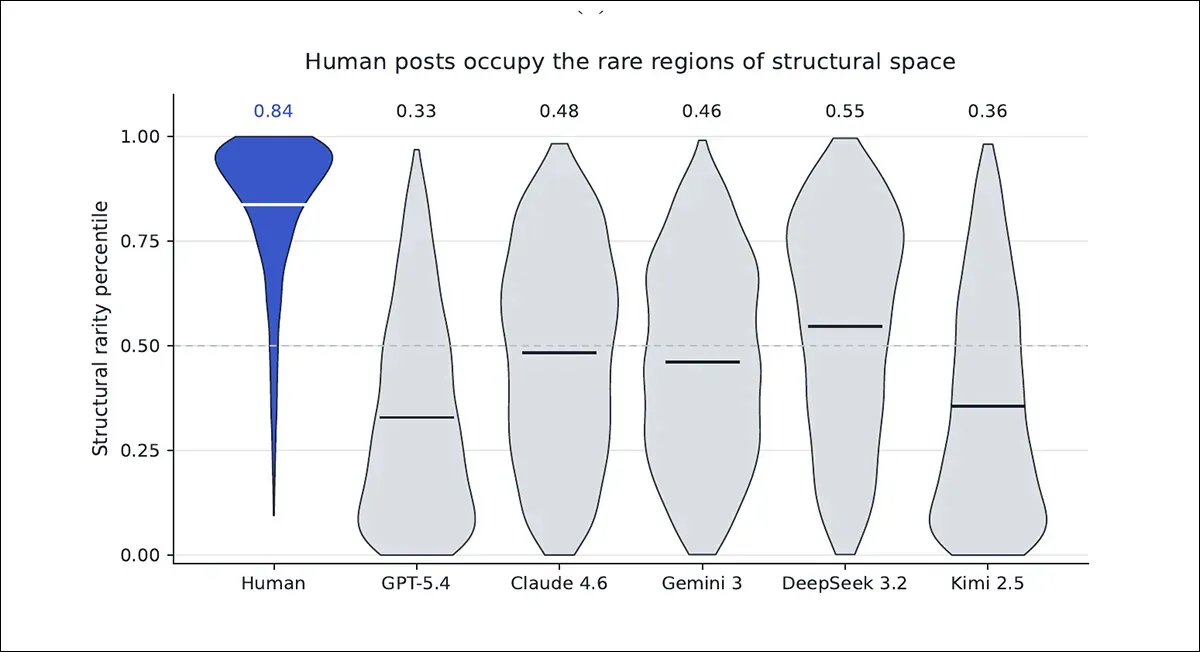
به نقل از گزارشی که در ۶ اکتبر ۲۰۲۶ توسط unite.ai منتشر شد، ابزار جدیدی به نام IdeaLens بهطور کامل از کلمات عبور میکند. این ابزار بر «شکل ابعاد-بالای» اثر تمرکز دارد؛ یعنی همان طرح کلی ساختاری که پس از حذف نثر باقی میماند. پژوهشهای اخیر نشان میدهد نیاز به انسجام و مرتبط بودن بخشهای مجاور متن، باعث ایجاد یک «امضای منحصربهفرد» در طرح کلی اثر میشود. این امضا میتواند دست هوش مصنوعی را حتی زمانی که متن بهطور گسترده بازنویسی شده باشد، لو دهد.
سازوکار IdeaLens
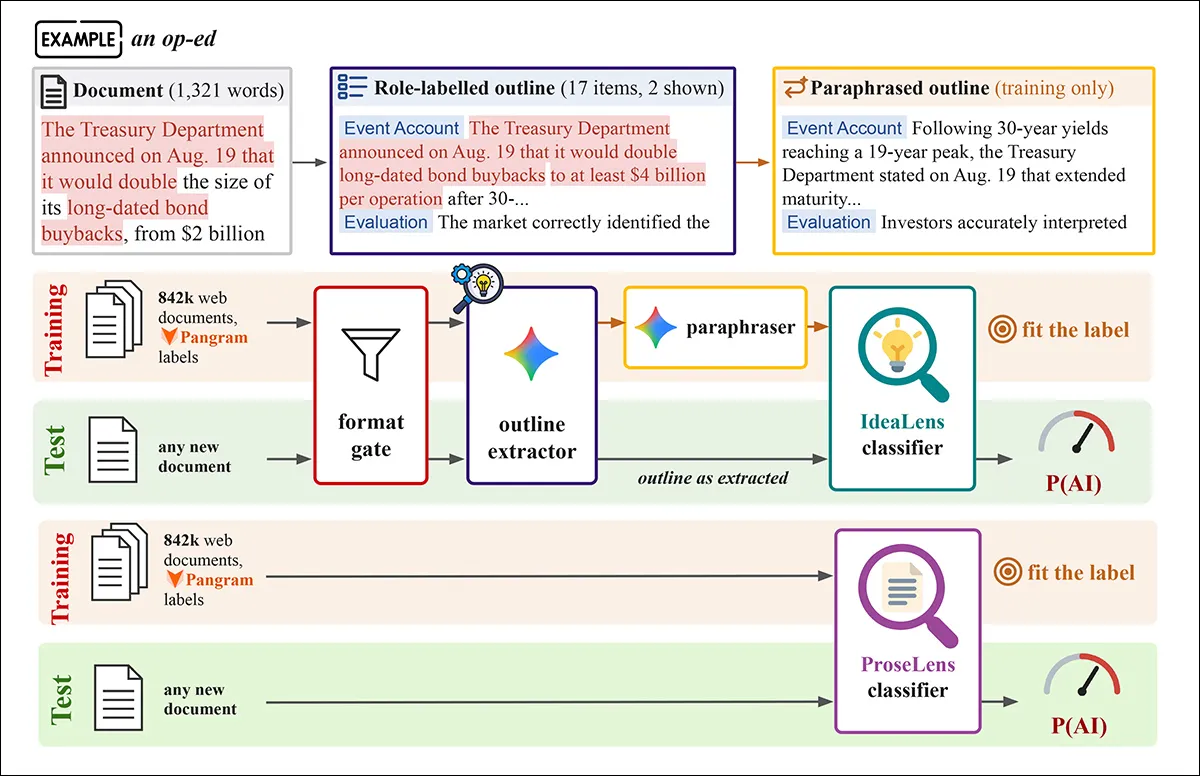
IdeaLens با تبدیل یک سند به یک طرح کلی سادهشده عمل میکند. این فرآیند ایدههای اصلی را حفظ کرده و کلمات خاصی را که معمولاً تشخیصدهندههای سنتی را تحریک میکنند، حذف میکند. نویسندگان مقاله بیان میکنند در حالی که تشخیصدهندههای مدرن شناسایی میکنند «چه کسی کلمات را نوشته»، سیاستهای نوظهور بهطور فزایندهای بر این متمرکز شدهاند که «چه کسی ایدهها را خلق کرده است».
- این سیستم فهرستی از موارد را استخراج میکند که یک «نقش گفتمانی» (مانند شرح یک رویداد یا ارزیابی) را با توصیفی کوتاه و بازنویسیشده از محتوا جفت میکند. برای مثال، یک مقاله نظریه ۱,۳۲۱ کلمهای به یک طرح کلی برچسبگذاریشده تبدیل میشود که در آن نقاط بر اساس عملکردشان دستهبندی شدهاند.
- در طول آموزش، این طرحها مجدداً بازنویسی میشوند تا هرگونه همپوشانی کلامی باقیمانده با متن اصلی حذف شود. این کار تضمین میکند که مدل از روی ایدهها یاد بگیرد، نه از ویژگیهای لو دهنده نثر.
- سپس مدل بر اساس الگوهای یافت شده در یک مجموعه آموزشی شامل یک میلیون طرح کلی استخراجشده از اسناد وب، احتمال هوش مصنوعی بودن این ایدههای ساختاری را تخمین میزند.
عملکرد و محکهای ارزیابی
در تستهای رویارویی، IdeaLens زمانی که منشأ ایدهها با منشأ نوشتار متفاوت بود، بهطور قابلتوجهی از تشخیصدهندههای سنتی پیشی گرفت. پژوهشگران IdeaLens (در هر دو فرم طرح کلی و سند)، ProseLens و نسخههای ModernBERT-L را در برابر طیف گستردهای از رقبا قرار دادند. این رقبا شامل Pangram 4، EditLens-Llama-3B، Binoculars، EditLens-RoBERTa، MELD، Desklib، Entropy، Fast-DetectGPT، Likelihood، Log-rank، LRR، MAGE، OpenAI-RoBERTa-base، OpenAI-RoBERTa-large، RADAR و Rank بودند.
- IdeaLens در ۶۸٪ از داستانهایی که توسط انسان نوشته شده بودند اما ایدههایشان از AI بود، بهدرستی منشأ را شناسایی کرد. در مقابل، Pangram 4 تنها در ۸٪ موارد موفق بود و ProseLens و EditLens-3B امتیاز صفر کسب کردند.
- در ۵۱ تست از ۲۲ محک مختلف، IdeaLens دقت ۸۱.۳٪ را برای اسناد با «منشأ مختلط» (جایی که ایده و نثر منشأ متفاوتی دارند) و ۹۵.۳٪ را برای منشأ مشترک حفظ کرد.
- در مقایسه، ProseLens و Pangram 4 زمانی که ایده و نثر منشأ یکسانی داشتند بالای ۹۸٪ امتیاز گرفتند، اما دقت آنها در حالت منشأ مختلط به حدود ۲۵٪ سقوط کرد.
تست آستانه «برنامه انسانی»
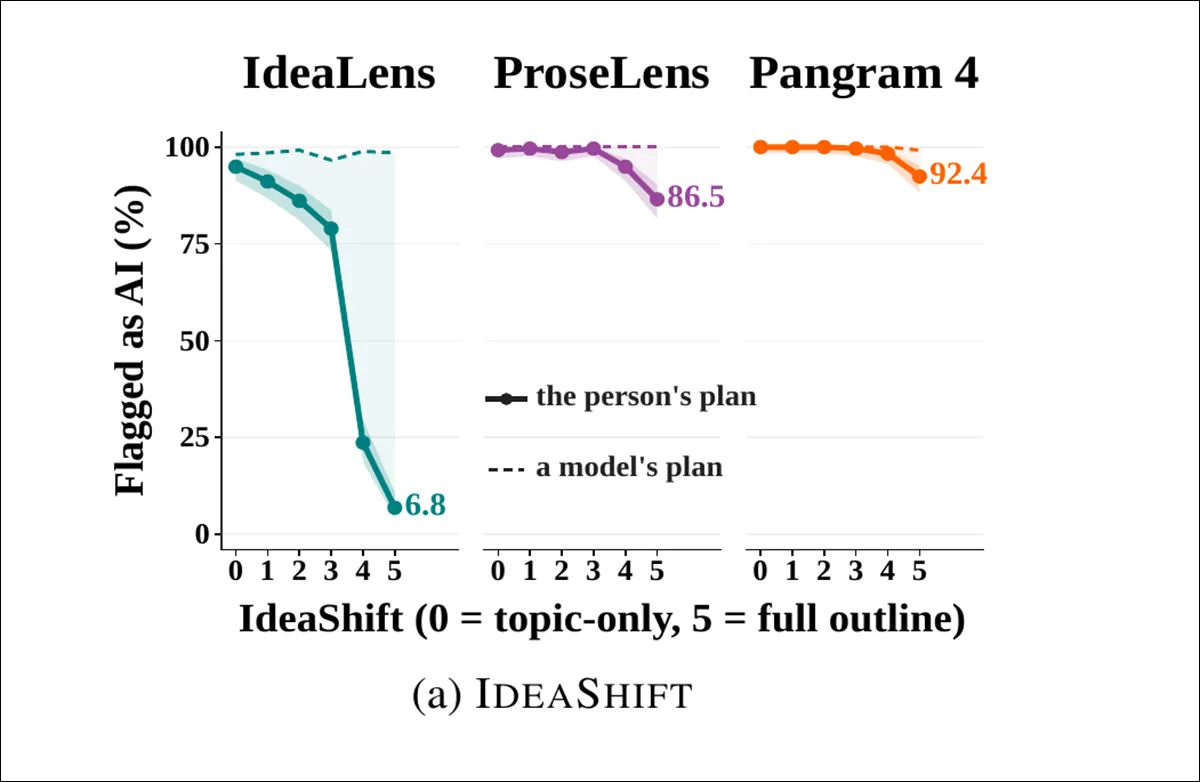
پژوهشگران بررسی کردند که چه مقدار ورودی انسانی برای «فریب دادن» تشخیصدهنده لازم است. آنها به مدلهای AI برنامههای انسانی با جزئیات فزاینده دادند؛ از یک موضوع ساده تا یک طرح کلی کامل. این آزمایش گذار از یک پرامپت «فقط موضوع» به یک برنامه کامل نوشتهشده توسط انسان را اندازهگیری کرد.
با افزایش سهم انسان در برنامهریزی، نرخ شناسایی AI توسط IdeaLens از ۹۴.۹٪ (فقط موضوع) به ۶.۸٪ (طرح کلی کامل انسانی) کاهش یافت. نکته حیاتی این است که تشخیصدهندههای متنی سنتی مانند ProseLens و Pangram همچنان این اسناد را بهعنوان تولید AI طبقهبندی کردند، زیرا نوشتار نهایی هنوز توسط یک LLM تولید شده بود، فارغ از اینکه برنامه اولیه انسانی بود یا خیر.
مجموعه داده و تعمیمپذیری
برای اعتبارسنجی سیستم، تیم سه مجموعه داده خاص ایجاد کرد تا ارزیابی دقیقی از منشأ ایده داشته باشد:
۱. IdeaShift: ساخته شده از ۵۰۰ سند بذر انسانی و AI. از GPT-5.6 Sol برای تبدیل اینها به پرامپتهای با جزئیات فزاینده، از «فقط موضوع» تا یک طرح کلی کامل، استفاده شد که سپس برای تولید اسناد جدید به کار رفتند.
۲. IdeaShift-X: این مجموعه از ۱۰,۰۰۰ سند FineWeb2 نوشته انسان در ۲۴ زبان استفاده کرد. پروتکل IdeaShift برای تولید نسخههای AI در هر یک از این زبانها اعمال شد.
۳. TwiceTold: برای جلوگیری از استفاده ذاتی AI در فرآیندهای crowdsourcing، دانشجویان دانشگاه ۵۰ داستان را از ابتدا بر اساس طرحهای ۵۰۰ کلمهای ارائه شده توسط ChatGPT-5.6 Sol نوشتند.
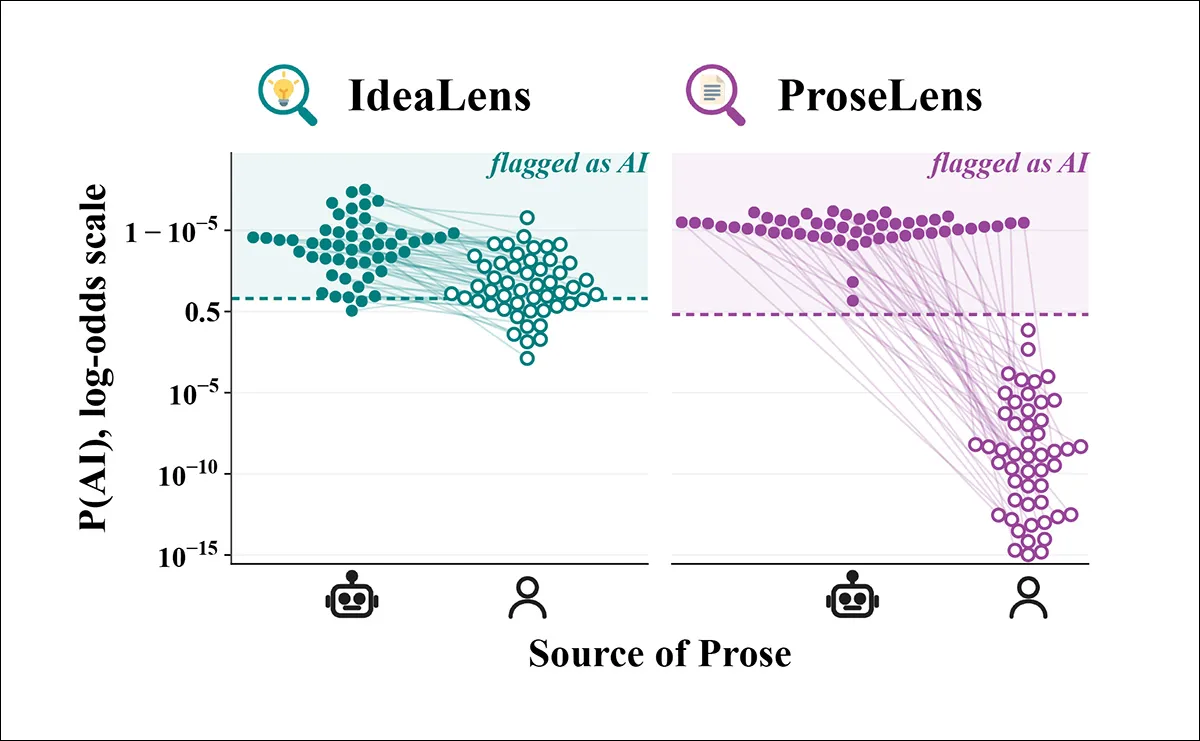
نتایج نشان داد که IdeaLens در ۲۴ زبان بهخوبی تعمیم مییابد و ۹۵.۳٪ از اسناد مبتنی بر ایدههای AI را شناسایی میکند. وقتی یک برنامه انسانی دقیق ایدهها را تامین میکرد، نرخ شناسایی تنها ۰.۷٪ بود. همچنین در ۱۰,۰۰۰ سند انسانی پیش از دوران ChatGPT در همان زبانها، نرخ مثبت کاذب تنها ۰.۱٪ بود.
تحلیل فنی
این پیشرفت این فرض بنیادی را که «انسانی کردن» متن AI راهی برای دور زدن تشخیص است، تغییر میدهد. IdeaLens با هدف قرار دادن مرحله ایدهپردازی، نشان میدهد که LLMها «وسواسهای» تکرارشونده و امضاهای ساختاری دارند که فارغ از واژگان نهایی باقی میمانند. این وسواسها اغلب بهطور ناخودآگاه ظاهر میشوند و همیشه به دادههای آموزشی خاص مرتبط نیستند.
عامل دیگر این است که برخی مفاهیم و متون بهطور آماری در دادههای آموزشی مدلها که بهخوبی پالایش نشدهاند، غالب هستند و احتمال ظهور آنها در درخواستهای متنوع بیشتر است. این امر یک الگوی ردیابیپذیر از ایدهپردازی ایجاد میکند.
برای جامعه فنی، این موضوع یک محک جدید برای منشأ (provenance) معرفی میکند: جداسازی منشأ ایده از منشأ نثر. این ثابت میکند که «طرح کلی» یک فکر تولید شده توسط AI، یک امضای ریاضی متمایز دارد که پایدارتر از توکنهای مورد استفاده برای بیان آن است. نویسندگان اشاره کردند که IdeaLens در زمان تست، بهطور غیرمنتظرهای روی ورودیهای متن خام نیز بهخوبی عمل میکند و دقت بسیار بالاتری در اسناد با منشأ مختلط نسبت به ProseLens نشان میدهد.
معیارها و دامنه ارزیابی
پژوهشگران برای تضمین اعتبار یافتهها، از مجموعهای سختگیرانه از معیارهای ارزیابی استفاده کردند. صحت بر اساس تطابق برچسب پیشبینیشده (AI یا انسان) با منشأ ایدهها اندازهگیری شد. تیم از آستانه ۱٪ نرخ مثبت کاذب (FPR) جهانی برای IdeaLens، ProseLens و EditLens استفاده کرد. برای ابزارهایی مانند Fast-DetectGPT، Binoculars، MELD و Desklib از آستانههای پیشفرض استفاده شد، در حالی که برچسبهای Pangram 4 (شامل AI، AI-assisted و انسان) برای این مطالعه به حالت دوگانه (binary) تبدیل شدند.
دامنه ارزیابی گسترده بود و ۱۹ محک خارجی را شامل میشد. این شامل ۱۴ محک برای مطالب کاملاً انسانی یا کاملاً AI و ۱۰ مورد شامل نوشتار انسانی بود که متعاقباً توسط AI ویرایش شده بود. برای تست بیشتر، پژوهشگران از ۵۰,۰۰۰ سند درون-دامنه و ۱۰,۰۰۰ سند C4 پیش از ChatGPT برای ارزیابی دقیق نرخ مثبت کاذب استفاده کردند.
آینده ایدهپردازی
استاندارد شدن این ابزار به این بستگی دارد که جامعه در ۶ تا ۱۲ ماه آینده، نقش AI را در خلاقیت چگونه ببیند. این دامنه تشخیص میتواند نویسندگان مختلفی از جمله رماننویسان، ستوننویسان و نویسندگان سخنرانیهای سیاسی را که به سبک شخصی خود افتخار میکنند اما از AI برای تامین موضوعات استفاده میکنند، نگران کند.
در حالی که استفاده از AI برای صیقل دادن ایده اصلی انسان ممکن است پذیرفتنی باشد — و شاید افکار عمومی با AI بهعنوان یک ابزار کمکی برای ارائه موافق باشند — اما استفاده از آن برای خلق سیاستها یا روایتها، بار اخلاقی نویسندگی را تغییر میدهد. با توجه به تمایل AI به خطا و رفتارهای غیرمنتظره، شاید زود باشد که اجازه دهیم LLMها نیروی محرک ایدهپردازی یا پیشنهادهای سیاستی شوند.
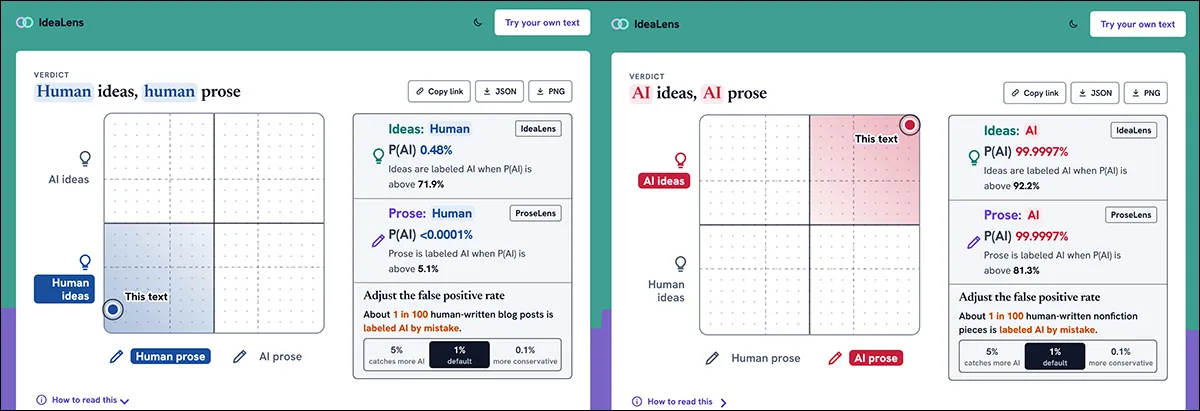
پژوهشگران مخزن گیتهاب IdeaLens را برای توسعه بیشتر در دسترس قرار دادهاند و اذعان کردهاند که استفاده از مجموعههای داده بزرگتر و رفع نویز برچسبها از اهداف کارهای آینده است. یک سایت دموی عمومی نیز برای کسانی که میخواهند متون مشکوک را بررسی کنند و ببینند آیا این متد با تخمینهای خودشان همخوانی دارد یا خیر، فعال است.
گام بعدی شما
- اگر از AI برای ساختاردهی به مقالات خود استفاده میکنید، بدانید که «ساختار» شما را میتوان شناسایی کرد، حتی اگر کلمات را کاملاً تغییر دهید.
- برای کاهش اثر امضای AI، سعی کنید طرح کلی (Outline) را بهصورت دستی و با منطق غیرخطی طراحی کنید و سپس از مدل برای بسط دادن آن استفاده کنید.
- ابزار IdeaLens را در سایت دموی آن تست کنید تا ببینید متون بازنویسیشده شما تا چه حد «انسانی» به نظر میرسند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو