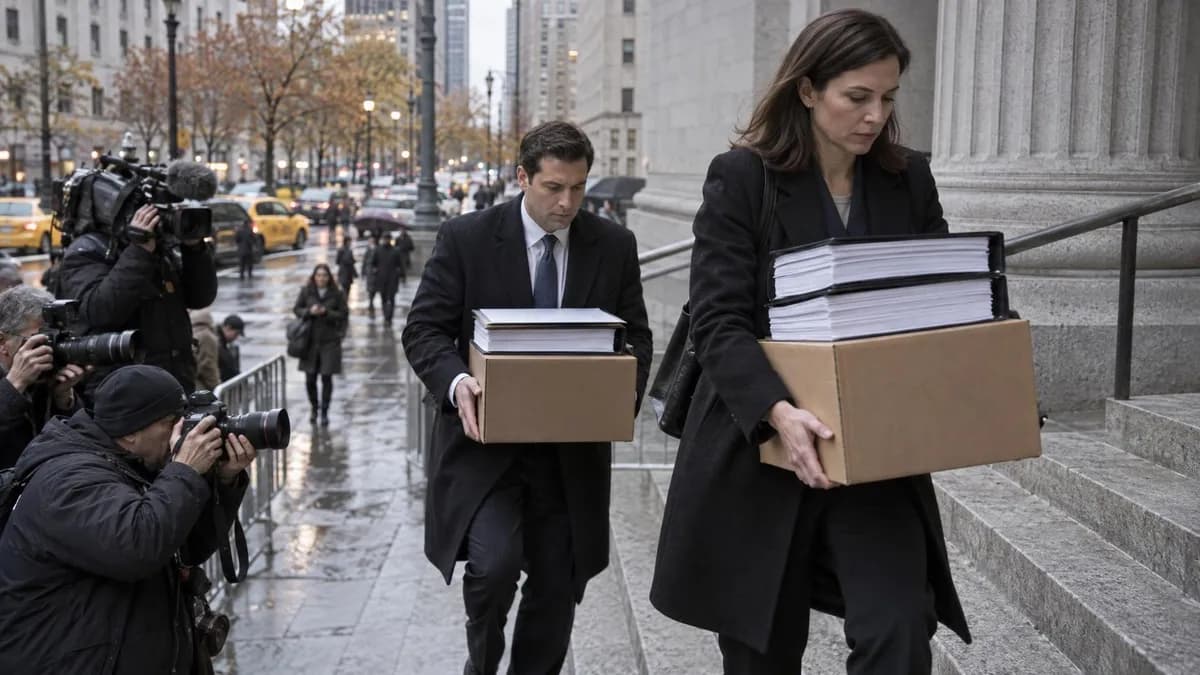
تصور کنید سالها هزینه کنید تا تیمی از خبرنگاران برنده جایزه پولیتزر را برای افشای حقیقت به میدان بفرستید، اما در نهایت یک چتبات تمام دستاوردهای شما را در چند ثانیه خلاصه کند و کاربر را از بازدید از سایت شما منصرف سازد. این کابوس اکنون به یک نبرد حقوقی ۲۵۰ میلیون دلاری در دادگاه فدرال نیویورک تبدیل شده است.
طبق اعلام رسمی، شرکت USA TODAY Co., Inc. در ۸ اکتبر ۲۰۲۶ شکایتی را علیه OpenAI ثبت کرد. این شرکت مدعی است که مدلهای GPT با استخراج غیرقانونی صدها هزار مقاله از آرشیوهای خبری آنها آموزش دیدهاند تا خروجیهایی تولید کنند که عملاً جایگزین منابع اصلی خبر میشوند.
این تقابل حقوقی در حالی رخ میدهد که آزمایشگاههای هوش مصنوعی با موجی از شکایتهای مربوط به حق چاپ (Copyright) از سوی صنعت رسانه روبرو هستند. همانطور که در تحلیل قبلی ما دربارهی نحوه ارجاعدهی پلتفرمهایی مثل Perplexity و Gemini اشاره کردیم، این پرونده حالا از بحث سادهی «ارجاع» فراتر رفته و به هستهی اصلی نحوه ساخت مدلها میپردازد. برای یک رسانه، این موضوع یک مسئلهی حیاتی است؛ اگر یک هوش مصنوعی بتواند یک گزارش تحقیقی پیچیده را بهطور کامل بازتولید کند، انگیزهی کاربر برای پرداخت هزینه اشتراک از بین میرود.
جزئیات پرونده و مستندات حقوقی
این پرونده با عنوان USA Today Co., Inc. v. OpenAI Foundation توسط استیون لیبرمن از مؤسسه حقوقی Rothwell, Figg, Ernst & Manbeck در دادگاه منطقهی جنوبی نیویورک ثبت شده است. شاکی برای اثبات ادعای خود، فهرستی از ثبتهای حق چاپ و نمونههایی از خروجیهای مدل GPT-5.6 را به دادگاه ارائه کرده است.
برای تسریع در روند رسیدگی، یک «بیانیه مرتبط بودن» (Statement of Relatedness) در همان روز ثبت شد. این درخواست به این معناست که این پرونده به عنوان بخشی از دعاوی تجمیعشدهی نقض حق چاپ OpenAI که پیشتر در همان دادگاه در جریان بوده، بررسی شود. با این اقدام، شاکیان به فهرست بلندی از مالکان حق چاپ میپیوندند که علیه OpenAI و سایر شرکتهای هوش مصنوعی اقدام قانونی کردهاند. این فشارها در حالی شدت مییابد که برخی تحلیلها هشدار میدهند سختگیری بیش از حد در قوانین حق چاپ ممکن است امنیت ملی و رقابت تکنولوژیک آمریکا را به خطر اندازد.
ابعاد استخراج دادهها
بر اساس مستندات دادگاه، فرآیند آموزش OpenAI یک مشاهدهی غیرفعال از وب نبوده، بلکه یک استخراج هدفمند بوده است. در این شکایت ادعا شده که OpenAI از برنامههایی استفاده کرده که بهطور خاص برای حذف اطلاعات مدیریت حق چاپ طراحی شدهاند تا ماهیت حفاظتشدهی آثار، فارغ از وجود دیوار پرداخت (Paywall) یا محدودیتهای دسترسی، پنهان شود.
برای اثبات این ادعا، شاکی به شهادت OpenAI در برابر مجلس لردها در دسامبر ۲۰۲۳ استناد کرده است. در آن زمان، OpenAI پذیرفته بود که اگر دادههای آموزشی را فقط به آثار در مالکیت عمومی محدود کند، نمیتواند سیستمهایی بسازد که نیازهای فعلی بازار را برآورند، زیرا تقریباً هر فرمی از بیان انسانی تحت پوشش حق چاپ است.
دادههای عددی ذکر شده در پرونده عبارتند از:
- WebText: مجموعهی داخلی برای GPT-2 که گفته میشود بیش از ۱۶۰ هزار ورودی از شاکیان داشته است (۸۳,۲۶۶ مورد از usatoday.com و ۱۲,۹۹۴ مورد از freep.com).
- مجموعه داده C4: دامنههای این انتشارات بیش از ۱۲۲ میلیون توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — را در این زیرمجموعه اشغال کردهاند. این مجموعه در واقع یک زیرمجموعه فیلتر شده از زبان انگلیسی از یک snapshot سال ۲۰۱۹ از آرشیو وب Common Crawl است.
- ترکیب آموزشی: در GPT-3، دادههای Common Crawl ۶۰٪ و WebText2 (نسخه گسترش یافته WebText) حدود ۲۲٪ وزن داشتند که نشاندهنده اتکای شدید به دادههای استخراجشده از وب است.
اعترافات داخلی و «پروژه تاکسی»
این شکایت تنها به خروجیها تکیه نمیکند، بلکه پیامهای داخلی OpenAI را برای اثبات قصد و نیت به کار گرفته است. به نقل از این مستندات، گرگ بروکمن، یکی از بنیانگذاران شرکت، اشاره کرده که مدلها در پیشبینی متون خبری بسیار توانمند هستند. همچنین در ارائهای از داریو آمودی در سال ۲۰۲۰، تولید خبر به عنوان یکی از مهارتهای کلیدی GPT-3 لیست شده بود.
شواهد داخلی تکاندهندهتر است؛ معاون پژوهشی OpenAI صراحتاً گفته است: «ما شبکههای عصبی (Neural Network) — شبکهای از سلولهای کوچک، شبیه نقشهٔ مترو، که سیگنال را از ورودی به جواب میرساند — خود را برای حفظ کردن دادههای آموزشی تربیت میکنیم؛ هدف ما همین است.»
علاوه بر این، پیامهای داخلی ژوئن ۲۰۲۲ نشان میدهد که کارکنان شرکت پذیرفتهاند GPT-4 حجم عظیمی از دادهها را حفظ کرده و در بازتولید (Regurgitating) آنها بسیار مؤثر خواهد بود.
ادعاهای مربوط به نقش مایکروسافت حتی آسیبزنندهتر است. طبق گزارش پرونده، مایکروسافت در یک بازه زمانی سه ساله و تحت طرحی به نام Project Taxi، دسترسی به Bing Index (مجموعهای از میلیاردها صفحه وب استخراجشده) را در اختیار OpenAI قرار داده است. این افشاگریها با اسناد داخلی مایکروسافت همسو است که در برخی موارد، فرآیند استخراج دادههای هوش مصنوعی را به عنوان یک «سرقت گسترده» توصیف کردهاند. همچنین گفته میشود OpenAI برای اجرای یک خازند (Crawler) مجزا به نام Project Mango به مایکروسافت پول پرداخت کرده است. در این پرونده ادعا شده که فیلترهای خروجی OpenAI نتوانستند محتوای مربوط به نهادهایی که هنوز از شرکت شکایت نکرده بودند را حذف کنند؛ موضوعی که یکی از مدیران مایکروسافت در پیامهای داخلی آن را یک «پوشش تصادفی» (Accidental cover-up) توصیف کرده است.
مشکل «جایگزینی»
USA TODAY استدلال میکند که OpenAI فقط از دادهها «یاد نگرفته»، بلکه محصولی ساخته تا جایگزین منبع شود. نمونههایی از GPT-5.6 نشان میدهد که مدل خلاصههای مفصلی تولید کرده که ساختار سازمانیافتهی مقالات اصلی را دقیقاً کپی کردهاند. این موارد شامل انتشاراتی چون:
- The Indianapolis Star، Detroit Free Press و The Knoxville News-Sentinel
- The Palm Beach Post، The Tennessean و The Enquirer
- The Des Moines Register، The Courier-Journal و Naples Daily News
- Asbury Park Press، Milwaukee Journal Sentinel و The Columbus Dispatch
- The Oklahoman و Star News
نقلقولهای داخلی این ادعا را تقویت میکند. رئیس بخش ChatGPT در OpenAI پذیرفته است که وقتی کاربر پاسخی را از هوش مصنوعی میگیرد، «دلیل مناسبی برای کلیک روی لینک منبع وجود ندارد». همچنین گزارش شده است که یکی از مهندسان OpenAI بیان کرده که کاربران فارغ از اینکه لینکها با چه برجستگی یا وضوحی نمایش داده شوند، روی آنها کلیک نخواهند کرد.
ابعاد مالی و حقوقی
شاکیان بر اساس چارچوبهای قانونی، مبالغ هنگفتی را طلب کردهاند. آنها برای هر مورد نقض عمدی حق چاپ تا ۱۵۰ هزار دلار و برای حذف اطلاعات مدیریت حق چاپ، ۲۵ هزار دلار اضافی درخواست کردهاند. با توجه به صدها هزار مقاله، مجموع خسارات بالای ۲۵۰ میلیون دلار برآورد شده است.
این پرونده ۱۹ نشریه متعلق به USA TODAY Co. را نمایندگی میکند (که پیشتر با نام Gannett Co., Inc. شناخته میشد)، شرکت رسانهای که پیشینه آن به سال ۱۹۰۶ بازمیگردد. این نشریات شامل USA TODAY، The Arizona Republic، The Bergen Record، The Democrat & Chronicle و The Detroit News هستند. این مجموعه صدها خبرنگار را در ۱۳ ایالت به خدمت گرفته و دهها جایزه پولیتزر کسب کرده است.
متهمان شامل طیف گستردهای از نهادهای OpenAI هستند: OpenAI Foundation، OpenAI GP, LLC، OAI International, Inc.، OpenAI OpCo, LLC، OpenAI Global, LLC، OAI Corporation و OpenAI Group PBC. در این شکایت به بازسازی سرمایه در ۲۸ اکتبر ۲۰۲۵ اشاره شده است، جایی که نهاد غیرانتفاعی به OpenAI Foundation و بخش انتفاعی به OpenAI Group PBC تبدیل شد که ارزش آن حدود ۱۳۰ میلیارد دلار تخمین زده شد. تا مارس ۲۰۲۶، ChatGPT به ۹۰۰ میلیون کاربر فعال هفتگی و ۵۰ میلیون مشترک پولی رسیده بود.
مدلهای مورد بحث از GPT-1 تا GPT-6.1 و GPT-OSS، شامل تمام نسخههای Instant، Thinking، mini، nano و Pro هستند. شاکیان خواستار برگزاری دادگاه با حضور هیئت منصفه شدهاند.
تحلیل: پایان سپر «استفاده منصفانه»
این پرونده نشاندهنده تغییری در استراتژی است؛ از بحث درباره اینکه هوش مصنوعی چگونه ارجاع میدهد، به این سؤال که آیا اصلاً مجاز به بلعیدن این دادهها هست یا خیر. USA TODAY با استناد به پیامهای داخلی درباره «حفظ کردن» دادهها، تلاش میکند دفاعیه «استفاده تحولآفرین» (Transformative Use) را که OpenAI در پروندههای دیگر به آن تکیه کرده بود، تخریب کند.
برای صنعت خبرنگاری، این نبردی بر سر «ارزش کلیک» است. اگر دادگاه به این نتیجه برسد که خلاصههای هوش مصنوعی «جایگزین» (Substitute) هستند و نه «تحول» (Transformation)، آزمایشگاههای هوش مصنوعی مجبور خواهند شد به مدل «فقط لایسنس» روی بیاورند. این اتفاق عملاً دادههای باز وب را به یک جاده عوارضی تبدیل میکند که تنها ثروتمندترین شرکتهای هوش مصنوعی توان پرداخت هزینه مجموعههای آموزشی آن را دارند.
باید منتظر تصمیم دادگاه در مورد ادغام این پرونده با سایر دعاوی جاری بود، زیرا یک حکم مشترک میتواند یک پیشینه قانونی دائمی برای تمام دادههای آموزشی مدلهای زبانی بزرگ (LLM) ایجاد کند.
گام بعدی شما
- اگر مدیر محتوا یا تولیدکننده داده هستید، بررسی کنید که آیا دادههای شما در مجموعههای Common Crawl یا C4 حضور دارد یا خیر.
- روی تحولات مدلهای «استدلالی» نظارت کنید تا ببینید آیا برای کاهش ریسک حقوقی، از متدهای جدیدی برای ارجاعدهی استفاده میکنند یا خیر.
- نتایج دادگاههای ادغامشده OpenAI را دنبال کنید، زیرا این احکام مسیر قانونی تمام مدلهای زبانی بزرگ را تغییر میدهند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو