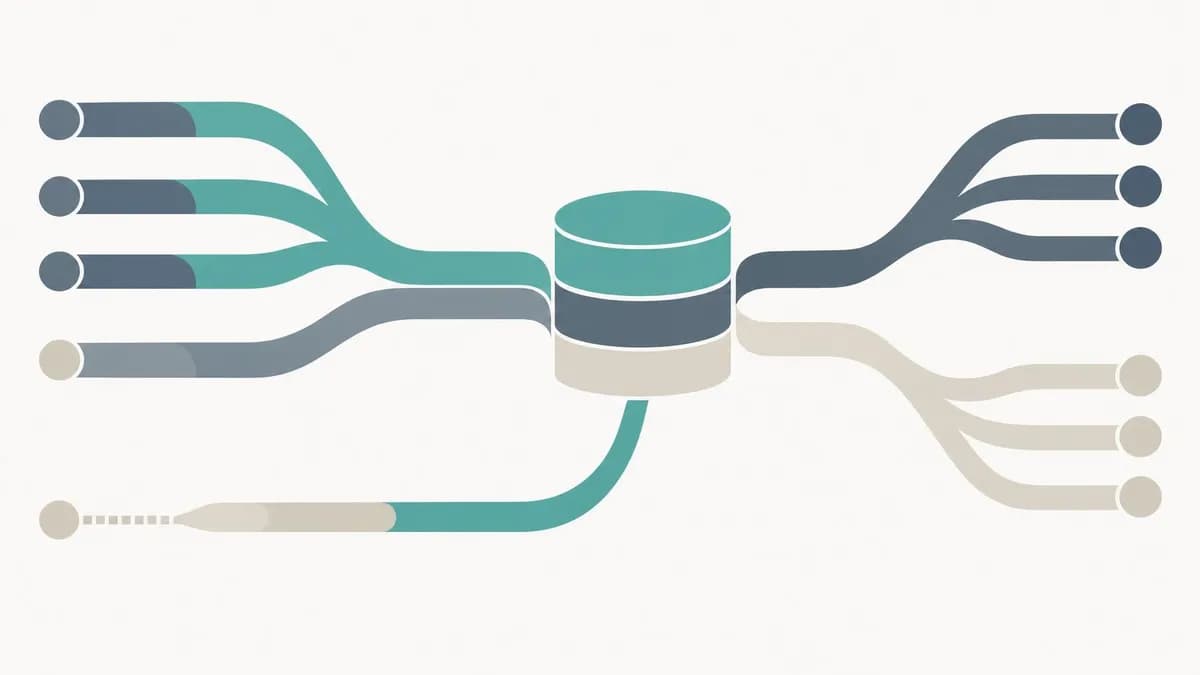
Valkey 9.2 حافظه نهان توزیعشده را معرفی کرد تا هزینه استنتاج هوش مصنوعی را تا ۴۰ درصد و تأخیر نخستین توکن را تا ۸۰ درصد بر روی خوشههای GPU موجود کاهش دهد. این انتشار اولین نسخه پایدار است که یک لایه حافظه نهان مشترک فراتر از حافظه GPU و میزبان را یکپارچه میکند.
لایه حافظه نهان توزیعشده برای استنتاج
اپراتورهایی که مدلهای وزنباز مانند Llama-3.1-70B را روی vLLM یا SGLang اجرا میکنند، با سقف سخت حافظه GPU روبرو میشوند: تانسورهای کلید-مقدار از تاریخچه گفتگو، تعاریف ابزار و پرامپتهای سیستمی حافظه را پر میکنند، خارجسازی و پیشپُرکردن مجدد گران را در طول پیشپُرکردن اجباری میسازند. حافظه نهان مشترک Valkey در مسیر نخستین توکن قرار میگیرد و به هر گرهای در خوشه اجازه میدهد تانسورهایی را بازیابی کند که حافظه محلی قبلاً خارج کرده است.
اتصال LMCache و نوع داده Path Hash
نسخه ۹.۲ حافظه نهان را به عنوان یک اتصالکننده LMCacheِ drop-in بستهبندی میکند که تنها یک تغییر پیکربندی نیاز دارد — بازنویسی کد برنامه لازم نیست. نوع داده جدید Path Hash، یک ساختار باکینگ رادیکس-درخت، جستجوی دقیق، تطبیق طولانیترین پیشوند و پیمایش پیشوند را برای یافتن طولانیترین پیشوند نهانشده و مکان شارد آن فراهم میکند، در حالی که بخش عمده دادههای هوش مصنوعی در حافظه GPU یا میزبان باقی میماند.
نتایج واقعی از Multiverse Computing
Ennio Pastore، مدیر پلتفرم هوش مصنوعی Multiverse Computing، گزارش داد که با GPUهای یکسان ۵۰ درصد درخواست بیشتر سرویس میشود در حالی که هدف میانه یک ثانیهای برای زمان تا نخستین توکن برآورده میشود. تأخیر میانه نخستین توکن در ترافیک معمول ۲۳ درصد و در ترافیک اوج ۹۵ درصد کاهش یافت. Multiverse همچنین بهبودهای تابآوری را به اتصالکننده LMCache مشارکت کرد، که حافظه نهان توزیعشده را در برابر خرابی گرهها و پارتیشنهای شبکه سخت کرد.
بنچمارکهای مصنوعی و مرزهای کارایی
بنچمارکهای Valkey پشته را با ۱۰۰ گفتگوی همزمان با ۱۲،۰۰۰ تا ۲۸،۰۰۰ توکن زمینه در هشت درخواست بر ثانیه بر روی دو گره GPU، هر کدام مجهز به هشت شتابدهنده H100، تحت فشار قرار داد. گرهها Llama-3.1-70B را از طریق vLLM و LMCache سرویس میدادند، پشتیبانی شده توسط یک خوشه سهشارد Valkey 9 در همان زون در دسترس. پروژه تقریبا ۲۵ درصد درخواست بیشتر و ۲۸ درصد توکن خروجی بیشتر اندازه گرفت، در حالی که لایه حافظه نهان حدود ۱۵ درصد به صورتحساب GPU اضافه کرد. این نتایج با گزارشهای اخیر AWS همسو دارد که نشان میدهد پارتیشن H100 در SageMaker تا ۸۹ درصد سریعتر از A100 عمل میکند، گزارشهای اخیر AWS.
اسناد انتشار مرزهای شفاف را مستند میکنند: حافظه نهان مشترک سود کمی دارد وقتی مجموعه کاری از قبل در حافظه GPU و میزبان جا میشود، یا وقتی درخواستها زمینه تکراری ندارند. این لایه نمیتواند محاسبه GPU بسازد وقتی پیشپُرکردن توکن جدید گلوگاه میشود. Valkey استقرار حافظه نهان در همان زون در دسترس به عنوان ناوگان GPU را توصیه میکند چون ترافیک بینزونی تأخیر و هزینه انتقال را در مسیر بحرانی نخستین توکن اضافه میکند.
کاهش سربار حافظه و شبکه در لایه داده
فراتر از حافظه نهان هوش مصنوعی، نسخه ۹.۲ هزینههای زیرساختی خود دیتاستور را هدف قرار میدهد. عکسهای فوری (snapshot) بدون فورک (forkless) و همگامسازی کامل رونوشت به صورت اختیاری از یک رشته پسزمینه به جای یک فرآیند سرور جداگانه استفاده میکنند، سربار حافظه کپی-دروننوشت در بارهای کار سنگین نوشتن را جلوگیری میکنند. این مکانیزم چهار بایت به هر کلید اضافه میکند و در صورت نیاز به فورک بازمیگردد.
فشردهسازی برای رونوشتدهی در حال اجرا به صورت هر رونوشت مذاکره میشود؛ LZ4 پهنای باند رونوشتدهی را ۵۲ درصد کاهش داد با کمتر از ۱ درصد سربار توان عملیاتی در بنچمارک ۳ میلیون کلید با میانگین ۳۱۵ بایت هر کدام. فشردهسازی عکس فوری کل جریان هم LZ4 و هم Zstandard را پشتیبانی میکند، با Zstandard که برای رونوشتدهی بینمنطقهای هدف قرار گرفته حیث هزینه شبکه غلبه دارد.
مجموعههای مرتب بزرگ اکنون از B+ tree به جای skiplist استفاده میکنند، سربار حافظه در هر عضو را ۳۶ تا ۴۳ درصد در تستی با ۵ میلیون عضو با المانهای ۲۰ بایتی کاهش میدهند. افزودنهای عملیاتی شامل تشخیص کلید داغ سمت سرور، نقشهای کنترل دسترسی قابل استفاده مجدد، اولویتبندی برای ضربههای قلب خوشه و رونوشتدهی، اتصالات اداری رزرو شده، و محدود کردن نوشتن اختیاری وقتی یک رونوشت عقب میافتد.
گامهای پیشنهادی برای اپراتورها
- نسبت پیشپُرکردن به رمزگشایی و نرخ بازیابی زمینه را در استقرار فعلی خود اندازه بگیرید تا بفهمید آیا لایه حافظه نهان Valkey سودده است.
- روش بنچمارک Valkey را به عنوان قالب تست قابل بازتولید برای پروفایلسازی ترکیب بار کار خود بکار ببرید.
- انتشارهای فرعی آتی را برای بهبودهای سازگاری حافظه نهان در طول ارتقاهای رولینگ رصد کنید.
گفتگو