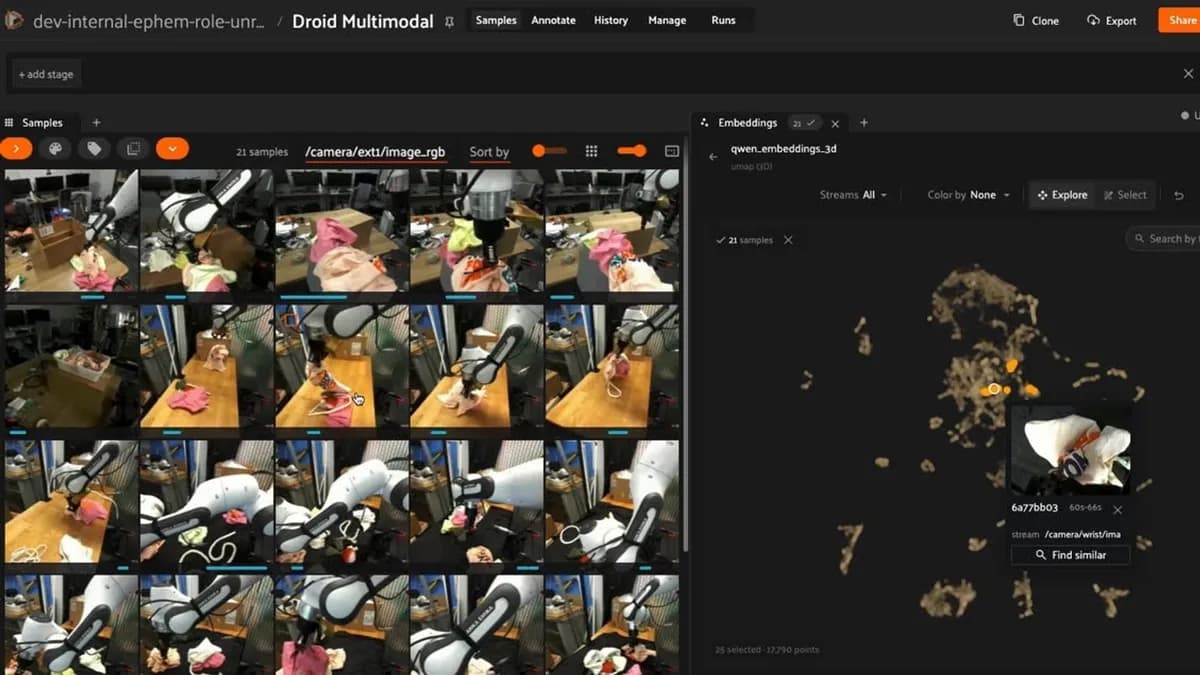
اگر فکر میکنید برندهٔ رقابت هوش مصنوعی، کسی است که مدل بزرگتری دارد، سخت در اشتباهید. دادههای جدید نشان میدهد تفاوت میان یک ربات پیشرو و یک نمونهٔ شکستخورده، در ساعتهایی است که تیمها صرف پاکسازی و سازماندهی دادهها میکنند.
طبق گزارش Voxel51 در نظرسنجی «وضعیت هوش مصنوعی فیزیکی ۲۰۲۶»، ۵۸٪ از زمان پروژههای تیمهای استثنایی صرف کارهای دادهای میشود؛ یعنی تقریباً سه برابرِ تیمهای در حال تقلا که تنها ۲۱٪ از وقت خود را به این موضوع اختصاص میدهند. این یافته، زیربنای عرضهٔ Voxel51 3.0 در ۱۵ اکتبر ۲۰۲۶ است.
برایان مور، همبنیانگذار و مدیرعامل شرکت، این انتشار را «مهمترین نسخهٔ شرکت تا به امروز» توصیف کرد. این پلتفرم برای کارهای حیاتی طراحی شده است که پس از عبور مدل از مرحلهٔ نمونهاول (Prototype) آغاز میشوند: بررسی شکستها، سازماندهی مجموعههای آموزشی و ارزیابی مدلها در سناریوهای دنیای واقعی.
برای درک این موضوع باید بدانید که اکثر توسعههای هوش مصنوعی بر مرحلهٔ نمونهاول تمرکز دارند، اما سیستمهای فیزیکی در رباتیک، تولید و مراقبتهای بهداشتی زمانی که با دنیای واقعی مواجه میشوند، شکست میخورند. هوش مصنوعی فیزیکی (Physical AI) — یعنی مدلهایی که برخلاف ChatGPT فقط متن تولید نمیکنند و باید در دنیای واقعی حرکت کنند و اشیا را لمس کنند — با چالشی به نام «دمدراز» (Longtail) روبروست. اینها همان موارد نادر اما حیاتی هستند که باعث میشوند یک ماشین خودران در یک پیچ خاص تصادف کند یا یک بازوی رباتیک در جراحی خطا کند. همانطور که در تحلیلهای قبلی ما دربارهٔ امنیت مدلهای بازمتن اشاره کردیم، مدلها در مواجهه با دادههای خارج از توزیع (Out-of-distribution) دچار لغزش میشوند.
برای حل این مشکل، تیمها به راهی نیاز دارند تا از یک خطای واحد مدل، هزاران نمونهٔ مشابه را در میان حجم عظیمی از دادهها پیدا کنند. Voxel51 3.0 با ادغام جستوجو، سازماندهی و ارزیابی در یک سامانه، این مسیر را هموار میکند. این شرکت اکنون نام محصول تجاری خود را به Voxel51 تغییر داده و نام FiftyOne را برای پروژه متنباز خود حفظ کرده است.
جستوجوی چندوجهی و دادههای سری زمانی
این پلتفرم برای ایجاد شاخصهای جستوجوی ترکیبی از LanceDB استفاده میکند. معماری ستونی LanceDB اجازه میدهد جستوجوی برداری — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه همسایهٔ چه کلمات دیگری است (بردار معنایی یا Embedding) — در کنار شاخصهای اسکالر (Scalar) و متنی کامل قرار بگیرد، در حالی که ذخیرهسازی را از محاسبات جدا میکند. این ساختار به تیمها اجازه میدهد بازیابی برداری معنایی را با فیلترهای متادیتای سنتی در محتواهای غیرساختاریافته و متادیتای ساختاریافته ترکیب کنند.
قابلیتهای فنی کلیدی این بخش عبارتند از:
- شاخصگذاری خودکار: سیستم بهطور خودکار مجموعههای داده را شاخصگذاری کرده و بردارها را محاسبه میکند تا پرسوجوها از روز اول در دسترس باشند.
- پشتیبانی از سری زمانی: امکان مشاهدهٔ چندین جریان حسگر (Sensor) روی یک خط زمانی واحد.
- بردارسازی در سطح قطعه: تیمها میتوانند لحظات خاصی از یک ضبط طولانی را بازیابی کنند، بهجای اینکه کل یک اپیزود را به عنوان یک بلوک واحد شاخصگذاری کنند.
- خط لولههای سفارشی: کاربران کنترل میکنند که کدام مدلها بردارها را تولید کنند و بهروزرسانیها چه زمانی رخ دهند. بهروزرسانیهای تدریجی به این معناست که تیمها نیازی به بازسازی کامل مجموعه داده ندارند.
برچسبگذاری عاملمحور و جریانهای کاری
عامل جدید Voxel51 Agent از پروتکل زمینهٔ مدل (MCP) استفاده میکند؛ استانداردی باز برای اتصال برنامههای هوش مصنوعی به ابزارهای خارجی. این عامل به بیش از ۱۰۰ ارائهدهنده مدل از جمله OpenAI، Anthropic و Google متصل میشود. این عامل از بیش از ۴۵ ابزار MCP، بیش از ۸۰ اپراتور و ۱۸ مهارت متنباز ساخته شده است.
بر اساس مستندات شرکت، برخی از جریانهای کاری این سیستم شامل موارد زیر است:
- رباتیک: جستوجوی هزاران اپیزود برای یافتن رفتارهای خاص جهت ساخت مجموعههای آموزشی هدفمند.
- ادراک: تبدیل یک خطای مدل به شناسایی سناریوهای مشابه در «دمدراز»، افزودن برچسبهای جدید و ارزیابی مجدد.
- تضمین کیفیت (QA): ارجاع موارد مشکوک و نامطمئن به بازبینهای انسانی برای آمادهسازی برچسبها.
به نقل از Voxel51، بنچمارک این وظایف روی مدلهای Claude Sonnet 5، Claude Opus 5، GPT-5.1 و Gemini 3.1 Pro نشان داد که تفاوت هزینهها تا ۱۵ برابر متغیر است. همچنین قابلیت «برچسبگذاری عاملمحور» معرفی شده که از مدلهای بینایی-زبانی (VLM) برای تولید برچسبها بر اساس دستورات زبان طبیعی و مثالها استفاده میکند. این رویکرد عاملمحور برای تسریع فرآیندهای پیچیده مشابه آنچه در پلتفرم Target Atlas برای پژوهشهای دارویی رخ داد، میتواند زمان توسعه سیستمهای فیزیکی را به شدت کاهش دهد.
حاکمیت داده و ردیابی منشأ
ریچی مارتوری، معمار ارشد شرکت، در ۹ اکتبر ۲۰۲۶ از یک سیستم ردیابی چهارسطحی پرده برداشت تا هر تغییر در برچسبها یا متادیتا به یک شخص یا پردازش خودکار متصل باشد:
- سطح استقرار (Deployment-level): لاگهای فعالیت که نشان میدهد چه کسی چه اقدامی انجام داده و این اقدام روی چه بخشهایی از استقرار اثر گذاشته است.
- سطح مجموعه داده (Dataset-level): لاگهای فعالیت برای ردیابی تغییرات درون هر دیتاست مجزا.
- سطح نمونه (Sample-level): تاریخچه ویرایش برای ردیابی تغییرات اعمال شده روی برچسبها و ویژگیها.
- نسخهبندی مجموعه داده: ایجاد снимگی (Snapshot) تغییرناپذیر برای مقایسه حالتهای تاریخی و بازتولید جریانهای کاری.
این معماری که بر پایه fiftyone-mq برای زمانبندی وظایف و Activity Core برای ردیابی رویدادها بنا شده، یک ردپای کامل (Audit Trail) برای سیستمهای هوش مصنوعی حساس به ایمنی ایجاد میکند.
طراحی مستقل از مدل
نسخه ۳.۰ بهگونهای طراحی شده که به هیچ مدل خاصی وابسته نباشد (Model-Agnostic). تیمها میتوانند از مدلهای بنیادی (Foundation Model) و مدلهای تخصصی دامنهٔ خودشان برای بردارسازی، برچسبگذاری خودکار و استنتاج — یعنی لحظهای که مدل واقعاً جواب تولید میکند و شبیه به خودِ آشپزی است، نه دوره آموزش آشپز (استنتاج یا Inference) — استفاده کنند، بدون اینکه در یک پشتهٔ نرمافزاری پیشفرض محبوس شوند.
این موضوع حیاتی است زیرا مدلهای بنیادی عمومی عمدتاً از متن و تصاویر اینترنتی یاد گرفتهاند و تجربه بسیار محدودی از دادههای چندوجهی حسگرهای تجسمیافته (Embodied) دارند که سیستمهای فیزیکی تولید میکنند.
برای مدیران کسبوکار، این تغییر سیگنالی است که عصر «مدلمحوری» به پایان رسیده و مزیت رقابتی به لایه «دادهمحوری» منتقل شده است. اگر تیم شما کمتر از نیمی از وقتش را صرف سازماندهی دادهها میکند، احتمالاً در دسته تیمهای «در حال تقلا» قرار دارید. این بهینهسازی در لایه داده، مشابه رویکرد Trimble در مدیریت ناوگان است که با حذف کارهای دستی، بهرهوری عملیاتی را به شدت افزایش داد.
شرکت Voxel51 با ارائه دسترسی سلفسرویس در app.voxel51.com و همکاری با Nebius AI Cloud برای برگزاری کارگاهها، تلاش میکند سد ورود به هوش مصنوعی تخصصی را بشکند. آنها معتقدند در حوزههایی بهجز رانندگی خودکار که بودجههای عظیمی دارند، تنها خندق دفاعی واقعی، خط لولههای دادهٔ اختصاصی است.
اکنون میتوانید این جریانهای کاری را بهصورت رایگان روی دادههای خود آزمایش کنید یا منتظر نتایج نه کارگاه هوش مصنوعی فیزیکی باشید که تا نوامبر ۲۰۲۶ در سراسر کانادا و ایالات متحده برگزار میشوند.
گام بعدی شما
- اگر روی سیستمهای سختافزاری کار میکنید، نسبت زمان صرفشده برای «جمعآوری داده» در برابر «تنظیم مدل» را محاسبه کنید تا جایگاه رقابتی خود را بسنجید.
- قابلیتهای جستوجوی ترکیبی LanceDB را برای مدیریت دادههای غیرساختاریافته در پروژههای خود بررسی کنید.
- برای کاهش هزینههای برچسبگذاری، مدلهای مختلف VLM را روی نمونههای کوچک دادههای خود مقایسه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو