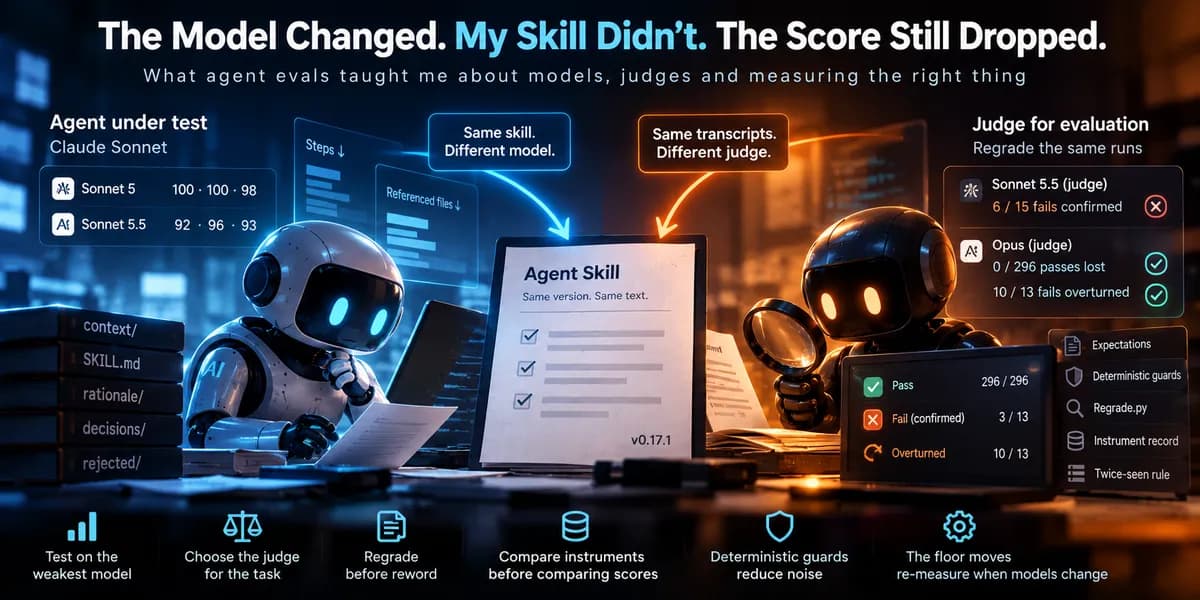
تصور کنید هر روز با خطکشی اندازهگیری میکنید که هر چند روز یک بار یک میلیمتر کوچکتر میشود؛ طبیعتاً نتیجه میگیرید پروژهتان در حال رشد است، در حالی که هیچ تغییری نکرده است. در دنیای عاملهای هوش مصنوعی، این «خطکش» همان مدل زبانی است که نقش داور را ایفا میکند و تغییر آن میتواند نتایج ارزیابی را بهطور کامل وارونه کند.
به نقل از گزارشهای توسعهدهنده پروژه Keep the Why، در ۷ اکتبر ۲۰۲۶ اتفاق عجیبی رخ داد: توسعهدهندهای که روی مهارت حافظه پروژه کار میکرد، متوجه شد بهروزرسانی سادهی یک مدل از Claude Sonnet 5 به Sonnet 5.5 باعث شد نمرات عملکرد عامل بهشدت سقوط کند، در حالی که هیچ تغییری در کد زیربنایی ایجاد نشده بود. این وضعیت نشان میدهد که ارزیابی عاملها بهشدت ناپایدار است چون هم اجراکننده و هم داور، اهدافی متحرک هستند. این ناپایداری در ارزیابی، یکی از دلایل اصلی است که باعث میشود عاملهای هوش مصنوعی در محیطهای عملیاتی با شکست مواجه شوند، چرا که رفتاری که در محیط تست ایدهآل به نظر میرسد، در واقعیت با تغییرات کوچک مدل تغییر میکند.
در اکثر سیستمها، یک مدل وظیفه اجرا را دارد و مدل دیگر نتیجه را نمره میدهد. اگر نسخه دقیق داور و عامل ثبت نشود، یک نقص در ابزار اندازهگیری دقیقاً شبیه به نقص در محصول به نظر میرسد. مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — وقتی در نقش داور قرار میگیرد، معیارهای «قبول» یا «رد» را بهصورت خاموش تغییر میدهد و برنامهنویسان را مجبور میکند ساعتها وقت خود را صرف اصلاح پرامپتهایی کنند که اصلاً خراب نبودهاند.
همانطور که در تحلیلهای قبلی ما دربارهی پایداری مدلهای زاینده اشاره کردیم، وابستگی به نامهای مستعار (Alias) بهجای نسخههای دقیق، یکی از بزرگترین ریسکهای زیرساختی است.
توهمِ پسرفت (Regression)
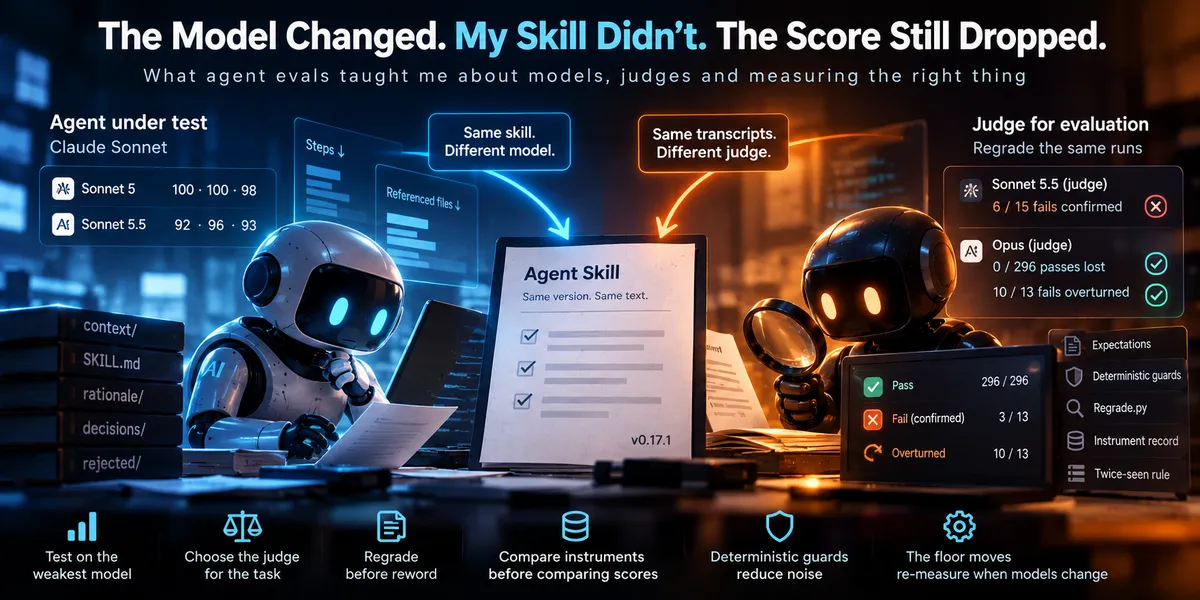
طبق مستندات تستهای سری ۰.۱۸.۰، وقتی عامل و داور هر دو Sonnet 5 بودند، نمرات ۱۰۰، ۱۰۰ و ۹۸ از ۱۰۱ ثبت شد. در این حالت، هر مورد بهطور میانگین ۱۳ نوبت تعامل، ۱۱ فراخوانی ابزار و ۲۳۰۰ توکن تفکر مصرف میکرد.
اما چند روز بعد، در تگ ۰.۱۸.۲ که هر دو نقش را به Sonnet 5.5 سپرده بود، نمرات به ۹۲، ۹۶ و ۹۳ از ۱۰۱ سقوط کرد.
این افت فقط در نمره نبود، بلکه «شکل جلسه» (Session Shape) هم تغییر کرد؛ تعداد نوبتها به ۶، فراخوانی ابزارها به ۴ و توکنهای تفکر به ۲۵۰ مورد در هر کیس کاهش یافت. هیچ تغییری در مخزن کد چنین جهشی را توجیه نمیکرد. ابزار اندازهگیری در زیرِ تست تغییر کرده بود.
این اتفاق تنها به این دلیل قابل شناسایی بود که هر اجرا، چیزی فراتر از یک نمره را ثبت میکرد. سیستم تمام جزئیات از جمله شناسهی مدلهای حلشده (Resolved Model IDs)، هش پرامپت داور، نسخهی CLI و آمارهای شکل جلسه را ذخیره کرده بود. بدون این دادهها، خوانش بدیهی این بود که «نسخه ۰.۱۸.۲ باعث افت مهارت شده است» و پاسخ منطقی، بازنویسی مهارت بود؛ یعنی تلاش برای اصلاح چیزی که اصلاً خراب نبود.
اصل «ضعیفترین مدل»
برای مقابله با این مشکل، نویسنده قانونی نامتقارن را اجرا کرد: عامل را روی ضعیفترین مدلی که قصد پشتیبانی از آن را دارید، تست کنید. این کار مانع میشود که یک مدل قدرتمند بهطور خاموش، دستورالعملهای مبهم شما را جبران کند. اگر مهارتی فقط به دلیل قدرت مدل جواب میدهد و مدل شکافهای دستورالعمل را پر میکند، یعنی آن مهارت واقعاً تست نشده است. این حساسیت به کیفیت ورودیها و ابزارها یادآور تجربهای است که در آن مدل Claude Haiku 4.5 در مواجهه با ابزارهای مسموم دچار افت دقت شد و نشان داد که مدلهای کوچکتر در برابر نویزهای محیطی آسیبپذیرترند.
البته «جدیدتر» همیشه به معنای «قویتر» نیست. Sonnet 5.5 جدیدتر از Sonnet 5 است، اما در مهارت حافظه پروژه، خوانندهی ضعیفتری بود. این مدل گامهای کمتری برمیداشت و فایلهای مرجع را بهمراتب کمتر باز میکرد.
این موضوع یک نکته ظریف و حیاتی را آشکار میکند: اصل کار این است که مهارت را روی ضعیفترین سطح پشتیبانیشده تثبیت کنید و سپس هر بار که مدلِ داخل آن سطح تغییر کرد، دوباره اندازهگیری کنید. در حالی که یک مدل قویتر معمولاً کارها را آسانتر میکند، میتواند به شکل متفاوتی شکست بخورد؛ مثلاً کارهایی بیش از آنچه از او خواسته شده انجام دهد. به همین دلیل است که ممنوعیتهای سخت بهجای سپردن به داور، بهصورت قطعی (Deterministic) بررسی میشوند.
شناسایی نقاط ضعف ساختاری
این شکست اتفاقاً یک نقص بحرانی در طراحی مهارت را افشا کرد. فایل SKILL.md اغلب نام یک قانون را میآورد و برای جزئیات عملیاتی به یک فایل مرجع اشاره میکرد. مدل قویتر (Sonnet 5) این فایلها را باز میکرد، اما مدل ضعیفتر (Sonnet 5.5) اغلب این کار را نمیکرد.
در تمام اجراهای شکستخوردهی local-lint-auto، عامل اقدام به نصب linter در یک محیط مجازی کرد؛ عملی که در بخش تنظیماتِ فایل مرجع صراحتاً ممنوع شده بود. هیچکدام از آن اجراهای شکستخورده، آن بخش مرجع را باز نکرده بودند. تنها موردی که فایل مرجع را باز کرد، در تست موفق شد.
این منجر به یک قانون معماری جدید شد: اگر نادیده گرفتن یک قانون میتواند منجر به آسیب شود، بند عملیاتی باید مستقیماً در SKILL.md باشد، نه پشت یک اشارهگر یا لینک. برای رویههایی که طولانیتر از یک بند هستند، عبارت مبهم «این مرجع را ببینید» با یک محرک «خواندن-قبل-از-اقدام» در نقطه عملیاتی جایگزین شد.
این رویکرد از دو extrem جلوگیری میکند: خواندن تمام ارجاعات، هزینههای جلسه را چند برابر میکند و انتقال همه چیز به فایل اصلی، بار فعالسازی (Activation Load) را بیش از حد زیاد میکند. مدل قویتر بهطور خاموش این وابستگی را جبران کرده بود، و دقیقاً به همین دلیل است که عامل تحت تست باید در پایینترین سطح قرار بگیرد.
داور بهعنوان منبع نویز
همه شکستها مربوط به مهارت عامل نبود؛ برخی ناشی از خودِ سیستم ارزیابی (Evaluation Harness) بود:
- طرحهای سختافزاری (Hard-coded Schemas): یک بررسی قطعی داشت که نسخه طرح در آن ثابت شده بود و در هر نسخهی جدیدتر شکست میخورد.
- دادههای نامعتبر (Invalid Fixtures): یک مورد تست در شرایطی قرار داشت که رفتار مورد نظر هرگز رخ نمیداد، و همین باعث میشد داور روی رفتارهای کاملاً یکسان، نمرات متناقض (قبول/رد) بدهد.
- عدم تطابق مشخصات (Spec Mismatches): دو متن انتظار، چیزهایی را میخواستند که مهارت هرگز نیاز نداشت. اگر تست میگوید «باید» در حالی که محصول میگوید «میتواند»، ارزیابی غلط است. بازنویسی محصول برای راضی کردن چنین تستی، یعنی آموزش مدل بر اساس یک باگ در تست.
برای جداسازی این موارد، ابزاری به نام regrade.py ساخته شد. این ابزار اجازه میدهد بدون اجرای دوبارهی جلسه عامل، از داور درباره همان رفتار قبلی (با استفاده از ترنسکریپتهای ذخیره شده و diffهای دیسک) سؤال شود. این کار واریانس عامل را از واریانس داور جدا میکند. این تلاش برای بهینهسازی ارزیابی، مشابه رویکردی است که در آن ترکیب کد قطعی و مدل زبانی منجر به کاهش چشمگیر هزینههای نمرهدهی بدون افت کیفیت شد.
در یک باز-نمرهدهی روی ۱۵ مورد شکست ذخیره شده، داور Sonnet 5.5 تنها ۶ مورد از احکام قبلی خودش را تأیید کرد. اما وقتی داور به Opus 5.5 ارتقا یافت، نتایج بهشدت پایدار شد:
- داور Sonnet 5.5: نمرات بین ۹۸ تا ۱۰۰ (در سه اجرا) نوسان داشت.
- داور Opus 5.5: بهطور ثابت ۱۰۲ مورد از ۱۰۳ مورد را در سه اجرا تأیید کرد.
Opus 5.5 فقط نمرات بالاتر نداد، بلکه ابزار استوارتر بود. این مدل تمام ۲۹۶ مورد «قبول» را همانطور حفظ کرد. از ۱۳ شکست، ۳ مورد را تأیید و ۱۰ مورد را لغو کرد. برخی از این لغوها شامل مواردی بود که داور قبلی حتی در استدلال خودش رفتار را «قبول» خوانده بود اما در نهایت نمره منفی داده بود، یا برای نوشتی نمره کم کرده بود که مهارت صراحتاً آن را میطلبید.
قوانینی برای ارزیابی استوار
برای جلوگیری از «اصلاح» رفتارهای درست، این تمرینات سختگیرانه توصیه میشود:
- ثبت ابزار: بهجای نام مستعار، شناسهی دقیق مدل، هش پرامپت داور، نسخهی CLI و آمار شکل جلسه را ثبت کنید. نمرهای که ابزارش ثبت نشده باشد، ارزش کمی دارد.
- باز-نمرهدهی قبل از تغییر متن: قبل از تغییر پرامپت عامل، با
regrade.pyبررسی کنید که آیا شکست واقعی است یا خطای داور. قبل از هر دو، متن انتظار (Expectation Text) را چک کنید. - قانون تکرار برای تغییر: تنها زمانی جمله جدیدی به مهارت اضافه کنید که یک نوع شکست دو بار دیده شده باشد. اضافه کردن ۹ جمله برای موارد تکگیر، حجم مهارت را ۱۷٪ زیاد کرد اما باعث افت در موارد مجاور شد بدون اینکه بهبود قابل اندازهگیری ایجاد کند.
- حفاظهای قطعی: برای ممنوعیتهای سخت (مثل «هرگز در مسیر context/ ننویس» یا «هرگز رمز را روی دیسک نگذار») از بررسیهای مکانیکی استفاده کنید که هیچ تخلفی را نمیپذیرند.
- دروازههای سری: بهجای تکیه بر یک اجرای «شانسی» ۱۰۰٪، سه اجرای کامل و قانون تکرارپذیری را الزامی کنید.
- حفظ اندازهگیریهای شکستخورده: سریهایی که به دلیل تغییر خطکش شکست خوردند را نگه دارید؛ اینها اغلب آموزندهتر از اجراهای تمیز هستند.
در سری ۰.۲۰.۰، با استفاده از Sonnet 5.5 بهعنوان عامل و Opus 5.5 بهعنوان داور، سیستم تمام مراحل را با نمرات ۱۰۳، ۱۰۴ و ۱۰۳ از ۱۰۴ پشت سر گذاشت.
این تغییر متدولوژی، سؤال بنیادی دیباگینگ AI را عوض میکند. بهجای اینکه بپرسیم «چه چیزی را در پرامپت تغییر دهم؟»، اولین سؤال باید این باشد: «آیا چیزی که اندازهگیری میشود تغییر کرده، یا خطکش؟» این سؤال تا به حال نویسنده را چندین بار از «اصلاح» رفتارهای درست نجات داده است.
گام بعدی شما
برای کسانی که عاملهای تولیدی (Production) میسازند، گام بعدی بازبینی مجموعه ارزیابیهاست. بررسی کنید آیا نرخ موفقیت شما به یک نسخه خاص از مدل وابسته است یا یک نام مستعار کلی که هر شب تغییر میکند. نسبت به عامل بدبین باشید، داور را اندازهگیری کنید و همیشه ابزار را ثبت کنید.
- مجموعه ارزیابیهای فعلی خود را بازبینی کنید و ببینید آیا نرخ موفقیت شما به یک نسخه خاص از مدل وابسته است یا یک نام مستعار کلی که هر شب تغییر میکند.
- برای ممنوعیتهای حیاتی در عاملها، بهجای استفاده از مدل داور، از اسکریپتهای بررسی قطعی (Deterministic) استفاده کنید.
- یک ابزار ساده برای باز-نمرهدهی (Regrade) روی دادههای ذخیره شده بسازید تا واریانس داور را از واریانس عامل جدا کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو