اگر برای هر پاسخِ فنیِ مدلهای هوش مصنوعی، ۸۰ سنت هزینه میکنید، باید بدانید که میتوان این رقم را به ۳ سنت کاهش داد بدون آنکه ذرهای از دقت فدا شود. این یعنی عبور از دوران تکیه بر «حس» مدلهای بزرگ و ورود به عصر ارزیابیهای مهندسیشده. یک خط لوله ارزیابی ترکیبی با استفاده از Claude Sonnet و یک مدل تخصصی به نام Jev میتواند پاسخهای فنی هوش مصنوعی را با دقتی در سطح انسان و با هزینه تنها سه سنت به ازای ۱۸۸ پاسخ، نمرهدهی کند. این رویکرد مشکل «داورِ داور» را حل میکند؛ وضعیتی که در آن ارزیابان مدل زبانی (LLM) اغلب با صحیح دانستن همه پاسخها، سیستم را تملق میکنند یا در شناسایی خطاهای فنی ظریف ناتوان هستند. این تلاش برای بهینهسازی هزینهها در راستای رویکردهایی است که ابزارهایی مانند laya-evals را برای رساندن هزینه ارزیابی به صفر معرفی کردهاند.
ساخت یک داور قابلاعتماد، بزرگترین گلوگاه برای کسبوکارهایی است که از تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — استفاده میکنند. همانطور که در تحلیل قبلی ما دربارهی شکست عاملهای هوش مصنوعی در تستهای ایمیل بدون مرزهای سختگیرانه اشاره کردیم، فاصله بین یک پاسخ «باورپذیر» و یک پاسخ «صحیح»، همان نقطهای است که اکثر سیستمهای عملیاتی در آن فرو میپاشند. در محصولات فنی، حتی یک اشتباه در یک رقم از برگه مشخصات (Datasheet)، میتواند منجر به شکست محصول یا از دست دادن مشتری شود.
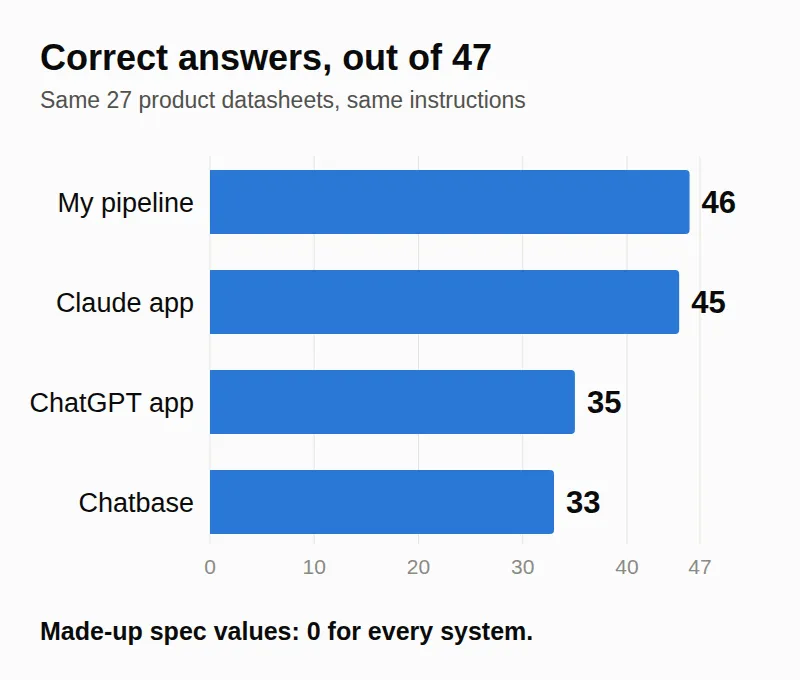
در ۳ اکتبر ۲۰۲۶، یک توسعهدهنده جزئیات فرآیند کالیبراسیون یک داور مدل زبانی را منتشر کرد تا آن را با یک استاندارد انسانی خاص تطبیق دهد. برای این کار از مجموعهدادهای شامل ۲۷ فایل PDF محصول و ۴۷ پرسش به سبک مشتریان استفاده شد. نکته مهم این بود که سه مورد از این PDFها اسکنشده بودند و هیچ لایه متنی (Text Layer) نداشتند. هدف، ارزیابی چهار سیستم مختلف بود: یک خط لوله سفارشی که از Claude Sonnet از طریق API به همراه ارجاعات به صفحات استفاده میکرد، اپلیکیشن Claude (که مدل Opus را با اسناد موجود در یک پروژه اجرا میکرد)، اپلیکیشن ChatGPT (در حالتی که قابلیت تفکر یا Thinking خاموش بود) و پلتفرم Chatbase (در طرح رایگان با مدل پیشفرض).
شکاف عملکرد
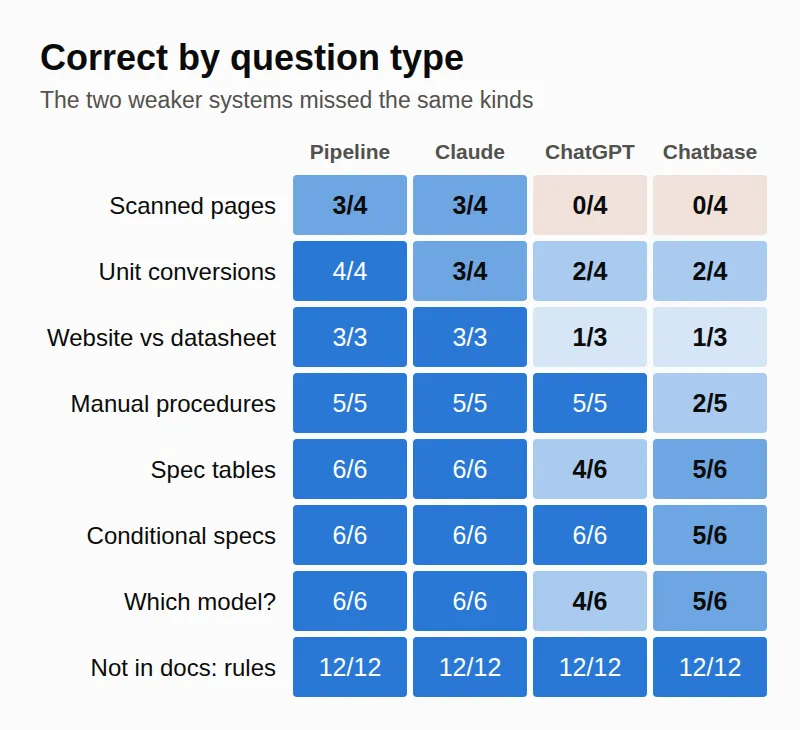
نتایج نشان داد که خط لوله سفارشی و اپلیکیشن Claude در رتبههای اول قرار گرفتند و به ترتیب ۴۶ و ۴۵ پاسخ صحیح کسب کردند. در مقابل، اپلیکیشن ChatGPT و Chatbase بهشدت دچار مشکل شدند و نمرات ۳۵ و ۳۳ را به دست آوردند. نکته جالب این بود که هیچکدام از سیستمها مقادیر مشخصات فنی را از خودشان ابداع نکردند (توهم نزدند)، اما سیستمهای ضعیفتر با ادعای اینکه «پاسخ در اسناد موجود نیست» در حالی که پاسخ واقعاً وجود داشت، بهصورت خاموشتر شکست خوردند.
نقاط شکست سیستمها
بر اساس بررسیهای انجامشده، شکستها تصادفی نبودند و الگوهای فنی مشخصی داشتند:
- اسناد اسکنشده: سیستمهایی که صرفاً به لایههای متنی متکی بودند، PDFهای اسکنشده را به عنوان صفحات خالی میدیدند. هر سوالی که پاسخ آن فقط در اسناد اسکنشده بود، با پاسخ «مشخص نشده است» مواجه شد.
- ظرافتهای زمینهای (Contextual Nuance): مدلها اغلب متوجه نمیشدند که محدوده عملکرد یک محصول بر اساس حالت (Mode) یا متریالی که اندازهگیری میشود، تغییر میکند. برای مثال، ممکن بود محصولی در صفحه اول یک محدوده را تبلیغ کند، اما در یک حالت خاص از همان محصول، این محدوده به یکدهم کاهش یابد.
- تبدیل واحدها (Unit Conversion): هوش مصنوعی اغلب با اطمینان کامل پاسخ اشتباه میداد؛ زیرا مقدار را از یک واحد به واحد دیگر تبدیل میکرد اما محدودیت پایینتری که در واحد درخواستی مشتری ذکر شده بود را نادیده میگرفت.
- تضاد منابع: وقتی بین یک وبسایت و یک برگه مشخصات تضاد وجود داشت — مثلاً صفحه محصول مقداری را ذکر میکرد که دو برابر مقدار ذکر شده در Datasheet بود — سیستمهای ضعیفتر نتوانستند Datasheet را به عنوان منبع اصلی حقیقت اولویتبندی کنند.
قوانین دقت فنی
قبل از اجرای سیستمها، توسعهدهنده مجموعهای از قوانین سختگیرانه را برای مدیریت موارد خاص (Edge Cases) تعریف کرد که هیچ PDFی نمیتوانست آنها را حل کند. این قوانین بیش از هر ترفند پرامپتی بر کیفیت پاسخها اثر داشت:
- برتری برگه مشخصات (Datasheet Supremacy): برگه مشخصات همیشه بر صفحه محصول برتری دارد. در صورت تضاد، مقدار Datasheet ارائه شود و ذکر گردد که احتمالاً صفحه وب دارای خطا است.
- ممنوعیت ردِ ساده: هرگز از عبارت ساده «در اسناد ما نیست» استفاده نشود. در عوض، ذکر شود که پاسخ در اسناد منتشر شده موجود نیست و یک آدرس ایمیل برای پرسوجوی بیشتر ارائه گردد.
- سختگیری در گواهینامهها: تایید گواهینامهها (Certifications) تنها در صورتی انجام شود که سند صراحتاً به آن اشاره کرده باشد؛ در غیر این صورت، کاربر برای تایید به ایمیل ارجاع داده شود.
- ایجاز و اختصار: فقط به آنچه پرسیده شده پاسخ داده شود. افزودن شرایط اضافی، خریداران را گیج کرده و منجر به پرسشهای بیشتر میشود.
حلقه کالیبراسیون
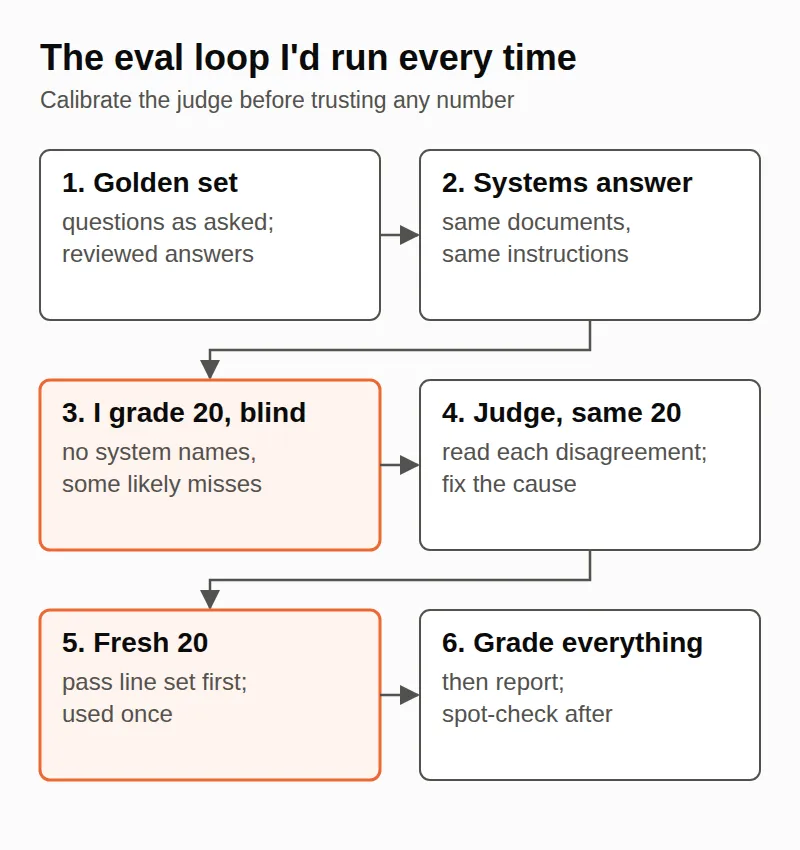
برای ساخت داوری که بتوان به آن اعتماد کرد، یک حلقه کالیبراسیون دقیق پیادهسازی شد. این کار شامل ایجاد یک «مجموعه طلایی» (Golden Set) از سوالات و پاسخها بود. سپس ۲۰ پاسخ بهصورت کور (Blind) نمرهدهی شدند — بدون ذکر نام سیستم، ۵ پاسخ از هر سیستم، همراه با اشتباهات احتمالی — تا قضاوت انسانی با داور هوش مصنوعی مقایسه شود.
تستهای اولیه نشان داد که تنها ۱۳ مورد از ۲۰ مورد توافق داشتند. توسعهدهنده متوجه شد که داور هوش مصنوعی شکست خورده است چون خودِ کلید پاسخهای انسانی ناسازگار بود. سه پاسخ در مجموعه طلایی اشتباه بود. نمرهدهی پاسخهای واقعی نشان داد که ارزیاب انسانی بر اساس متن چاپ شده در Datasheet پاسخ داده بود، حتی وقتی تبدیل واحد در آن اشتباه به نظر میرسید، و این مورد را بهطور جداگانه علامتگذاری کرده بود. پس از اصلاح کلید، نرخ توافق جهش کرد. این تأکید بر نقش کلیدی انسان در اعتبارسنجی، یادآور این واقعیت است که ارزیابی انسانی همچنان تنها معیار قابلاتکا برای همراستاسازی مدلهای زبانی است.
برای جلوگیری از تله «توافق ساده» — جایی که داور برای اینکه موفق به نظر برسد، همه چیز را درست میزند — از معیار کاپای کوهن (Cohen's kappa) استفاده شد. این معیار آماری اثر شانس را اصلاح میکند و میپرسد عملکرد داور چقدر بالاتر از حد شانس است، نسبت به اینکه چقدر میتوانست بالاتر از حد شانس باشد. نمره ۰ یعنی عملکردی در حد شانس و نمره ۱ یعنی تطابق کامل.
معماری ترکیبی
برای بهینهسازی هزینه و دقت، توسعهدهنده از استفاده از مدلهای پیشرو مانند Sonnet برای هر نمره فاصله گرفت و یک داور ترکیبی ساخت:
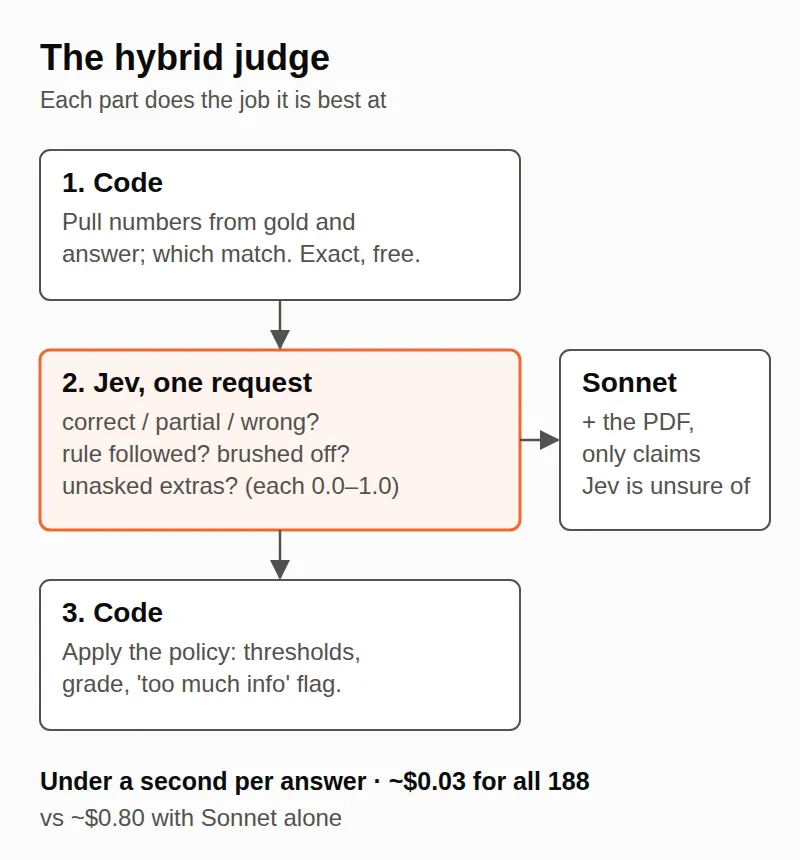
- کد قطعی (Deterministic Code): استخراج و مقایسه اعداد را بر عهده دارد. این کار مانع از آن میشود که LLM مشخصات مشابه را با هم اشتباه بگیرد (مثلاً ±(1.2% + 5) را با ±(0.8% + 5) اشتباه نگیرد).
- مدل Jev (TypeSafe): یک مدل «سیستم یک» است که زبان طبیعی را میخواند و پاسخهای تایپشده را همراه با احتمالات برمیگرداند و نیاز به تجزیه (Parse) متون طولانی را از بین میبرد.
- لایه سیاستگذاری (Policy Layer): حکم نهایی در کد مدیریت میشود. در هر درخواست برای هر پاسخ، چهار سوال بهطور همزمان پرسیده میشود: حکم نهایی (درست، جزئی، غلط)، آیا پاسخ مشتری را «سادهانگاری» کرده است، آیا جزئیات اضافی و نپرسیده را آورده است، و آیا قوانین خاص رعایت شدهاند یا خیر.
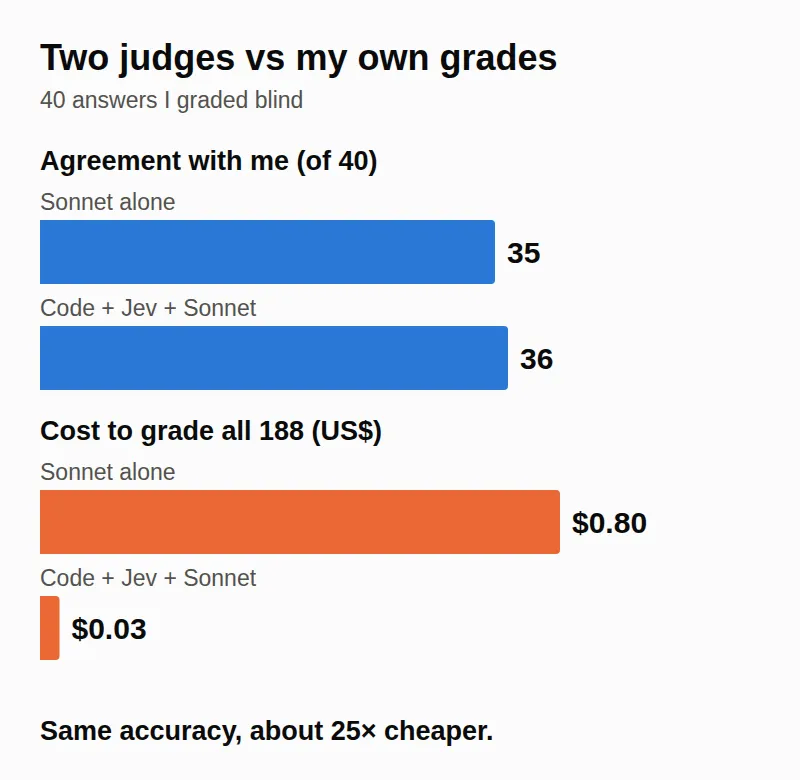
این رویکرد ترکیبی هزینه هر ۱۸۸ پاسخ را از ۰.۸۰ دلار (با استفاده از Sonnet تنها) به تقریباً ۰.۰۳ دلار کاهش داد، در حالی که توافق با ارزیاب انسانی را به ۳۶ از ۴۰ مورد افزایش داد. این سیستم برای هر پاسخ حدود ۲۰۰۰ توکن مصرف میکند و در کمتر از یک ثانیه اجرا میشود.
اصلاح سیاستها
آخرین مانع، مشکل «اطلاعات بیش از حد» بود. در ابتدا، داور پاسخهایی را که جزئیات نپرسیده را اضافه میکردند جریمه میکرد و اگر Jev ۹۰٪ مطمئن بود که مشخصات اضافی اضافه شده، نمره را به «جزئی» کاهش میداد. با این حال، تست روی ۲۰ پاسخ جدید نشان داد که انسانها «محتوا» و «طول متن» را جداگانه نمرهدهی میکنند. یک پاسخ میتواند از نظر واقعیت درست باشد اما بیش از حد طولانی باشد.
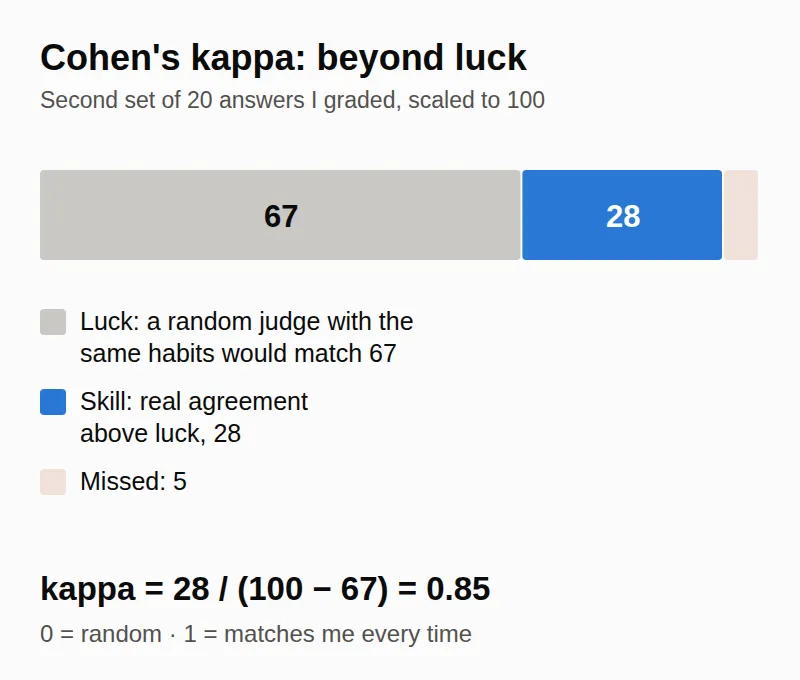
با تبدیل جریمه به یک «پرچم» (Flag) جداگانه به جای کاهش نمره، توافق داور با انسان به ۱۹ از ۲۰ رسید و کاپای کوهن به ۰.۸۵ افزایش یافت. این نتیجه در برابر یک «خط عبور» (Pass Line) که قبل از تست نوشته شده بود (حداقل ۱۶ از ۲۰ پاسخ درست و کاپای حداقل ۰.۶) تایید شد.
حلقه پیادهسازی
برای جلوگیری از اشتباه رایج گزارش اعداد از یک داور تستنشده، توسعهدهنده توالی جدیدی را پیشنهاد کرد:
۱. ساخت مجموعه طلایی: ایجاد سوالات مطابق با نحوه پرسش مشتری و بازبینی پاسخهای طلایی.
۲. اجرای سیستم: تمام سیستمها با استفاده از اسناد و دستورالعملهای یکسان پاسخ دهند.
۳. نمرهدهی کور: یک انسان ۲۰ پاسخ را بهصورت کور نمرهدهی کند و داور نیز همان ۲۰ مورد را ارزیابی کند.
۴. کالیبراسیون: بررسی هر مورد عدم توافق و رفع علت آن (که معمولاً کلید پاسخ است).
۵. تایید: نوشتن خط عبور، تست روی ۲۰ پاسخ جدید و تنها پس از آن، نمرهدهی کل مجموعه.
کل این فرآیند حدود ۸ دلار هزینه API داشت که بیشتر آن صرف اشتباهات اولیه شد. این تغییر در رویکرد نشان میدهد که آینده ارزیابی هوش مصنوعی در مدلهای بزرگتر نیست، بلکه در ادغام تنگاتنگ کدهای قطعی و مدلهای احتمالی LLM است. برای خواننده، این بدان معناست که هزینه نگهداری یک پایگاه دانش باکیفیت و تاییدشده بهشدت در حال کاهش است و اجرای ارزیابیهای مستمر روی هر بهروزرسانی Datasheet امکانپذیر میشود.
برای پیادهسازی این روش، با ساخت یک مجموعه طلایی شامل ۲۰ تا ۵۰ پرسش که سختترین موارد خاص (Edge Cases) شما را نمایندگی میکنند شروع کنید و هرگز به یک داور LLM اعتماد نکنید مگر اینکه کاپای کوهن آن را در برابر یک متخصص انسانی محاسبه کرده باشید.
گام بعدی شما
- یک «مجموعه طلایی» شامل ۲۰ تا ۵۰ پرسش از سختترین لبههای (Edge Cases) دادههای خود بسازید.
- هرگز به داور مدل زبانی اعتماد نکنید مگر اینکه مقدار کاپای کوهن آن را در برابر یک متخصص انسانی محاسبه کرده باشید.
- بخشهای استخراج عدد را از مدل زبانی جدا کرده و به کدهای برنامهنویسی (Regex یا Parsers) بسپارید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو