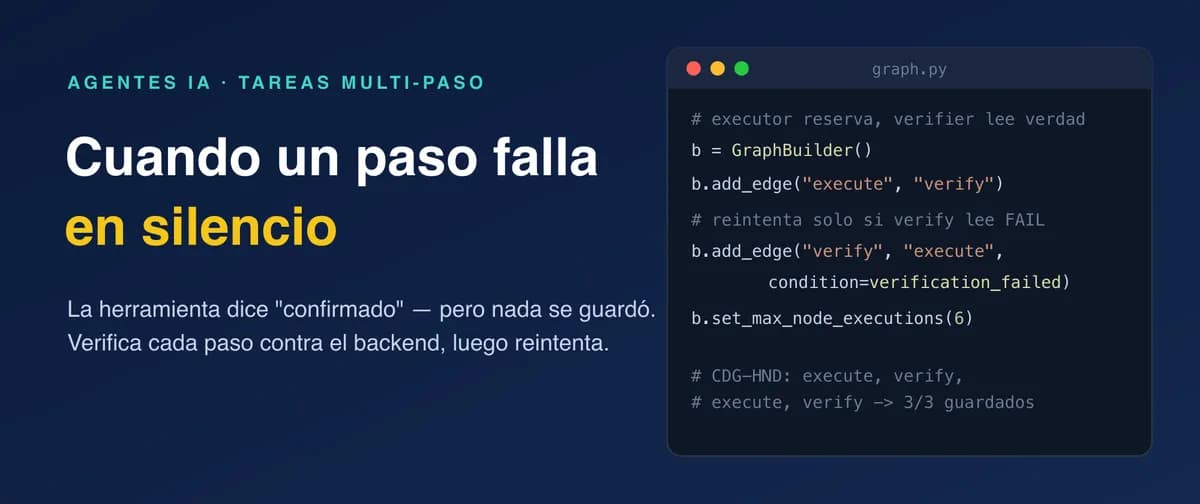
اگر امروز یک عامل هوشمند برای اتوماسیون کسبوکارتان طراحی میکنید، احتمالا با کابوسی به نام «موفقیت کاذب» روبهرو هستید. تصور کنید عاملی که قرار بود رزروهای مشتری را مدیریت کند، با اطمینان کامل گزارش میدهد که همه کارها انجام شده، اما وقتی سراغ دیتابیس میروید، هیچ رکوردی وجود ندارد.
این وضعیت، «شکست خاموش» (Silent Failure) نام دارد؛ یک آسیبپذیری حیاتی که در آن یک ابزار وضعیت «تأیید شد» (confirmed) را برمیگرداند، اما عملیات نوشتن در بکاِند با شکست مواجه شده است. این اتفاق منجر میشود که عامل یک موفقیت غیرواقعی را گزارش کند. اعتماد به پاسخهای «تأیید شده» بدون اعتبارسنجی مجدد، به یکی از رایجترین روشهای شکست عاملها در جریانهای کاری چندمرحلهای تبدیل شده است. شناسایی این نقاط ضعف، گامی کلیدی در مقاومسازی سیستمهاست، مشابه آنچه در رویکردهای مهندسی آشوب برای شناسایی نقاط شکست در Strands Evals مشاهده میکنیم.
بسیاری از توسعهدهندگان سعی میکنند این مشکل را با نوشتن پرامپتهای پیچیدهتر یا بهینهتر حل کنند، اما این یک خطای ساختاری است. همانطور که در یک راهنمای فنی در سایت dev.to توصیف شده است، تنها راه حل قابلاتکا این است که هر گام پیش از انتقال به اقدام بعدی، مستقیماً با داده مرجع (Ground Truth) — یعنی حقیقت موجود در بکاِند — تطبیق داده شود. شما نمیتوانید این مشکل را با پرامپت حل کنید زیرا این شکست نامرئی است؛ هیچ استثنایی (Exception) برای گرفتن وجود ندارد و هیچ خط قرمز رنگی در لاگها دیده نمیشود؛ تنها یک خلاصه شاد و خوشبینانه وجود دارد که با واقعیت مطابقت ندارد.
برای درک بهتر، یک عامل مسافرتی را تصور کنید که باید یک سفر چندشهری را رزرو کند. اگر در مرحله دوم، پرواز میانی ذخیره نشود اما API پیام موفقیت برگرداند، یک عامل سادهلوح صرفاً به سراغ رزرو پرواز بعدی میرود. نتیجه این است که شما یک برنامه سفر ناقص دارید که هوش مصنوعی با اطمینان کامل ادعا میکند بینقص است. این اتفاق به دلیل ناپایداری بکاِندها، تأخیر در همگامسازی دادهها (Consistency Lags) یا تراکنشهای جزئی (Partial Transactions) رخ میدهد که دقیقاً شبیه به موفقیت واقعی به نظر میرسند. برای اثبات این نقص، یک دمو با استفاده از مخزن resilient-agent-harness-sample-for-aws طراحی شده است، بهویژه در بخش دموی برنامهریزی وظایف چندمرحلهای (03-multi-step-task-planning).
تلهی عامل مسافرتی: بررسی دمو
در این دمو، عاملی با استفاده از Strands Agents طراحی شده تا سفری به دور دنیا شامل سه پرواز مشخص را رزرو کند: از نیویورک (JFK) به پاریس (CDG)، از پاریس (CDG) به توکیو (HND) و از توکیو (HND) بازگشت به نیویورک (JFK). این عامل سه ابزار اصلی در اختیار دارد:
search_flights: یافتن نرخها و قیمتها در محیط شبیهساز Duffel.book_flight: نوشتن/ثبت یک رزرو در بکاِند.list_booked_flights: خواندن آنچه واقعاً در بکاِند ذخیره شده است (داده مرجع).
برای اثبات آسیبپذیری، یک شکست خاموش را عمداً در مسیر توکیو (CDG به HND) تعبیه کردهاند. در این سناریو، اولین تلاش برای رزرو این پرواز عبارت «confirmed» را برمیگرداند، اما دادهها هرگز ذخیره نمیشوند. پیش از آنکه عامل اجرا شود، دفترچه (Notebook) مستقیماً تابع book_flight را برای پرواز توکیو فراخوانی میکند تا نشان دهد در حالی که ابزار میگوید «تأیید شد»، ابزار list_booked_flights نشان میدهد که رزرو مفقود شده است. این کار تأیید میکند که خودِ ابزار منبع فریب است.
مکانیزم اعتبارسنجی دادههای مرجع
برنامهریزی وظایف چندمرحلهای فرآیند تکمیل یک توالی منظم از وظایف است؛ به این صورت که یک گام اجرا میشود، تأیید میشود که واقعاً در بکاِند واقعی ذخیره شده است و تنها پس از آن به گام بعدی حرکت میکند. این رویکرد دقیقاً نقطه مقابل استراتژی «بفرست و فراموش کن» (Fire and Forget) است که در آن یک عامل تمام گامها را تحریک کرده و به گزارش موفقیت هر ابزار اعتماد میکند. این نوع مدیریت خطا برای جلوگیری از اثر دومینویی در سیستمهای پیچیده ضروری است، چیزی که لایههای بازیابی AgentForge برای مقابله با خطاهای زنجیرهای نیز بر اهمیت آن تاکید دارند.
برای حل این چالش، Strands Agents یک الگوی ارکستراسیون بومی مبتنی بر گراف (Graph-based) معرفی کرده است. در این ساختار، بهجای توالی خطی از فراخوانی ابزارها، سیستم از یک حلقه بازخورد (Feedback Loop) متشکل از دو نقش مجزا استفاده میکند:
- مجری (Executor): عاملی که مجهز به ابزارهایی برای انجام اقدام است (مانند
book_flight). - تأییدکننده (Verifier): یک عامل مجزا با مجموعهای محدود از ابزارها که فقط میتواند وضعیت بکاِند را بخواند (مانند
list_booked_flights).

در این معماری، مجری تلاش میکند وظیفه را انجام دهد و نتیجه را به تأییدکننده میسپارد. تأییدکننده به گزارش مجری اعتماد نمیکند، بلکه مستقیماً از بکاِند استعلام میگیرد. اگر تأییدکننده متوجه شود که رکورد مفقود است، یک سیگنال «FAIL» صادر میکند. این سیگنال توسط یک یال شرطی (Conditional Edge) در گراف مدیریت شده و مجری را مجبور میکند همان گام خاص شکستخورده را دوباره تلاش کند. این «حلقه بازخورد» تضمین میکند که وضعیت جهان واقعی، و نه پاسخ ابزار، جریان کار را دیکته کند.
پیادهسازی فنی با GraphBuilder
توسعهدهندگان میتوانند این منطق را بهصورت قطعی (Deterministic) با استفاده از Strands GraphBuilder تعریف کنند. مستندات، یک گراف را به عنوان یک سیستم ارکستراسیون قطعی توصیف میکنند که در آن مجری و تأییدکننده «گره» (Node) هستند و جریان بین آنها «یال» (Edge) نام دارد، که شامل یالهای شرطی و چرخشی (Cyclic) است.
ساختار پیادهسازی به این ترتیب است:
- تعریف گره: مجری به ابزارهای
search_flightsوbook_flightدسترسی دارد، در حالی که تأییدکننده را به شدت به ابزارlist_booked_flightsمحدود کردهاند تا تصمیماتش صرفاً بر اساس داده مرجع باشد. - یالهای شرطی: تابعی به نام
verification_failedبررسی میکند که آیا نتیجه تأییدکننده شامل کلمه «FAIL» هست یا خیر. در صورت مثبت بودن، یال جریان را از «تأیید» به «اجرا» بازمیگرداند. - کنترل چرخه: برای جلوگیری از حلقههای بینهایت، فریمورک از
set_max_node_executions(6)استفاده میکند که سقف تعداد تلاشهای مجدد را محدود میکند. - مدیریت وضعیت: گزینه
reset_on_revisit(True)تضمین میکند که مجری در هر تلاش مجدد، بهجای بارگذاری وضعیتهای قدیمی و منقضی، با وضعیتی پاک شروع کند.
from strands import Agent
from strands.multiagent import GraphBuilder

executor = Agent(name="executor", tools=[search_flights, book_flight])
verifier = Agent(name="verifier", tools=[list_booked_flights])

def verification_failed(state):
    v = state.results.get("verify")
    return bool(v) and "FAIL" in str(v.result).upper()

builder = GraphBuilder()
builder.add_node(executor, "execute")
builder.add_node(verifier, "verify")
builder.add_edge("execute", "verify")
builder.add_edge("verify", "execute", condition=verification_failed)
builder.set_entry_point("execute")
builder.set_max_node_executions(6)
builder.reset_on_revisit(True)
graph = builder.build()
در ردپای (Trace) این اجرا، دو پروازی که در اولین تلاش ذخیره شدند، صرفاً مسیر execute $\rightarrow$ verify را طی کرده و متوقف شدند. اما پرواز توکیو مسیر execute $\rightarrow$ verify $\rightarrow$ execute $\rightarrow$ verify را طی کرد. تأییدکننده خطا (FAIL) را خواند، یال شرطی باعث تحریک تلاش مجدد شد و مجری با موفقیت رزرو را تکرار کرد، که منجر به ذخیره واقعی ۳/۳ پرواز در بکاِند شد.
بهای صحت: هزینه توکنها
در این رویکرد یک توازن (Trade-off) قابل توجه وجود دارد: مصرف توکن. اعتبارسنجی یک بهینهسازی کارایی نیست، بلکه یک سرمایهگذاری روی قابلیت اطمینان است. اکثر پستهای مربوط به «بهینهسازی عاملها» این هزینه را نادیده میگیرند. معیارها از result.accumulated_usage استخراج شدهاند که معیارهای واقعی Strands را بهجای تخمینها ارائه میدهد.
با مقایسه یک عامل سادهلوح در برابر یک گراف اعتبارسنجی شده با استفاده از مدل OpenAI gpt-4o-mini:
- عامل سادهلوح (قبل): از ۳,۱۲۶ توکن استفاده میکند. نتیجه: ۲ از ۳ پرواز ذخیره شد. عامل وظیفه را «کامل شده» اعلام میکند (غلط).
- گراف اعتبارسنجی شده (بعد): از ۱۰,۷۳۲ توکن استفاده میکند. نتیجه: ۳ از ۳ پرواز ذخیره شد. عامل وظیفه را «کامل شده» اعلام میکند (درست).

این افزایش مصرف ناشی از فراخوانیهای API اضافی به بکاِند و چرخههای تکراری حلقه تلاش مجدد است. مجموعها به دلیل غیرقطعی (Non-deterministic) بودن مدل کمی متفاوت است، اما الگو ثابت میماند: رویکرد سادهلوحانه ارزانتر و اشتباه است؛ رویکرد گراف گرانتر و درست است. دستاورد اینجا صحت است، نه صورتحساب کوچکتر. برای مدیریت این پیچیدگیهای عملیاتی، گاهی بازگشت به سادهسازی پشتههای نرمافزاری برای جلوگیری از فروپاشی کدهای AI میتواند راهکار کمکی برای کاهش بار سیستمی باشد.
پیامدهای گستردهتر برای هوش مصنوعی عاملمحور
این الگو از رویکرد MiRA (وانگ و همکاران، مارس ۲۰۲۶) پیروی میکند که برنامهریزی و تأیید را در حین استنتاج (Inference) ادغام میکند، بدون اینکه نیاز به آموزش اضافی باشد. این کار بار قابلیت اطمینان را از تواناییهای استدلالی LLM به ارکستراسیون ساختاری سیستم منتقل میکند.
از آنجا که SDK شرکت Strands مستقل از مدل (Model-agnostic) است، این حلقه اعتبارسنجی میتواند روی تامینکنندگان مختلف اجرا شود:
- Amazon Bedrock (تأمینکننده پیشفرض).
- Anthropic یا OpenAI.
- مدلهای محلی از طریق Ollama.
این دمو بهطور پیشفرض برای سهولت در راهاندازی با یک API Key از gpt-4o-mini استفاده میکند، اما سازوکار فارغ از نوع مدل یکسان است. این متد، عامل را از یک «جعبه سیاه» که امیدوار است موفق شود، به یک سیستم قطعی تبدیل میکند که موفقیت را اثبات میکند.
برای توسعهدهندگان، این به معنای تغییر تمرکز از «چگونه پرامپت بنویسم تا عامل محتاط باشد» به «چگونه تأییدکنندهای بسازم که نتواند فریب بخورد» است. هدف این است که اطمینان حاصل شود وضعیت داخلی عامل همیشه بازتابی از واقعیت جهان بیرونی است.
راهنمای اجرا
برای تست شخصی این ساختار، مخزن را کلون کرده و دفترچه یا اسکریپت را اجرا کنید:
git clone https://github.com/elizabethfuentes12/resilient-agent-harness-sample-for-aws.gitcd resilient-agent-harness-sample-for-aws/03-multi-step-task-planninguv venv && source .venv/bin/activateuv pip install -r requirements.txt
شما به یک OPENAI_API_KEY و یک DUFFEL_API_KEY (که از طریق محیط رایگان app.duffel.com در دسترس است) نیاز دارید. منطق را با دستور uv run test_multi_step_task_planning.py اجرا کنید یا فایل .ipynb را باز کنید تا شکست خاموش و بازیابی بعدی آن را بهصورت لحظهای مشاهده کنید.
گام بعدی شما
- برای تست این ساختار، مخزن گیتهاب
resilient-agent-harness-sample-for-awsرا کلون کرده و دمو شماره ۰۳ را اجرا کنید. - در پروژههای فعلی خود، هر جا که ابزار پاسخی مبنی بر موفقیت میدهد، یک گام «تأیید وضعیت» (Verification Step) با ابزاری مجزا اضافه کنید.
- هزینه توکنها را در مقابل نرخ خطا (Error Rate) بسنجید تا نقطه تعادل بین هزینه و صحت را بیابید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو