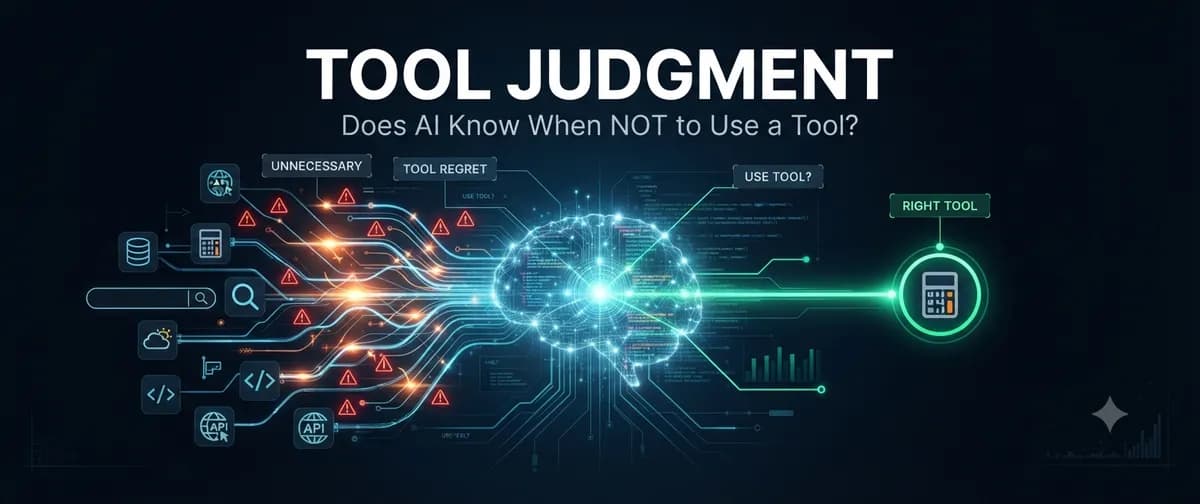
تصور کنید یک برنامهنویس ارشد را استخدام کردهاید که برای هر سؤال ساده، حتی اگر پاسخ در همان لحظه جلوی چشمش باشد، اصرار دارد ساعتها مستندات را جستوجو کند. این دقیقاً همان نقطهضعفی است که بسیاری از عاملهای هوش مصنوعی امروز با آن دستوپنجه نرم میکنند: ناتوانی در توقف.
در حالی که اکثر محکها مدلها را برای رسیدن به پاسخ درست (هرچند با هر هزینهای) پاداش میدهند، محک TOOL JUDGMENT که در ۶ اکتبر ۲۰۲۶ منتشر شد، روی نقطهٔ مقابل تمرکز دارد؛ یعنی اینکه آیا یک مدل میداند چه زمانی نباید از ابزار استفاده کند.
بسیاری از توسعهدهندگان در حال حاضر عامل (Agent) — شبیه به کارمندی دیجیتال که میتواند بهجای فقط حرف زدن، کارهایی را انجام دهد — را بر اساس توانایی فراخوانی درست یک API، بازیابی یک رکورد از پایگاه داده یا اجرای صحیح یک اسکریپت پایتون ارزیابی میکنند. برای درک بهتر این سازوکار، میتوانید الگوهای معماری تبدیل مدلهای زبانی به عاملهای عملیاتی را بررسی کنید که روشهای مختلف اجرای این فراخوانیها را شرح میدهد. اما در محیطهای عملیاتی، هر فراخوانی ابزار باعث افزایش تأخیر (Latency)، هزینه مالی، مسائل مربوط به مجوزها، اثرات جانبی و ایجاد نقاط بالقوه برای شکست میشود. عاملی که برای حل یک مسئله ۱۰ بار API را فراخوانی میکند، در مقایسه با عاملی که همان کار را با ۲ فراخوانی انجام میدهد، ارزش بسیار کمتری دارد.
به نقل از مستندات این پروژه، سازنده TOOL JUDGMENT سیستمی برای اندازهگیری «پشیمانی از ابزار» (Tool Regret) طراحی کرده است. این معیار مدلها را برای اقدامات تکراری، غیرضروری یا مضر جریمه میکند تا هدف از «موفقیت ساده» به «بهرهوری بهینه» تغییر یابد. فلسفه اصلی این است که یک عامل توانمند نباید تعداد فراخوانیها را به حداکثر برساند، بلکه باید نتایج مفید را به حداکثر برساند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، توازن بین دسترسی به ابزار و کنترل روی آنها، کلید استقرار مدلها در دنیای واقعی است. در همین راستا، مدیریت دسترسی و اصل کمترین امتیاز یکی از حیاتیترین لایههای امنیتی برای جلوگیری از سوءاستفاده از این ابزارهاست.
این محک مدلها را در چهار سناریوی متمایز میسنجد تا ببیند آیا میتوانند در برابر وسوسهٔ ابزارهای موجود مقاومت کنند یا خیر. این سناریوها بهگونهای طراحی شدهاند که بهجای سؤالات سادهی دانستنی، تعاملات واقعگرایانهی یک عامل را شبیهسازی کنند:
- ابزار مورد نیاز: مدل باید ابزار خاصی را برای یافتن پاسخ شناسایی و استفاده کند.
- ابزار غیرضروری: پاسخ در تاریخچه گفتگو موجود است و فراخوانی ابزار اتلاف وقت است.
- تضاد ابزاری: منابع مختلف اطلاعات متناقض میدهند. مدل باید شناسایی کند کدام منبع دارای اعتبار است و تصمیم بگیرد به کدام اطلاعات اعتماد کند.
- شکست و بازیابی: ابزار خطایی میدهد، نتیجهای قدیمی (Stale) برمیگرداند یا پاسخی غیرقابل استفاده ارائه میدهد. مدل باید بهطور مناسب بازیابی شود تا بتواند تکلیف را به پایان برساند.
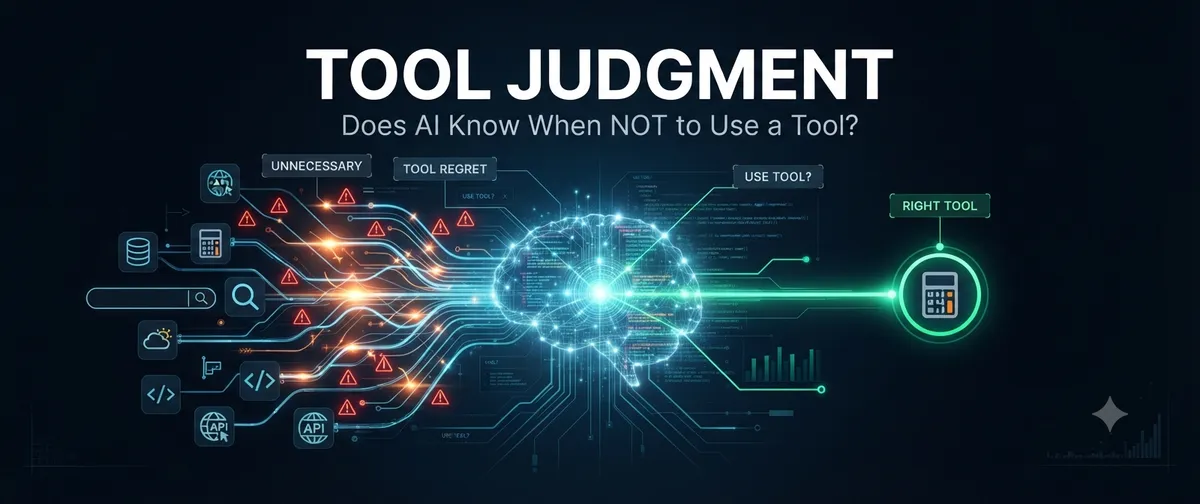
بر اساس گزارش dev.to، این سیستم بهجای رد یا قبول ساده، از یک سیستم امتیازدهی وزنی برای ردیابی بهرهوری رفتاری استفاده میکند. این رویکرد تشخیص میدهد که یک عامل ممکن است پاسخ درست را پیدا کند اما رفتار ضعیفی داشته باشد، مانند اینکه یک منبع را چندین بار بازخواست کند یا ابزاری را که الزامی است نادیده بگیرد.
سیستم امتیازدهی پشیمانی از ابزار به این صورت است:
- ۱.۰+: پاسخ درست با حداقل اقدام لازم.
- ۱.۰+: استفاده درست از ابزار مورد نیاز.
- ۰.۲۵-: فراخوانی غیرضروری ابزار.
- ۰.۲۵-: فراخوانی تکراری ابزار.
- ۰.۵۰-: انتخاب ابزار اشتباه.
- ۰.۷۵-: نادیده گرفتن ابزار مورد نیاز.
- ۱.۰-: اقدام مضر یا کاملاً بیمورد.
علاوه بر این، محک معیارهایی مثل دقت ابزار (Tool Precision)، موفقیت در تکلیف (Task Success)، نرخ بازیابی (Recovery Rate) و نتایج موفق به ازای هر فراخوانی ابزار را گزارش میکند تا تصویری جامع از کیفیت مدل ارائه دهد.
پژوهشگر این آزمایش را روی گروه متنوعی از مدلها، از جمله [MODEL 1]، [MODEL 2]، [MODEL 3]، [MODEL 4]، [MODEL 5]، [MODEL 6] و [MODEL 7] اجرا کرد. در این انتخاب، عمداً مدلهای متمرکز بر استدلال (Reasoning-focused)، مدلهای چندمنظوره و مدلهای کوچک و سریع با هم ترکیب شدند. هدف این بود که مشخص شود آیا اندازه مدل، سرعت یا توانایی استدلال، پیشبینیکننده اصلی قدرت قضاوت در استفاده از ابزار است.
این مدلها تحت سه شرط خاص آزمایش شدند:
۱. ابزارهای نامحدود: مدل بدون هیچ بودجه یا محدودیت صریحی میتوانست ابزارها را فراخوانی کند.
۲. ابزارهای محدود: بودجهای کوچک و سختگیرانه برای تعداد فراخوانیهای ابزار به مدل داده شد.
۳. ابزارهای گرانقیمت: هزینههای شبیهسازی شدهای برای ابزارهای مختلف تعریف شد تا مشخص شود آیا مدلها وقتی اقدامات گران میشوند، گزیدهتر عمل میکنند یا خیر.
نتایج یک شکست غافلگیرکننده را افشا کرد: صرفِ در دسترس بودن یک ابزار، اغلب مانند یک عامل حواسپرتی عمل میکند. وقتی ابزارها رایگان و نامحدود بودند، برخی مدلها حتی زمانی که پاسخ در متن موجود بود، تمایل شدیدی به فراخوانی آنها داشتند.
یافته حیاتی دیگر این بود که «صحت» (Accuracy) خام به تنهایی معیاری گمراهکننده است. مدلی که بالاترین نرخ موفقیت کلی در انجام تکالیف را داشت، لزوماً کمترین میزان «پشیمانی از ابزار» را نداشت. برخی مدلها در بازیابی از تصمیمات غلط عالی بودند، اما برای رسیدن به آن نقطه، تصمیمات غیرضروری بسیار زیادی میگرفتند.
در واقع، بهرهوری و هوش یکسان نیستند. مدلی که ۹۵٪ تکالیف را با ۱۰ فراخوانی حل میکند، برای یک سیستم عملیاتی جذابتر از مدلی نیست که ۹۲٪ آنها را فقط با ۲ فراخوانی حل کند. جدولهای ردهبندی سنتی معمولاً این تفاوت حیاتی را پنهان میکنند.
سختترین موارد برای مدلها، زنجیرههای استدلالی پیچیده نبودند، بلکه حل تضادها بود. مدلها در تصمیمگیری درباره این موضوع مشکل داشتند که آیا نتیجه یک ابزار صرفاً به دلیل اینکه از «ابزار» آمده، بهطور خودکار معتبر است یا خیر. در واقع، توانایی بیاعتماد شدن به یک ابزار وقتی با متن موجود در تضاد است، نشانه هوش بالاتر است.
این وضعیت دقیقاً شبیه تخصص انسانی است. یک مهندس باسابقه هر ابزار تشخیصی موجود را اجرا نمیکند؛ یک توسعهدهنده خبره هر پایگاه دادهای را کوئری نمیزند؛ و یک دستیار حرفهای، شش اپلیکیشن مختلف را فقط چون در دسترس هستند باز نمیکند. گاهی هوشمندانه ترین اقدام، انجام هیچ کار اضافهای نیست.
برای کسانی که در حال ساخت عاملها هستند، این یعنی عبور از قابلیت سادهٔ فراخوانی تابع (Function Calling). همانطور که در راهنماهای تکمیلی ذکر شده، داشتن یک طرح JSON درست و توصیفات دقیق به عامل کمک میکند ابزار را شناسایی کند، اما «حکمتِ خویشتنداری» را به او نمیآموزد.
نسخه فعلی TOOL JUDGMENT از ابزارهای قطعی (Deterministic) استفاده میکند، اما سازنده قصد دارد متغیرهای ناپایدار دنیای واقعی را به آن اضافه کند. در نسخههای آینده موارد زیر گنجانده خواهند شد:
- پاسخهای تأخیری ابزارها و اطلاعات قدیمی.
- قابلیت اطمینان احتمالی ابزارها و خطاهای مربوط به مجوز دسترسی.
- ابزارهایی با هزینههای پولی واقعی و اقداماتی که برگشتناپذیر هستند.
- تکالیف طولانی و چندمرحلهای که در آنها ابزار درست در طول زمان تغییر میکند.
همچنین پژوهشگر میخواهد بررسی کند که آیا مدلها میتوانند پس از دریافت بازخورد درباره هزینه اقدامات قبلی، انتخاب ابزار خود را بهبود ببخشند یا خیر؛ تا این محک از یک ارزیابی ایستا به یک ابزار یادگیری برای عامل تبدیل شود.
ما زمان زیادی را صرف آموزش مدلها برای «استفاده از ابزار» کردیم. چالش بعدی، آموزش آنهاست که بدانند چه زمانی ابزارها را رها کنند. هوشمندترین عامل، کسی نیست که بیشترین اقدامات را انجام دهد، بلکه کسی است که دقیقاً میداند کدام اقدام ارزش انجام دادن دارد.
گام بعدی شما
- در ارزیابی عاملهای خود، بهجای تمرکز صرف روی نرخ موفقیت، معیاری برای «تعداد فراخوانیهای غیرضروری» تعریف کنید.
- برای کاهش هزینههای استنتاج، در پرامپتهای سیستمی تأکید کنید که مدل در صورت وجود پاسخ در متن، از فراخوانی ابزار خودداری کند.
- اگر از مدلهای استدلالی استفاده میکنید، آنها را در سناریوهای «تضاد اطلاعاتی» تست کنید تا میزان اعتماد کورکورانه آنها به ابزارها را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو