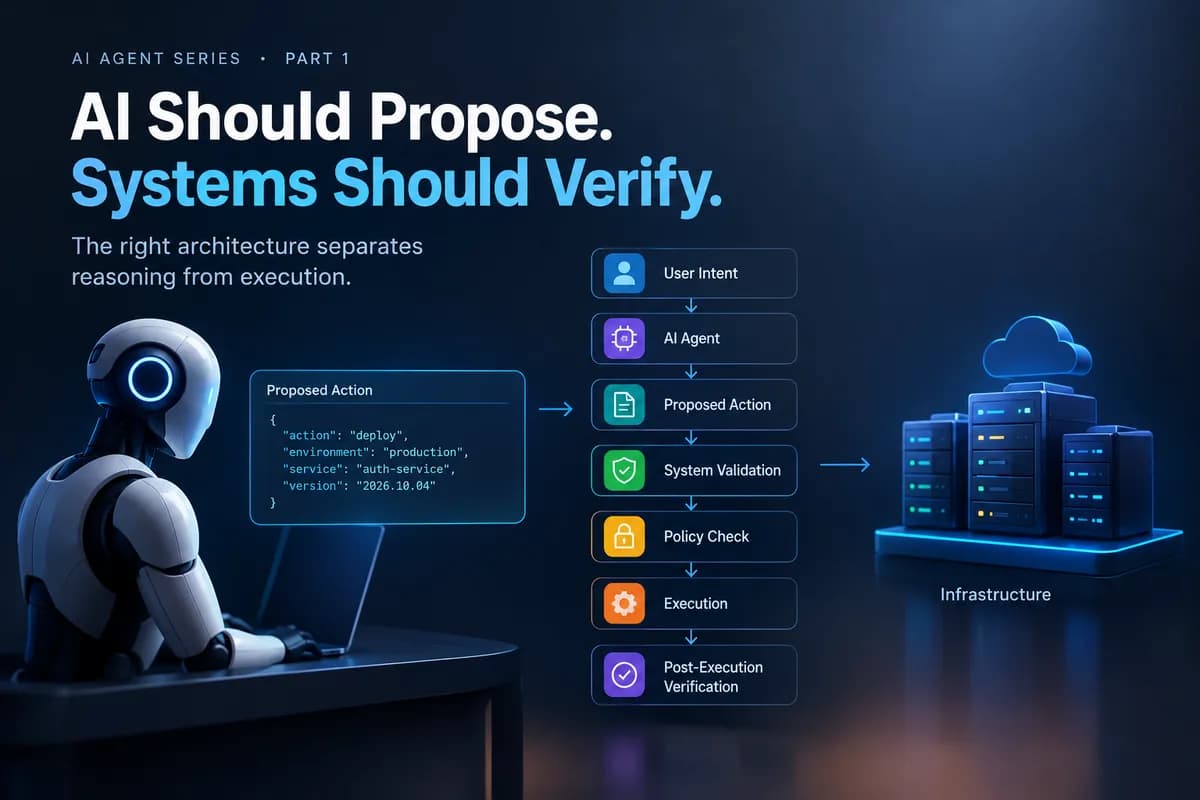
تصور کنید یک برنامهنویس ارشد در تیم شما، راهکار فنی درستی برای رفع یک باگ بحرانی پیدا کرده است، اما اجازه ندارد شخصاً کد را روی سرور اصلی منتشر کند. این شکاف میان «درست بودن راهکار» و «داشتن اجازه برای اجرا»، دقیقاً همان نقطهای است که عاملهای هوش مصنوعی در محیطهای عملیاتی به یک ریسک امنیتی تبدیل میشوند. این تنش میان صحت فنی و اختیار سازمانی، محور اصلی یک پیشنهاد معماری جدید است که در ۷ اکتبر ۲۰۲۶ در وبسایت dev.to منتشر شد و استدلال میکند که هوش مصنوعی باید «پیشنهاد» دهد و سیستمها باید «تأیید» کنند.
طبق این مقاله، مشکل اصلی این است که در جریانهای کاری عاملمحور (Agentic) فعلی، دسترسی به ابزارها بهصورت یک مجوز صفر و یکی (Binary Permission) تعریف شده است. یعنی اگر یک عامل — شبیه به کارمندی که کلید تمام اتاقهای شرکت را دارد — به API استقرار کد دسترسی داشته باشد، عملاً اختیار تغییر کدهای محیط عملیاتی را دارد. در این حالت، یک مرز اعتماد بسیار گسترده ایجاد میشود که در آن یک مدل احتمالی واحد، همزمان تصمیم میگیرد چه کاری انجام شود، بررسی میکند که آیا اجازه دارد آن را انجام دهد و سپس دستور اجرا را صادر میکند؛ ترکیبی که از نظر امنیتی فاجعهبار است.
همانطور که در تحلیلهای قبلی ما دربارهی حفاظهای امنیتی مدلهای زبانی اشاره کردیم، تکیه بر استدلال داخلی مدل برای کنترل دسترسی، هرگز تضمینکننده امنیت نیست.
زمینه اجرای مستقیم
برای درک بهتر، یک عامل کدنویس هوش مصنوعی را در نظر بگیرید که درون یک محیط عملیاتی فعالیت میکند. این عامل وظیفهای دریافت میکند تا یک باگ در سیستم احراز هویت را رفع کرده و تغییرات را مستقر کند. عامل ابتدا مخزن کد (Repository) را تحلیل میکند، کد را اصلاح مینماید، تستها را اجرا میکند و در نهایت یک دستور استقرار (Deployment Command) تولید میکند.
نکته کلیدی اینجاست: حتی اگر کد کاملاً درست باشد، تمام تستها با موفقیت پاس شوند و دستور استقرار از نظر فنی معتبر باشد، هیچیک از این واقعیتها بهطور خودکار به این معنا نیست که عامل باید اجازه داشته باشد کد را روی محیط Production منتشر کند. این سناریو دقیقاً شکاف عمیق میان «صحت فنی» و «اختیار سازمانی» را برجسته میکند که در تحلیلهای پیشین ما دربارهی تفاوت صحت پیادهسازی و صحت سیستمی در عاملهای کدنویس به تفصیل بررسی شده است.
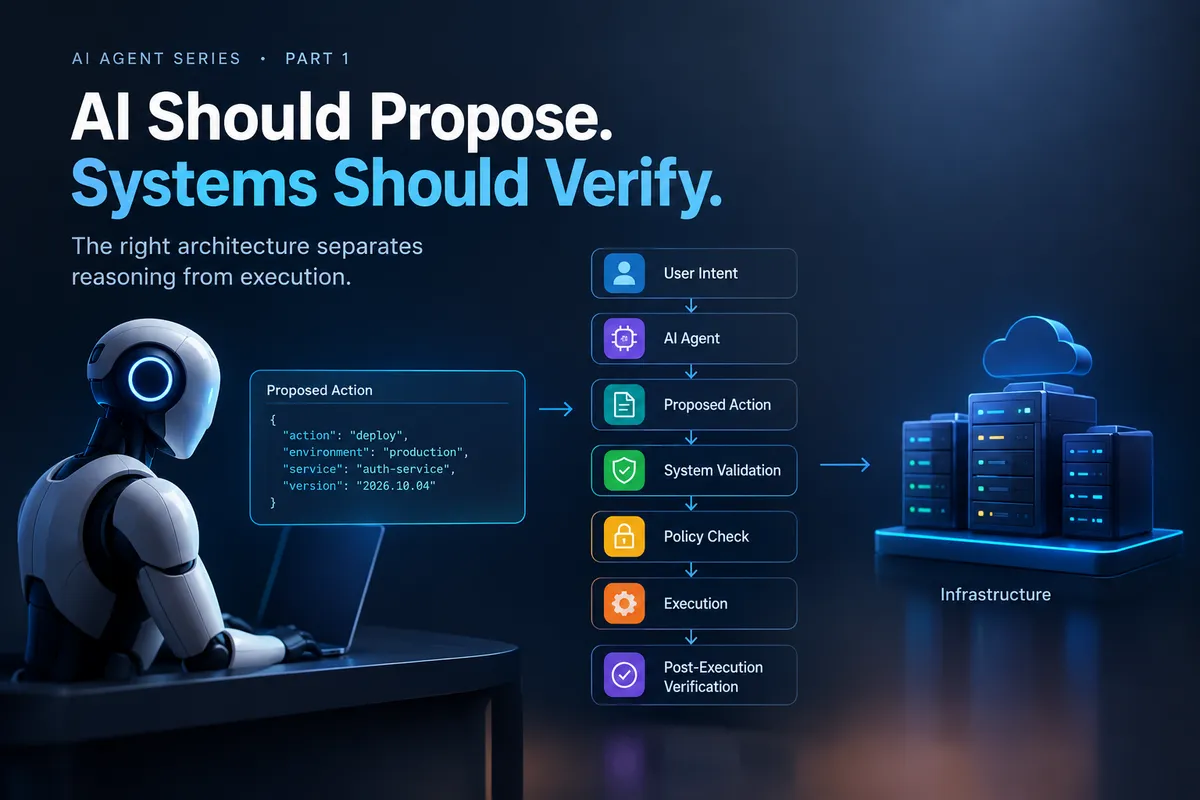
برای حل این چالش، معماری پیشنهادی یک مرز سختگیرانه میان استدلال (Reasoning) و اجرا (Execution) ایجاد میکند. در این مدل، بهجای فراخوانی مستقیم ابزارها، جریان کار از یک زنجیره خطی و منظم پیروی میکند: قصد کاربر $\rightarrow$ عامل هوش مصنوعی $\rightarrow$ پیشنهاد اقدام $\rightarrow$ اعتبارسنجی سیستمی $\rightarrow$ بررسی سیاستها $\rightarrow$ اجرا $\rightarrow$ تأیید پس از اجرا.
مکانیسمهای تأیید
بر اساس مستندات این چارچوب، عامل هوش مصنوعی بهجای ارسال یک دستور مستقیم، یک درخواست ساختاریافته تولید میکند. برای مثال، عامل ممکن است یک شیء JSON خروجی دهد که در آن استقرار سرویس 'auth-service' در محیط 'production' با یک شماره نسخه خاص، مانند "2026.10.04"، مشخص شده باشد.
سپس سیستم محیطی (Surrounding System)، این پیشنهاد را بهطور مستقل و جداگانه بر اساس چندین معیار ارزیابی میکند:
- صحت ساختاری (Structural Validity): آیا فرمت درخواست JSON درست است و تمام فیلدهای لازم را دارد؟
- وجود منابع (Resource Existence): آیا سرویس هدف (مثلاً auth-service) واقعاً در زیرساخت وجود دارد؟
- مجوز (Permission): آیا فاعلی که این درخواست را ارسال کرده، برای این عملیات خاص اختیار دارد؟
- کنترلهای تکمیلی (Additional Controls): آیا برای تغییرات با تأثیر بالا (High-impact)، تأییدیههای ثانویه یا احراز هویت چندعاملی (MFA) مورد نیاز است؟
این رویکرد تفکیک پیشنهاد از اجرا، شباهت زیادی به سازوکار NAEOS در سنجش لحظهای اقدامات عاملها دارد که بر جداسازی لایهی پیشنهاد از احراز هویت مهندسی تأکید میکند.
اعتبارسنجی در مقابل مجوز
باید توجه داشت که پاس کردن یک مجموعه تست (Test Suite) هرگز به معنای داشتن مجوز برای استقرار نیست. یک عامل کدنویس ممکن است یک سرویس پرداخت را تغییر دهد، تمام چکهای امنیتی را پاس کند و آرتیفکت نهایی را امضا نماید. در حالی که این نتایج ثابت میکند نرمافزار از نظر فنی قابل قبول است (اعتبارسنجی یا Validation)، اما ثابت نمیکند که عامل اجازه دارد آن را به محیط عملیاتی بفرستد (مجوز یا Authorization).
این تفکیک، یک جداسازی ضروری از دغدغهها (Separation of Concerns) ایجاد میکند:
- اعتبارسنجی (Validation): آیا این اقدام به عنوان یک عملیات فنی قابل قبول است؟
- مجوز (Authorization): آیا این فاعل اجازه انجام این کار را دارد؟
- اجرا (Execution): انجام عملیات تأیید شده.
این جداسازی باعث میشود معماری سیستم بهراحتی قابل حسابرسی (Audit) باشد و بتوان سیاستها را بدون نیاز به تغییر در فرآیند استدلال داخلی مدل، تغییر داد.
تعادل میان قابلیت و اختیار
جداسازی استدلال از اجرا به این معنا نیست که باید عامل را ضعیف کرد. یک عامل مهندسی همچنان میتواند قابلیتهای گستردهای را حفظ کند، از جمله:
- بررسی و تحلیل مخازن کد
- ایجاد شاخههای (Branches) جدید
- اصلاح فایلها
- اجرای تستها
- بررسی لاگها
- تولید برنامههای استقرار
- پیشنهاد تغییرات در زیرساخت
با این حال، سیستم کنترلهای بسیار سختگیرانهتری را برای عملیاتهای حساس اعمال میکند. این موارد شامل استقرار در محیط Production، چرخش کلیدهای امنیتی (Credential Rotation)، مهاجرتهای پایگاهداده (Database Migrations)، تغییرات تخریبی در زیرساخت و تراکنشهای مالی است. عامل همچنان قادر است درباره این عملیاتهای پیچیده استدلال کند، اما قابلیتهای استدلالی او بهطور خودکار به «اختیار نامحدود» تبدیل نمیشود.
فراتر از کنترلهای مبتنی بر ابزار
تعریف کنترلها صرفاً بر اساس «دسترسی به ابزار» اغلب بیش از حد کلی و خام است. برای مثال، یک عامل ممکن است به ابزارهایی مانند deploy_tool یا payment_api یا database_api دسترسی داشته باشد.
یک API استقرار واحد ممکن است هم محیط Staging و هم Production را مدیریت کند؛ در این حالت، دادن دسترسی به خودِ ابزار مشخص نمیکند که کدام محیط برای اجرا ایمن است. واحد واقعی کنترل، «اقدام و بستر زمینه آن» (Action and Context) است، نه صرفاً وجود یک ابزار. سیستم باید بهجای نگاه ساده، درباره بستر زمینه خاص استدلال کند: فاعل $\rightarrow$ اقدام $\rightarrow$ منبع $\rightarrow$ محیط $\rightarrow$ محدوده $\rightarrow$ زمینه $\rightarrow$ سیاست.
تفویض اختیار در عاملها
این مرز زمانی حیاتیتر میشود که عاملها شروع به تفویض کار به یکدیگر کنند. زنجیرهای را تصور کنید که در آن یک کاربر، یک «عامل ارکستراتور» (Orchestrator Agent) را فعال میکند و این عامل به نوبه خود یک «عامل تدارکات» (Procurement Agent) را برای دسترسی به سرویس پرداخت فراخوانی میکند.
عامل تدارکات ممکن است تشخیص دهد که یک خرید ضروری است، اما درخواست ارکستراتور به معنای اعطای اختیار هزینه نامحدود به عامل تدارکات نیست. در اینجا سیستم باید زنجیره عمیقتری را ردیابی کند: آغازکننده $\rightarrow$ تفویضکننده $\rightarrow$ عامل اجراکننده $\rightarrow$ اقدام $\rightarrow$ منبع $\rightarrow$ محدوده.
این وضعیت یک مسئله پیچیده در حوزه مجوزدهی ایجاد میکند که نیازمند یک لایه اختصاصی برای مدیریت تفویض اختیار است، بهجای آنکه سعی شود این منطق در مدل سادهی اجرا گنجانده شود.
با تبدیل هوش مصنوعی به یک «جزء» از سیستم بهجای «خودِ سیستم»، پایداری معماری حفظ میشود، حتی اگر مدل زیربنایی ارتقا یابد یا جایگزین شود. ماهیت احتمالی هوش مصنوعی در یک مرز کنترل قطعی (Deterministic) محصور میگردد: کاربر $\rightarrow$ قصد $\rightarrow$ عامل هوش مصنوعی $\rightarrow$ پیشنهاد اقدام $\rightarrow$ کنترلهای سیستمی $\rightarrow$ زیرساخت.
گام بعدی شما
برای کسانی که در حال ساخت جریانهای کاری عاملمحور هستند، گام بعدی بازبینی مجوزهای فعلی استفاده از ابزارها (Tool-use) است تا نقاطی که «صحت فنی» با «اختیار اجرایی» اشتباه گرفته شده را شناسایی کنند. هدف این نیست که از اقدام هوش مصنوعی جلوگیری شود، بلکه هدف این است که اطمینان حاصل شود هوش مصنوعی پیشنهاد میدهد، سیستمها تأیید میکنند و زیرساخت اجرا میکند.
- مجوزهای فعلی ابزارهای عاملهای خود را بازبینی کنید تا نقاطی که «صحت فنی» با «اختیار اجرایی» اشتباه گرفته شده را بیابید.
- لایهای برای تبدیل دستورات مستقیم مدل به درخواستهای ساختاریافته (JSON) ایجاد کنید.
- سیاستهای دسترسی را از منطق مدل جدا کرده و در یک لایه کدنویسی شده (Hard-coded) یا دیتابیس سیاستها پیاده کنید.
اما چالش بزرگتر، مدیریت این مجوزها در مقیاس هزاران عامل است — در تحلیل ما درباره پروتکلهای جدید مدیریت هویت برای AI بخوانید.



گفتگو