تصور کنید تمام تلاشهای سالهای اخیر برای درک «جعبه سیاه» هوش مصنوعی، در واقع تعقیب یک شبح بوده باشد. کاماراتا (Cammarata)، پژوهشگر برجسته و مدیر سابق OpenAI، استدلال میکند که کلنجار رفتن جامعه علمی با پدیده «چندمعنایی» (Polysemanticity) — یعنی حالتی که در آن یک نورون به مفاهیم نامرتبط پاسخ میدهد — نه یک ویژگی بنیادین شبکههای عصبی، بلکه نتیجه شکست ابزارهای تحلیلی ما بوده است.
تفسیرپذیری مکانیکی (Mechanistic Interpretability) به دنبال چیزی فراتر از مشاهده خروجیهای مدل است؛ هدف این حوزه ردیابی دقیق مسیر رسیدن مدل به پاسخ در لایههای داخلی است. در حالت ایدهآل، هر یک از میلیونها نورون مصنوعی باید نماینده یک مفهوم قابلشناسایی باشد. اما در عمل، بسیاری از نورونها به موارد کاملاً نامرتبط واکنش نشان میدادند که پژوهشگران آن را چندمعنایی نامیدند.
برای سالها، اجماع علمی بر این بود که مدلها از «برهمنهی» (Superposition) استفاده میکنند تا مفاهیم بیشتری را نسبت به تعداد نورونهایشان ذخیره کنند. طبق این نظریه، وقتی شبکه با کمبود نورون مواجه میشود، مفاهیم نامرتبط را در یک نورون میگنجاند چون احتمال تداخل آنها کم است. برای حل این گره، بسیاری از آزمایشگاهها مدل دومی مانند خودرمزگذار پراکنده (Sparse Autoencoder) را آموزش میدهند تا مفاهیم را از هم تفکیک کنند.
همانطور که در تحلیل قبلی ما دربارهی تأثیر مشارکتهای فردی بر مربیهای هوش مصنوعی اشاره کردیم، این تز جدید میگوید آنچه «هرجومرج» به نظر میرسید، در واقع یک تعمیم ساختاریافته است که انسانها ابزار دیدنش را نداشتند. کاماراتا که پیشتر با همکاری کریس اولاه (Chris Olah) در مقاله «Zoom In» اولین مدار برهمنهی را معرفی کرده بود، اکنون معتقد است شواهد آن مقاله بهاشتباه تفسیر شدهاند.
افسانه نورون «گربه-ماشین»
یکی از پرارجاعترین مثالهای برهمنهی، نورونی در مدل InceptionV1 بود که هم به چهره گربهها و هم به جلوی ماشینها واکنش نشان میداد. سالها این مورد به عنوان اثباتی بر چندمعنایی نورونها تلقی شد.
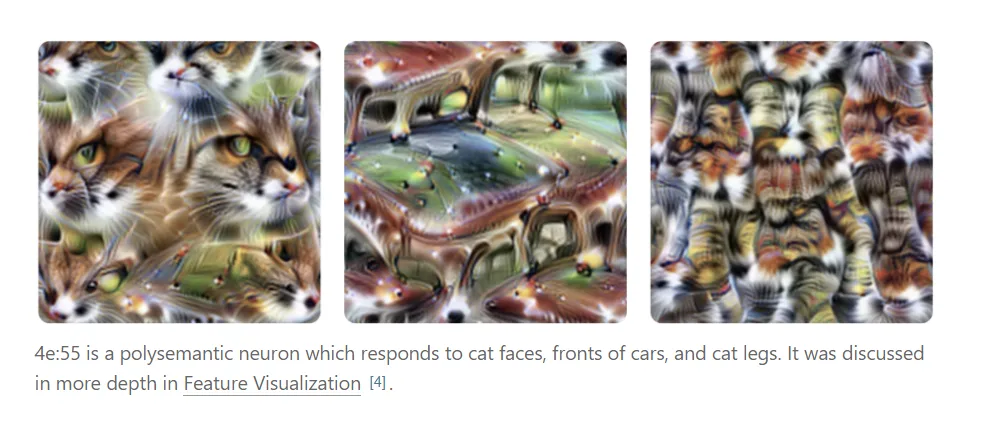
سه بصریسازی سنتتیک از همین نورون در InceptionV1، چهره گربه، جلوی ماشین و پاهای گربه را نشان میدهد. در حالی که مقاله «Zoom In» این ترکیب را نمونهای از چندمعنایی میدانست، کاماراتا اکنون تأکید میکند که این نورون نماینده دو شیء نامرتبط نیست، بلکه یک «آشکارساز شکل V» است.
اشکال نوکتیز، مانند پوزه روباه یا شعله آتش، این نورون را فعال میکنند، در حالی که اشکال گرد مانند حرف O، فعالسازی را به سمت منفی میبرند.
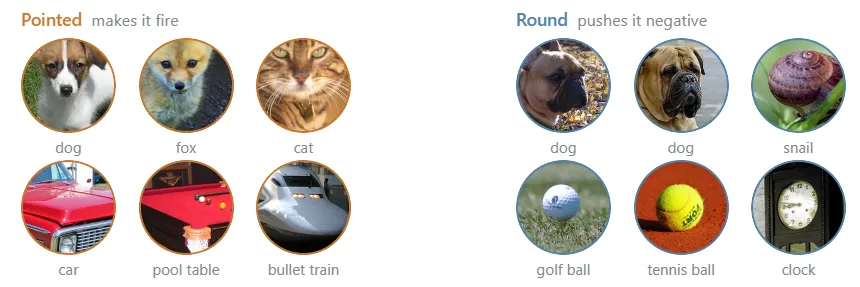
کاماراتا با ارزیابی مجدد دادهها استدلال میکند که پدیده «گربه-ماشین» صرفاً یک ویژگی هندسی مشترک است. او همین منطق را در مورد مقاله خود و کریس اولاه به کار میبرد و میگوید آنچه شبیه ماشین در میان نورونهای سگ بود، در واقع یک تعمیم عادی است؛ مدار صرفاً ماشینها و سگها را بر اساس جهت قرارگیریشان نسبت به دوربین گروهبندی کرده است.
ابزارهای تحلیل و معماری
به نقل از کاماراتا، آشفتگی مشاهدهشده در لایههای انتهایی InceptionV1 ناشی از معماری قدیمی و ابزارهای تحلیلی ضعیف است. او معتقد است متدهای مدرن تحلیل، الگوهای پاسخ و عکسهای مرتبط را بسیار سادهتر قابلرؤیت میکنند.
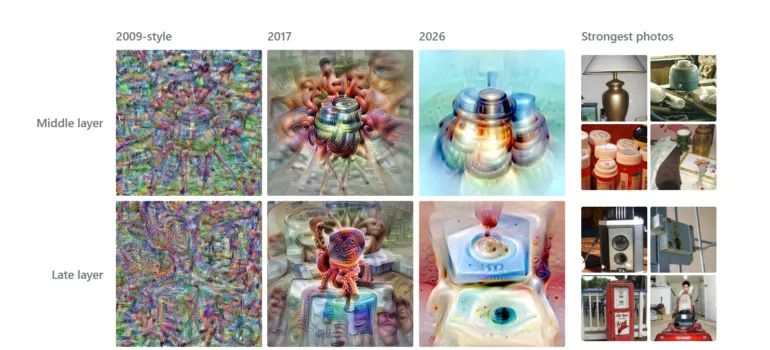
او این موضوع را دلیل اصلی برای بازنگری در یافتههای قدیمی درباره دشواری درک شبکههای عصبی میداند. در سال ۲۰۲۳، زمانی که او پروژه تفسیرپذیری خودکار را در OpenAI آغاز کرد، تنها حدود ۱.۷ درصد از نورونها حتی با سخاوتمندانهترین معیارها، «قابلفهم» تشخیص داده شدند. ابزارهای مدرن نشان میدهند که این عدد بهشدت دستکم گرفته شده بود.
تعمیم بازگشتی و مقیاس
کاماراتا برای توضیح ابهامات باقیمانده، مفهوم «تعمیم بازگشتی» (Recursive Generalization) را معرفی میکند. او این فرآیند را شبیه به رشد یک شاخه توصیف میکند که ابتدا یک جوانه میزند و با یادگیری مدل، شاخههای جانبی میدهد و هدفش تکامل مییابد.
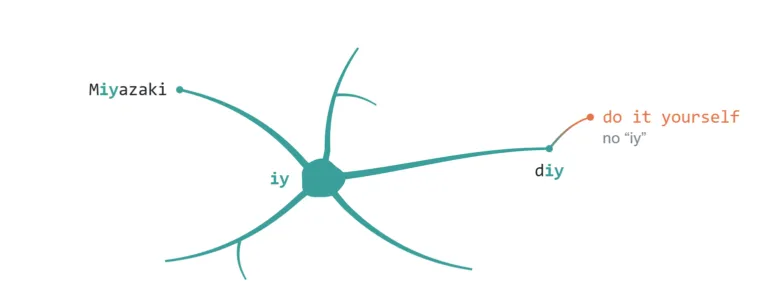
برای مثال، نورونی که ابتدا توالی حروف «iy» را میشناسد، ممکن است به «diy» گسترش یابد و در نهایت به عبارت کامل «do it yourself» پاسخ دهد، حتی اگر توالی اولیه «iy» دیگر وجود نداشته باشد. برخلاف برهمنهی، این گروهبندیها میتوانند منطق داخلی شبکه را به پژوهشگران آموزش دهند.
محکهای جدید برای مدلهای زبانی بزرگ
کاماراتا و شرکت Goodfire با استفاده از عاملهای هوش مصنوعی برای تحلیل انبوه نورونها، اعداد اولیهای برای مدلهای زبانی بزرگ ارائه کردهاند. در مدل Qwen3-32B، آنها دریافتند:
- تقریباً ۹۰٪ از قطبهای نورونی یک وظیفه اصلی و متمایز دارند.
- حدود ۷٪ دو وظیفه بههممرتبط دارند.
- تنها ۲٪ تا ۴٪ بدون توضیح باقی ماندهاند.
شرکت Goodfire نتایج مشابهی را در مدلهایی با تریلیونها پارامتر گزارش کرده است. این یافتهها نشان میدهد «درس تلخ» (Bitter Lesson) — مفهومی از ریچ ساتون که میگوید بررسیهای ساده در مقیاس عظیم بر متدهای تجزیه پیچیده غلبه میکند — در حوزه تفسیرپذیری نیز صادق است. کاماراتا متد بنیادین جدیدی معرفی نکرده، بلکه با ابزارهای بهتر و عاملهای خودکار، به همان رویکرد اولیه مطالعه مستقیم نورونها بازگشته است.
مخاطرات ایمنی
اگر این یافتهها تأیید شوند، پیامدهای ایمنی هوش مصنوعی عظیم خواهد بود. در حال حاضر، پژوهشگران به نظارت بر زنجیره تفکر (Chain-of-Thought) متکی هستند که بهطور فزایندهای غیرقابلاعتماد شده است. اگر انسانها بتوانند مدارات شبکه را مستقیماً بخوانند، میتوانند فریب را در لحظه تشخیص دهند.
کاماراتا استدلال میکند که همراستاسازی (Alignment) — یعنی هدایت AI به سمت اهداف انسانی — بدون این سطح از تفسیرپذیری غیرممکن است، زیرا در غیر این صورت نمیدانیم دقیقاً چه میسازیم. او مینویسد فریب هیچ دلیلی ندارد که در مدارات داخلی مدل پنهان شود. اگر انسانها به یک «خواننده» دیگر برای شبکه تبدیل شوند، میتوانند فریب را ببینند و خطاها را بهصورت هدفمند اصلاح کنند.
رون (Roon)، کارمند تأثیرگذار OpenAI، معتقد است این دستاورد ممکن است به عنوان یک لحظه کلیدی در تاریخ علم ثبت شود. او میگوید این خبر چنان مثبت است که حتی الیزر یودکوفسکی، هشداردهنده معروف درباره فاجعه AI، احتمالاً باید تخمینهای خود از احتمال نابودی را کاهش دهد و همراستاسازی را به یک «علم نرمال» تبدیل کند. این رویکرد به نوعی با دیدگاههای جدید دیپمایند درباره هوش مصنوعی همزیست همسو است که به جای تکینگی، بر تعامل سازنده میان انسان و ماشین تأکید دارد.
میدانی دوقطبی
البته همه متقاعد نشدهاند. نیل ناندا (Neel Nanda)، از چهرههای مؤسس تفسیرپذیری مکانیکی و مدیر در Google DeepMind، همچنان تردید دارد. ناندا از اواسط سال ۲۰۲۴ نسبت به تفسیرپذیری بلندپروازانه بدبینتر شده و به رویکردهای پراگماتیک روی آورده است.
در حالی که او استفاده از ابزارهای مدرن کاماراتا را تحسین میکند، معتقد است برهمنهی همچنان واقعی است. استدلالهای ناندا عبارتند از:
- مدلهای زبانی حقایق بسیار بیشتری نسبت به تعداد نورونهایشان ذخیره میکنند.
- احتمالاً بخش زیادی از این اطلاعات در فعالسازیهای ضعیف نهفته است.
- یافتههای مدلهای تصویری کوچک مانند InceptionV1 لزوماً به مدلهای زبانی پیشرو تعمیم نمییابند.
ناندا همچنین معتقد است تعریف «تکمعنایی» در این مقاله بیش از حد سهلگیرانه است. این اختلاف نظر بر سر تعاریف است. در حالی که هر دو میپذیرند مدلها مفاهیم بیشتری را نسبت به ابعادشان نمایش میدهند، کاماراتا این ایده را که آنها مفاهیم نامرتبط را بهطور تصادفی در هم میبافند، رد میکند.
مقاله فنی این ادعاها هنوز منتشر نشده است. شرکت Goodfire به عنوان یک شرکت تفسیرپذیری، نفع مستقیمی در این تز دارد؛ زیرا اگر درست باشد، پژوهشگران خودکار میتوانند در چند ماه کاری را انجام دهند که برای انسانها در مدلهای تصویری نزدیک به یک دهه زمان برد. کاماراتا هشدار میدهد که شاید زمان زیادی برای این کار باقی نمانده باشد.
گام بعدی شما
- دنبال کردن انتشار مقاله فنی Goodfire برای بررسی متدولوژی تحلیل خودکار نورونها.
- بازنگری در استراتژیهای ایمنی AI با جایگزینی نظارت بر خروجی (Output Monitoring) با نظارت بر مدارات داخلی.
- مطالعه مفهوم «درس تلخ» برای درک اینکه چرا مقیاسدهی ابزارهای ساده بر پیچیدگیهای تئوریک غلبه میکند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو