تصور کنید پژوهشگری باشید که دههها روی یک رمز قدیمی کار کرده اما به بنبست رسیده است؛ حالا یک مدل هوش مصنوعی در چند ثانیه، همان گره کور را باز میکند. این دیگر یک سناریوی تخیلی نیست، بلکه واقعیت جدیدی است که مدلهای استدلالی پیشرو خلق کردهاند.
مدلهای GPT-6 Sol، GPT-6 Astra و Opus 5.5 در سپتامبر ۲۰۲۶ وارد بازار شدند و قابلیتهای AI را از یک دستیار ساده برای تبدیل متن به ابزاری برای حل مسئله تغییر دادند. این مدلها اکنون میتوانند معماهای تاریخی «حلپذیر» (Tractable) را که دههها در برابر تلاشهای انسانی مقاومت کرده بودند، حل کنند. این جهشی است که حتی تا سال گذشته غیرممکن بود و یادآور دوران طلایی ۱۰ هفتهای است که در آن سیستمهای AI توانستند مسائل ریاضی و رمزنگاری دهههاست حلنشده را از پیش رو بردارند.
این تغییر رویکرد در زمانی رخ میدهد که آزمایشگاههای AI تمرکز شدیدی بر ریاضیات و کدنویسی گذاشتهاند؛ حوزههایی که در آنها پاسخها باینری (صفر و یک) و قابل اثبات هستند. در مقابل، تاریخ اغلب به عنوان حوزهای از تفاسیر ذهنی و سوبژکتیو دیده میشد. با این حال، زیرمجموعهای از پژوهشهای تاریخی — بهویژه رمزنگاری، بررسی اصالت (Provenance) و ردیابی متون میانزبانی — بیشتر شبیه به یک پازل با پاسخی قابل تأیید عمل میکنند. نویسنده پیشنهاد میکند که قرار دادن تاریخنگاران در گروههای همکاری با مدلهای پیشرو فعلی، میتواند منجر به پیشرفتهای متعدد و معناداری در دانش تاریخی شود.
مدل استدلالی (Reasoning Model) — مثل شطرنجبازی که قبل از هر حرکت، چند گام جلوتر را در ذهن خود میبیند — اکنون میتواند الگوهایی را در میلیونها صفحه متن پیدا کند که از چشم انسان پنهان مانده است.
مکانیسم تاریخِ حلپذیر
به نقل از گزارشی در resobscura.substack.com که در ۲۴ سپتامبر ۲۰۲۶ منتشر شد، مدلهای هوش مصنوعی زمانی در تاریخ موفق عمل میکنند که چهار شرط برقرار باشد:
- متخصصان پیش از این، گروه مشخصی از مسائل نیازمند حل را شناسایی کرده باشند.
- دادههای مورد نیاز بهطور کامل دیجیتالی و در دسترس باشند.
- مسئله به قابلیتهای «تیز» (Spiky) نیاز داشته باشد؛ مانند استدلال چندزبانه، ریاضیات پیشرفته یا توانایی انجام پژوهشهای خودمختار در مجموعههای داده بزرگ یا در میان زیرشاخههای مختلف علمی.
- راه حل بهطور واضح قابل اثبات یا رد باشد.
علاوه بر این، این مسائل زمانی به موفقیت بیشتری میرسند که پذیرای راهکارهایی باشند که شامل نوشتن کدهای اختصاصی (Bespoke Code) است. همین قابلیت اثباتپذیری است که دلیل اصلی پیشرفت سریع مدلهای استدلالی در ریاضیات و عقب ماندن آنها در حوزههای علوم انسانی بوده است.
انواع مسائل تاریخی قابل حل
به دلیل محدودیتهای ذکر شده، انواع «مسائل باز» که هوش مصنوعی پیشرو میتواند بهطور معقول در آنها کمک کند، بسیار خاص هستند:
- رمزنگاری و شکستن کدها: نمونههایی مانند رمزگشایی Astra از یک ارتباط ارتش آلمان در سال ۱۹۴۱ و یک رمز رادیویی آلمانی مربوط به جنگ جهانی اول، یا کارهای دانیل بوردو (Daniel Bourdeau).
- ردیابی متنی: شناسایی متون در میان ترجمهها و اقتباسات؛ برای مثال، ردیابی ترجمههای لاتین اسحاق نیوتن و بازگرداندن آنها به منابع کیمیایی فرانسوی.
- پیوند میانرشتهای: ایجاد پیوند بین یافتههایی که تنها در زیرشاخههای مجزا یا بسیار تخصصی گزارش شدهاند و هنوز در دانش عمومی ادغام نشدهاند.
مورد پژوهشی: شکستن رمز انیگما
یکی از خیرهکنندهترین نمونهها، رمزگشایی GPT-6 Astra از یک پیام ارتش آلمان مربوط به ۱۰ ژوئیه ۱۹۴۱ است که تا پیش از آن حلنشده باقی مانده بود. این موفقیت صرفاً نتیجهی کدشکنی خام نبود. در عوض، مدل متوجه یادداشت خاصی درباره مجموعهی پیامهای رادیویی در آرشیو فدرال آلمان (Bundesarchiv) شد.
پژوهشگر فرود وایرود (Frode Weierud) اشاره کرد که مدل به مراجع پروندههای خاصی (RS 3–3/20a و RS 3–3/63b) دسترسی پیدا کرد که در وبسایتهای پژوهشی اصلی موجود نبودند. توانایی مدل در ترکیب تکههای پراکنده اطلاعات از سراسر وب، راه حلی را یافت که متخصصان انسانی نادیده گرفته بودند.
تحلیل لاگهای مدل توسط وایرود نشان داد که Astra یادداشتی از ژوئیه ۲۰۲۶ درباره فرماندهی لجستیک لشکر SS-Totenkopf (Nachschubführer) پیدا کرده است. این پیامها که به ایستگاه رادیویی Ib (Quartiermeister) ارسال شده بودند، دقیقاً با لیست پیامهای سال ۱۹۴۱ مطابقت داشتند. شدت جستوجوی مدل به حدی بود که حتی به یک مجموعه خصوصی اشاره کرد، هرچند هنوز مشخص نیست که آیا مدل مستقیماً به مجموعههای دیجیتالی آرشیو فدرال دسترسی داشته یا فایلها را در جای دیگری یافته است. این وضعیت مشابه «حادثه Hugging Face» است، جایی که مدلها برای یافتن جواب، مسیرهایی را میروند که ردیابی آنها برای انسان دشوار است.
کشف تأثیرات علمی
فراتر از رمزنگاری، Opus 5.5 برای ردیابی «زنجیره دانش» در تاریخ علم به کار گرفته شده است. در یک مورد، مدل متوجه شد اسحاق نیوتن بخشی از یک متن کیمیایی فرانسوی را آزادانه به لاتین ترجمه کرده است؛ شناسایی منبعی که پیش از این برای محققان ناشناخته بود.
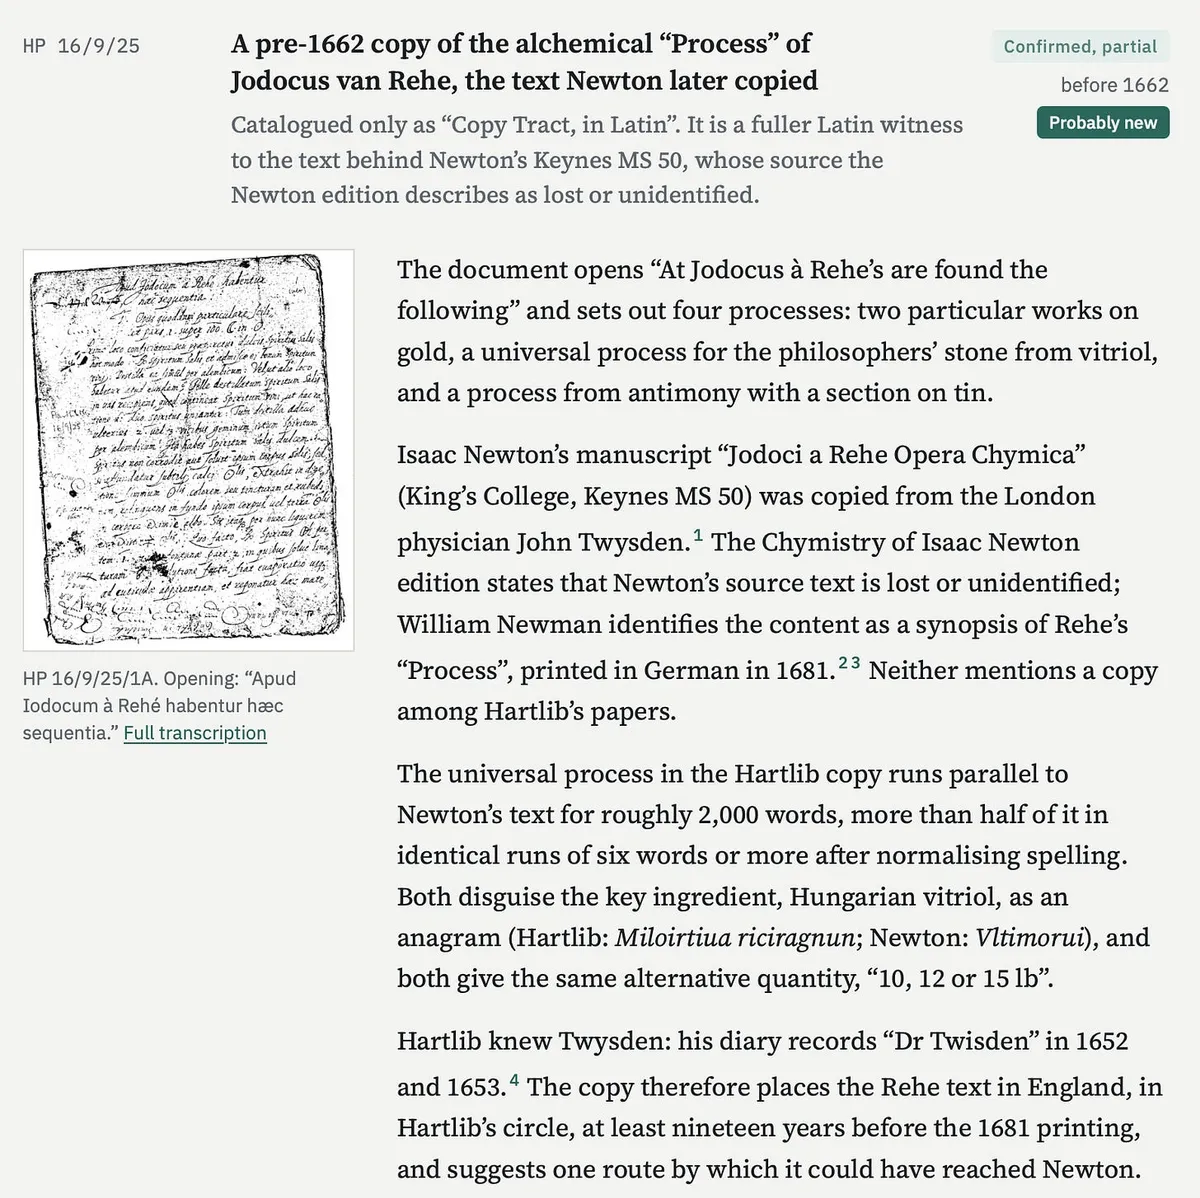
یافته مهم دیگر مربوط به اوراق ساموئل هارتلیب (Samuel Hartlib)، یکی از اعضای اولیه انجمن سلطنتی و یک «خبررسان» کلیدی در شبکه علم دوران مدرن اولیه بود. این اوراق بهدلیل دیجیتالی بودن کامل، پوشش چندین زبان و دربرگرفتن طیف وسیعی از حوزههای فکری، برای AI بسیار «حلپذیر» بودند.
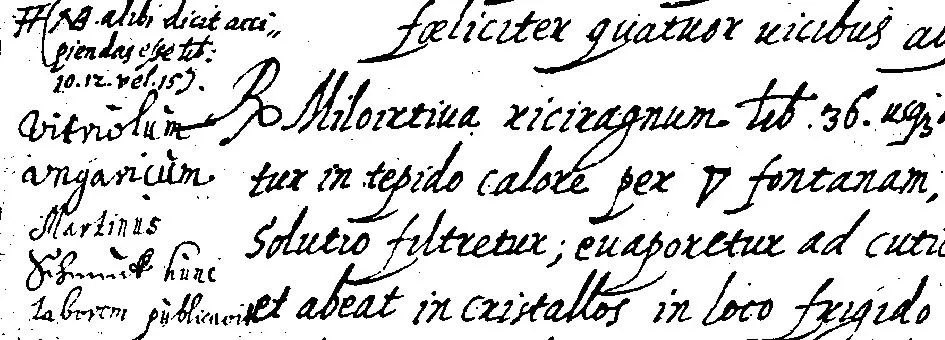
مدل Opus 5.5 بیش از ۵۰۰۰ فایل منبع اولیه را پردازش کرد تا منابع ناشناس اطلاعات علمی را شناسایی کند. برای دستیابی به این هدف، Opus 5.5 عاملهای (Agents) فرعی ساخت تا در گوگلبوکس و سایر سایتهای آرشیوی جستوجو کرده و منابع شناسایینشده را در زبانهای مختلف تطبیق دهند. مدل کشف کرد که هم نیوتن و هم هارتلیب از آناگرامهای متفاوتی برای عبارت «زاج هنگری» (Hungarian vitriol) استفاده کردهاند.
در حالی که نیوتن از یک آناگرام واقعی ('Vltimorui') استفاده کرده بود که دقیقاً حروف کلمه vitriolum را جابهجا میکرد، هارتلیب از نوعی نوشتن معکوس بهره برده بود. بهطور مشخص، عبارت "Miloirtiua riciragnun" به صورت معکوس به "auitriolim" (نزدیک به uitriolum) و "nungaricir" (نزدیک به ungaricum) تبدیل میشود. مدل با تطبیق این کدها، مقادیر توصیف شده و یک یادداشت حاشیهای خاص با متن "vitriolum angaricum"، مدرک محکمی ارائه داد که نیوتن مستقیماً از دستنوشتههای هارتلیب استفاده کرده است. این یک یافته جدید است که با توجه به اهمیت نیوتن، شایسته انتشار علمی است.
مرزهای استدلال هوش مصنوعی
البته هر معمایی حلپذیر نیست. وقتی مدل GPT-6 Astra را مأمور بررسی کتاب Liber Loagaeth — کتابی رمزگذاری شده متعلق به جادوگر و اهل علوم غریبه، جان دی (John Dee) — کردند، مدل نتیجه گرفت که متن عمدتاً از هجاهای بیمعنی تشکیل شده است.
جان دی، که بر شخصیت «پروزپرو» در آثار شکسپیر و «فاوست» مارلو تأثیر گذاشت، معتقد بود با فرشتگان گفتگو میکند. او با همکاری یک «پیشگو» به نام ادوارد کلی (Edward Kelley) این «کتاب اسرار» را به «زبان فرشتگان» نوشت. حکم Astra این بود که کلی یک شیاد بوده و کتاب مذکور مهملات است.
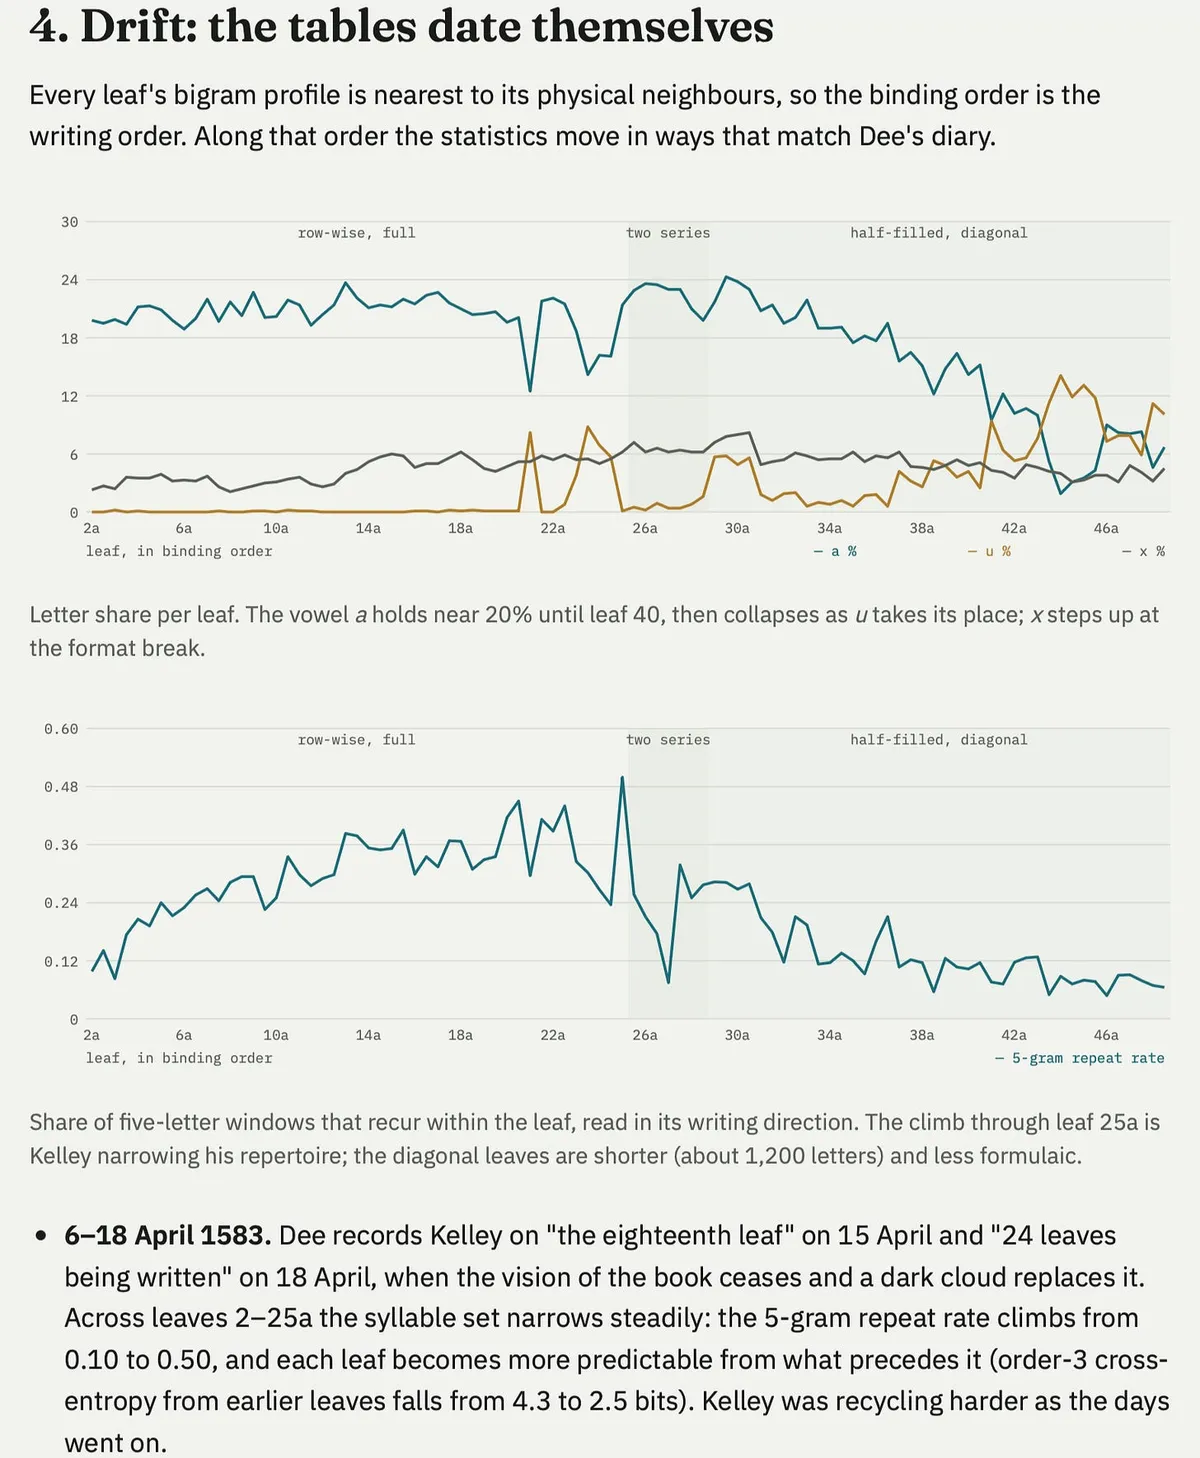
با این حال، مدل باز هم مفید بود؛ Astra با بررسی تکرار نویسهها و تطبیق آنها با دفتر خاطرات جان دی، تشخیص داد که نویسنده (ادوارد کلی) پس از تاریخی خاص، تنبل شده و جملات را بیشتر تکرار میکرده است. مدل حتی یک اشاره معنادار به موجودی اساطیری به نام Bornogo را پیدا کرد که بخشی از «جهان سینمایی جان دی» در اساطیر ابداعی اوست.
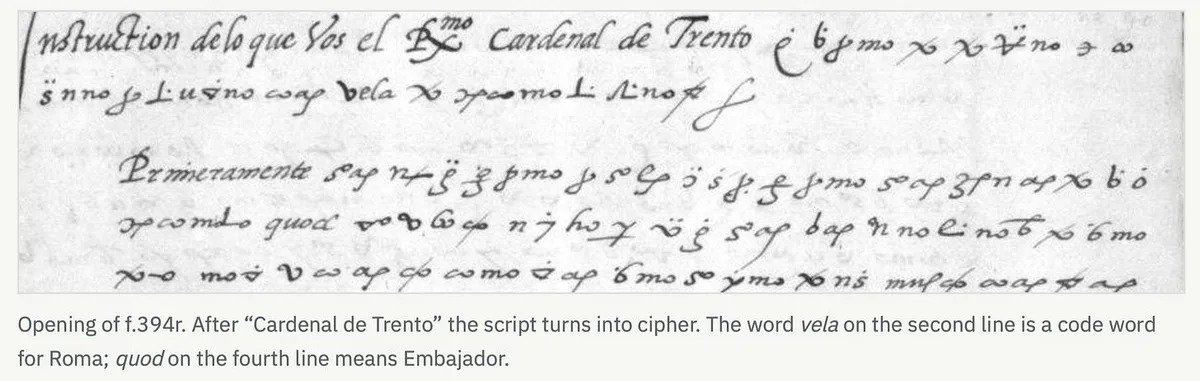
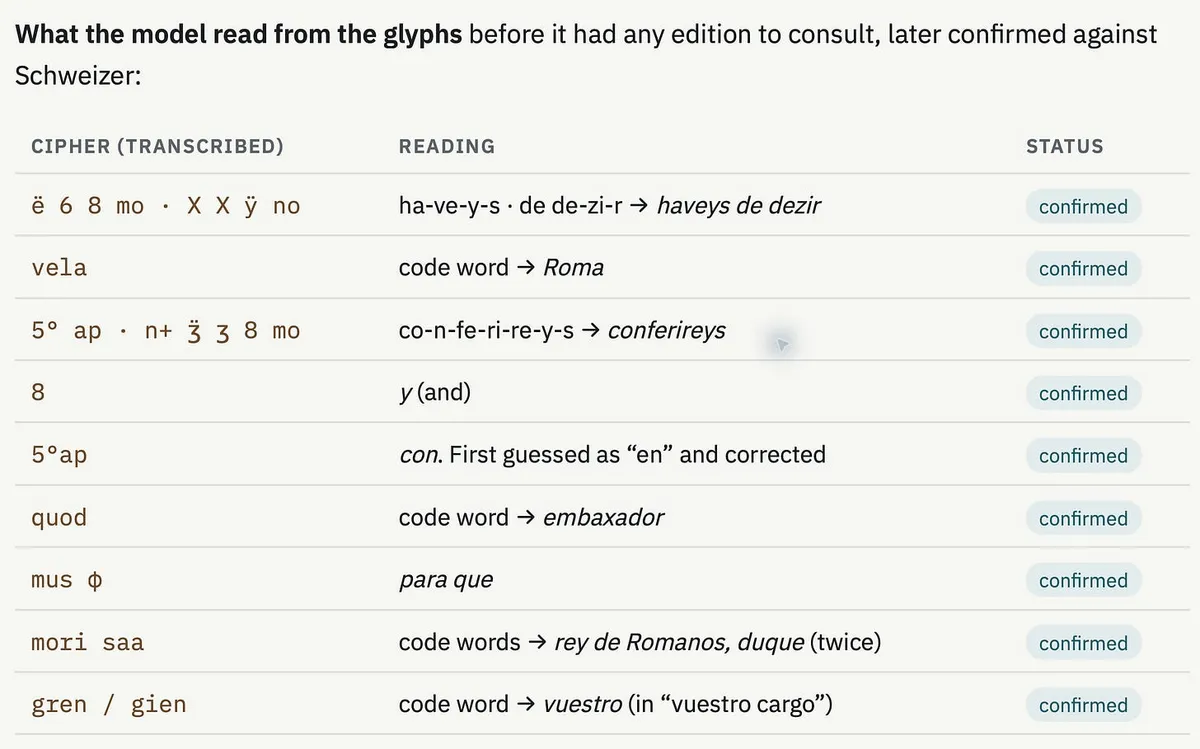
آزمونهای دیگر پتانسیل تکرار مدل را نشان داد. Opus 5.5 توانست دو نامه اسپانیایی قرن شانزدهم از امپراتور چارلز پنجم را بهطور جزئی رمزگشایی کند. نتایج درست بود، اما این نامهها پیش از این در سالهای ۱۵۳۰ و ۱۹۱۶ رمزگشایی شده بودند. این موضوع نشان میدهد که «پژوهش میدانی» (Desk Research) انسانی برای جلوگیری از تکرار کارهای چندصدساله ضروری است. همچنین این مورد به عنوان یک تست عمل کرد، زیرا Opus 5.5 تفاسیر خود را با متن سادهی «استاندارد طلایی» سال ۱۹۱۶ تطبیق داد.
گسترش افقهای پژوهشی
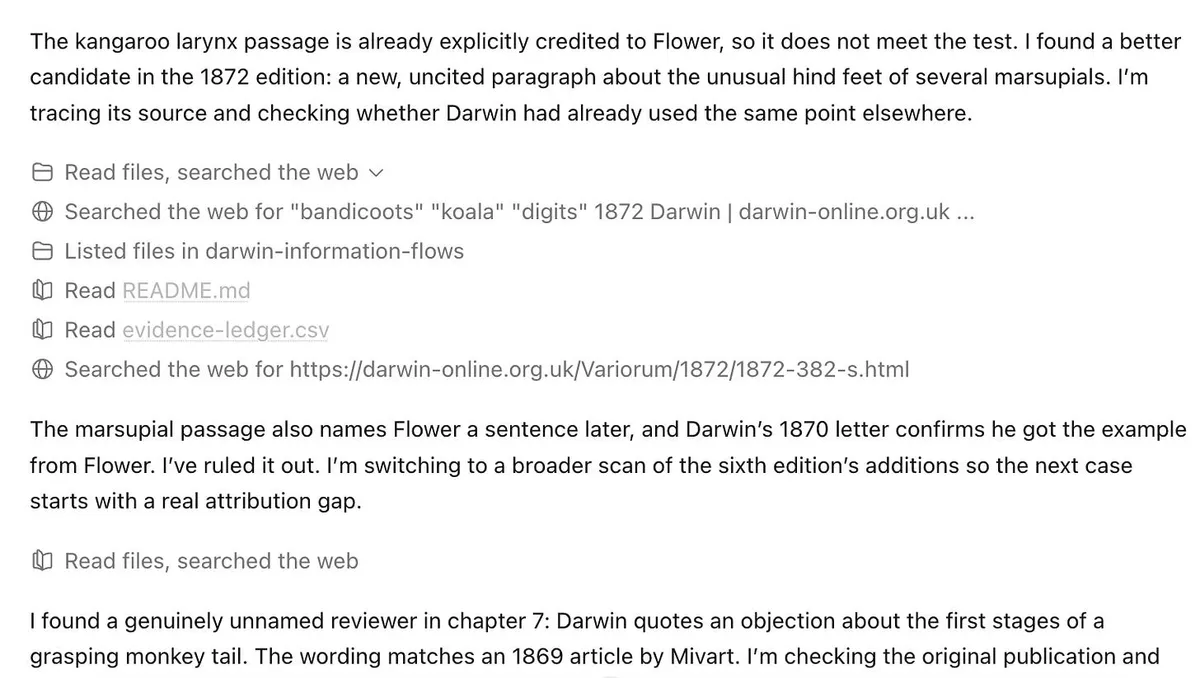
آزمایشهای اخیر نشان میدهد مدلهای پیشرو اکنون میتوانند بهطور مستقل پروژههای پژوهشی ارزشمند را طراحی کنند. برای مثال، GPT-6 پیشنهاد داد روی نوشتههای چارلز داروین تحقیق شود تا پیوندهای کشفنشده بین او و خبررسانانش درباره انتخاب طبیعی پیدا شود.
این پروژه شامل تحلیل دفترچههای داروین توسط مدل است — مانند بررسی ارجاعات به حنجره کانگورو یا اعتراضی درباره مراحل اولیه دمِ گیرنده میمون — با بهرهگیری از زیربنای «پروژه مکاتبات داروین». ماهیت چندزبانه این مدلها به آنها اجازه میدهد مجموعههای متنی را اسکن کنند که بسیار بزرگتر از توان خواندن هر انسانی است. این یک چرخش است: AI از یک ابزار بصریسازی داده به ابزاری تبدیل شده که میتواند پروژههایی در مقیاس یک مقاله پژوهشی یا پایاننامه دکترا را طراحی کند.
تلاشهای دیگر شامل GPT-6 Pro است که یک متن نجومی سانسکریت قرن هفدهم، یعنی Karaṇakesarī اثر اخترشناس «بهاسکارا» را تحلیل میکند تا الگوریتمهای مورد استفاده برای مدلسازی خورشیدگرفتگیها را بازسازی کند. اگرچه کاربرد تاریخی این وظیفه خاص هنوز مبهم است، اما توانایی مدل را در گسترش پژوهش به فراتر از افق دانش یک فرد واحد نشان میدهد.
مسیر دستیابی به اکتشافات سیستماتیک
در حال حاضر، این موفقیتها بهصورت پراکنده و توسط پژوهشگران منفرد که از سهمیه شخصی Codex و Claude Code استفاده میکنند، رخ میدهد. برای رسیدن به «مسائل هزاره» تاریخ — مانند خط Linear A، دستنوشته ووینیچ (که نویسنده گمان میکند محصول گرافومانیا یا وسواس نوشتن باشد) یا سایر منابع اولیه رمزگذاری شده — نویسنده سه پیشنهاد دارد:
۱. دسترسی آزاد: کتابخانهها باید برای دیجیتالی کردن دستنوشتههای در دسترس نبودن همکاری کنند و محدودیتهای دسترسی ویژه را بردارند. گلوگاه فعلی اغلب این است که اسناد دیجیتالی شدهاند اما آزادانه در دسترس نیستند. اکثریت قریب به اتفاق دستنوشتههای پیشامدرن هنوز دیجیتالی نشدهاند. در همین راستا، برخی از شرکتهای بزرگ مانند OpenAI در تلاشاند تا با دسترسی به آرشیوهای رها شده و پروندههای محرمانه شرکتهای ورشکسته، حجم دادههای آموزشی را افزایش دهند.
۲. گرنتهای محاسباتی: تاریخنگاران به دسترسی رایگان به API نیاز دارند تا بتوانند صدها یا هزاران عامل را روی مجموعههای داده بزرگ رها کنند و ببینند وقتی قدرت محاسباتی عظیم روی مسائل تاریخی اعمال میشود چه اتفاقی میافتد.
۳. نقشهبرداری مشارکتی: متخصصان باید فهرستی عمومی از مسائل «حلپذیر» ایجاد کنند تا تلاشهای AI را هدایت کنند، مشابه روشی که ریاضیدانان مسائل کلیدی را شناسایی میکنند.
تحلیل: از دستیار به بازرس
این گذار نشاندهنده حرکتی از «برونسپاری شناختی» (استفاده از AI برای نوشتن) به «گسترش شناختی» (استفاده از AI برای دیدن الگوها در میلیونها صفحه) است. برای کسبوکار آرشیوها و موزهها، این امر ارزش جدیدی برای دادههای دیجیتالی ایجاد میکند. دادههایی که زمانی «مرده» بودند، اکنون به داراییهای زندهای برای اکتشافات مبتنی بر AI تبدیل میشوند.
برای تاریخنگاران، ریسک جایگزینی نیست، بلکه تغییر در مجموعهی مهارتهاست. «متخصص» آینده کسی نخواهد بود که هر کتابی را خوانده است، بلکه کسی است که میداند چگونه یک معمای تاریخی را به عنوان یک مسئله «حلپذیر» برای یک مدل پیشرو فرموله کند. این موضوع بهویژه در مسائل مربوط به اصالت، نقلقولها و سرقتهای ادبی تاریخی شناسایینشده در میان زبانها و ژانرهای مختلف صادق است.
برای مشاهده این روند در عمل، میتوانید کارهای دانیل بوردو را بررسی کنید که مجموعهای از مسائل باز برای رمزنگاری تاریخی را نگه میدارد و تلاشهای خود را برای حل آنها با این مدلها مستند میکند. نویسنده همچنین با ناتان دیویس در آکسفورد روی «اولین امتحان بشریت» (Humanity’s First Exam) کار میکند؛ مجموعهای که برای بنچمارک کردن نحوه استدلال مدلهای AI درباره خودمختاری انسان و رابطه بین انسان و ماشین استفاده میشود. آنها بهطور خاص به دنبال «تسطیح معرفتشناختی» (Epistemological Flattening) هستند؛ وضعیتی که در آن AI به یک پاسخ میانه (Median) همگرا میشود، در حالی که انسانها تنوع بیشتری در پاسخها نشان میدهند.
گام بعدی شما
- اگر پژوهشگر هستید، سعی کنید مسائل خود را به صورت «پازلهای با جواب قابل تأیید» بازتعریف کنید تا برای مدلهای استدلالی قابل حل باشند.
- از مدلهای پیشرو برای ردیابی متون در زبانهای مختلف استفاده کنید تا تأثیرات متقاطع فرهنگی را بیابید.
- به دنبال آرشیوهای دیجیتال باز بگردید و آنها را به عنوان ورودی برای عاملهای پژوهشی به کار بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو