
اگر امروز مجموعهای از دستورالعملهای پیچیده برای اتوماسیون کارهایتان دارید، احتمالاً متوجه شدهاید که مدلهای جدید هر روز بخشی از این تخصصها را میبلعند. اما شکافهای باقیمانده، جایی است که مزیت رقابتی واقعی شما در آنجا شکل میگیرد. در ۱۶ سپتامبر ۲۰۲۶، یک پروژه متنباز جدید به نام Flint منتشر شد تا مشکل پراکندگی این قابلیتهای تخصصی در پلتفرمهای مختلف هوش مصنوعی را حل کند.
بسیاری از کاربران متوجه شدهاند که مهارتهای «عمومی» — همانهایی که برای پر کردن نقصهای مدلهای اولیه در کدنویسی یا قالببندی استفاده میشدند — در حال ناپدید شدن هستند. برای مثال، مهارتهایی مانند «Superpower» وجود داشتند تا حفرههای توانمندی مدل را پیش از آنکه مدلها به طور تهاجمی برای کدنویسی بهینه شوند، پر کنند. این قابلیتها اکنون مستقیماً در وزنهای باز (Open Weights) — یعنی همان ساختار داخلی مدل — جذب شدهاند. این وضعیت یک پارادوکس ایجاد میکند: در حالی که مهارتهای پایه اکنون بیفایده شدهاند، مهارتهای بسیار خاص و خصوصی ارزشمندتر شدهاند، زیرا این مهارتها بر دادههایی تکیه دارند که هوش مصنوعی نمیتواند در مجموعه دادههای آموزشی (Corpus) خود پیدا کند. این تغییر در ماهیت تخصصها، یادآور دیدگاههای اندرو انجی درباره مهارتهای حیاتی توسعهدهندگان در عصر AI است که بر لزوم انطباق با ابزارهای جدید تأکید دارد.
ماهیت «لایه مهارت»
برای درک دلیل اهمیت تداوم مهارتها، مفید است که به هوش مصنوعی از دریچه تئوری مهندسی نرمافزار نگاه کنیم. در این چارچوب، خودِ مدل معادل لایه «زبان برنامهنویسی» است، در حالی که لایه مهارتها معادل «مجموعه ابزارها» (Toolkits) است.
همانطور که یک آرایه (Array) یا یک نقشه (Map) باید در ذات زبان برنامهنویسی تعبیه شده باشد و نباید برای استفاده از آنها به یک بسته شخص ثالث نیاز باشد، قابلیتهای جهانی نیز باید در خود مدل باشند. با این حال، منطقهای خاص — مانند تحلیل فاکتورهای یک شرکت خاص — نباید بخشی از لایه زبان باشند. یک مهارت باید دقیقاً در این جایگاه قرار بگیرد: چیزی که تا حدی قابلیت استفاده مجدد دارد، اما آنقدر جهانی نیست که بخشی از مدل شود، و چیزی که هوش مصنوعی دادههای کافی برای یادگیری مستقل آن را در اختیار ندارد.
مثالهایی از مهارتهای تخصصی با ارزش بالا
با بهبود مدلها، محدوده مهارتهای مفید به وظایفی با «قابلیت استفاده مجدد متوسط» محدود شده است. اینها کارهایی هستند که تکرار دستیشان خستهکننده است، اما برای اشتراک جهانی بیش از حد خاصاند. مثالهای برجسته عبارتند از:
- پشتههای فناوری قدیمی (Legacy Tech Stacks): یک مجموعه ابزار داخلی و قدیمی که فقط چند برنامهنویس ارشد شرکت آنها را میشناسند. چون این دانش فقط در ذهن توسعهدهندگان است و در وب منتشر نشده، یک مدل عمومی نمیتواند آن را یاد بگیرد. این یک کاندیدای عالی برای تبدیل شدن به مجموعهای از مهارتهای منجمد شده به عنوان دانش تیمی است. در این راستا، بحث بر سر این است که آیا اتکای بیش از حد به این ابزارهای خودکار مانع از شکلگیری تفکر سیستمی در برنامهنویسان تازهکار میشود یا خیر.
- گردشکارهای شخصیسازی شده: یک سیستم خاص برای مدیریت تسکها در Notion و تولید گزارشهای هفتگی از آن دادهها. این مورد برای یک مدل جهانی بیش از حد جزئی است، اما برای کاربر فردی بسیار ارزشمند است.
- راهکارهای دور زدن ضد-اسکرپینگ: مهارتی که یک مرورگر را با استفاده از کوکیهای واقعی هدایت میکند تا سایتهای دارای سیستمهای ضد-اسکرپینگ تهاجمی را دور بزند. بستهبندی این قابلیت آسان است، اما دانلود معادل آن از اینترنت تقریباً غیرممکن است.
مشکل پراکندگی (Fragmentation)
کاربران مدرن هوش مصنوعی اغلب برای استفاده از توکنهای رایگان یا بهرهمندی از نقاط قوت مدلهای مختلف، بین عاملهای (Agents) مختلف جابهجا میشوند. شما ممکن است یک روز از WorkBuddy استفاده کنید، روز بعد به سراغ TraeWork بروید یا قابلیتهای Qwen و Xiaomi را بررسی کنید. این موضوع یک سربار مدیریتی عظیم ایجاد میکند:
- سیلوهای مهارت: مهارتی برای تولید گزارش که در یک عامل ساخته شده، در عامل دیگر غیرقابل استفاده است. اگرچه ابزارهایی مانند
npxبرای مدیریت مهارتها وجود دارند، اما آنها بیشتر بر توزیع تمرکز دارند تا مدیریت داراییهای شخصی. این باعث میشود هزینه جابهجایی بین عاملها دردناک باشد، زیرا مهارتهای سفارشی شما به راحتی تحت ابزارهایی مثلnpxقرار نمیگیرند. - تورم توکنها: نصب یک کتابخانه عظیم شامل ۲۰۰ مهارت در یک پرامپت سیستمی (System Prompt) میتواند ۱۰,۰۰۰ تا ۲۰,۰۰۰ توکن سربار به هر گفتگو اضافه کند (با تخمین ۵۰ تا ۱۰۰ توکن برای هر توصیف). این موضوع هزینهها را در دهها رفتوبرگشت گفتگو به شدت افزایش میدهد.
- نویز بازیابی: وجود مهارتهای نامرتبط زیاد در یک پرامپت، احتمال اینکه مدل ابزار اشتباه را انتخاب کند یا ابزار درست را کاملاً نادیده بگیرد، افزایش میدهد؛ درست مانند گشتن دنبال آچار خود در جعبهابزاری که پر از ابزارهای دیگران است.
- شکاف قابلیت استفاده مجدد: اکثر مهارتهای مشترک که از اینترنت دانلود میشوند، بدون تغییر (Out of the box) به درستی کار نمیکنند. اگر مهارتی واقعاً قابلیت استفاده مجدد بالایی داشت و فوراً کار میکرد، احتمالاً تا به حال توسط خود مدل جذب شده بود.
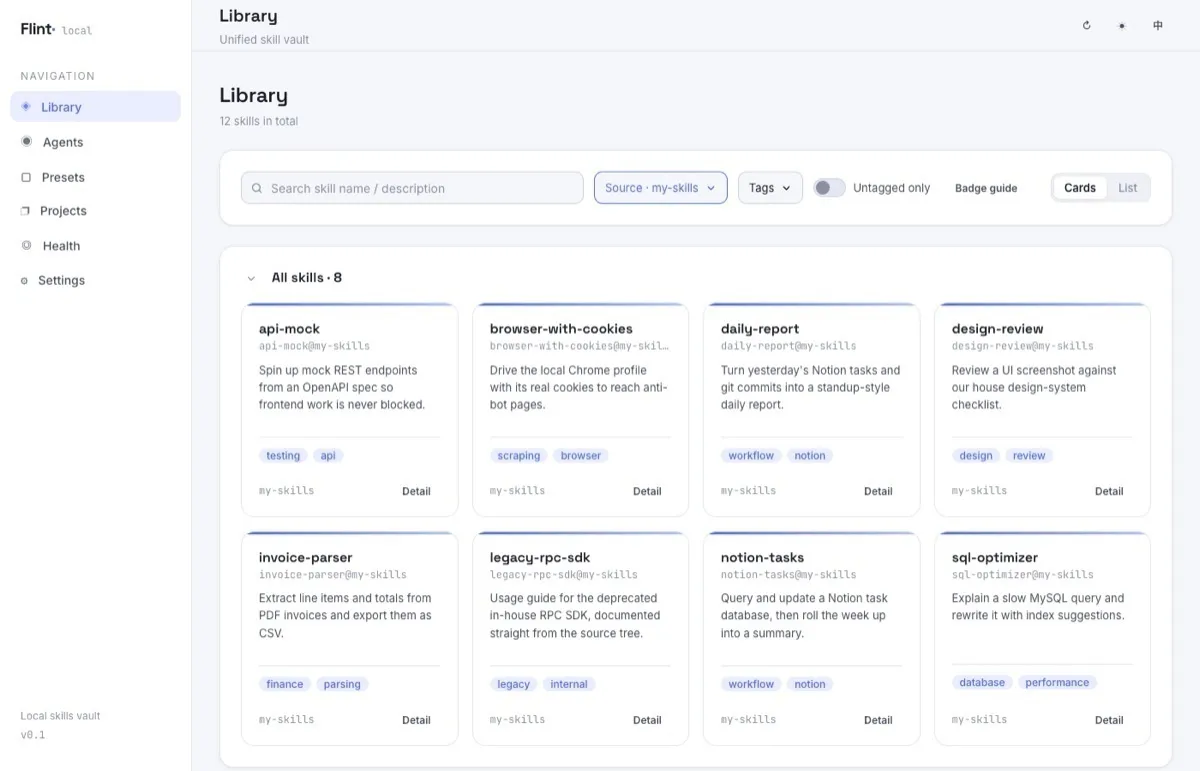
Flint به عنوان یک مدیریت دارایی شخصی با رویکرد «اول محلی» (Local-first) عمل میکند. این سیستم با مهارتها نه به عنوان ورودیهای یک پایگاهداده ابری، بلکه به عنوان فایلهایی روی دیسک شما برخورد میکند. سیستم از یک خط لوله «جمعآوری $\rightrightarrows$ سازماندهی $\rightrightarrows$ استقرار» برای همگامسازی ابزارها استفاده میکند.
معماری این ابزار شامل یک بکاِند محلی و یک فرانتاِند وب است که با یک اسکریپت واحد اجرا میشود. مخزن مهارتهای شما یک دایرکتوری استاندارد روی دیسک است. سپس Flint این مهارتها را از طریق Symlink یا کپی به عاملهای مختلف توزیع میکند تا اطمینان حاصل شود که تنها یک نسخه اصلی (Master Copy) از هر مهارت در قلمرو شما قرار دارد.
ماژولهای عملکردی اصلی
سیستم Flint به شش ماژول سازمانیافته تقسیم شده است که هر کدام وظیفه خاصی دارند:
- کتابخانه (Library): مرکز اصلی برای مرور، جستوجو و فیلتر کردن مهارتها. کاربران میتوانند فایلهای خام
SKILL.mdرا پیشنمایش کنند، تگها را ویرایش کنند و منشأ یک مهارت را ردیابی کنند. اینجا جایی است که شما مخازن شخصی و مخازن Third-party (فقط خواندنی) را ثبت میکنید، مهارتهای پراکنده در عاملها را به مخزن بازمیگردانید یا از هر دایرکتوری به صورت دستهجمعی وارد میکنید. - عاملها (Agents): یک صفحه مدیریتی با یک کارت برای هر دایرکتوری واقعی مهارتها. در اینجا کاربران عاملها را به عنوان «فعال» علامتگذاری میکنند، پیشفرضها (Presets) را متصل میکنند، مهارتها را به صورت تکتک فعال/غیرفعال میکنند و برای هر مهارت بین استقرار از طریق Symlink یا کپی یکی را انتخاب میکنند.
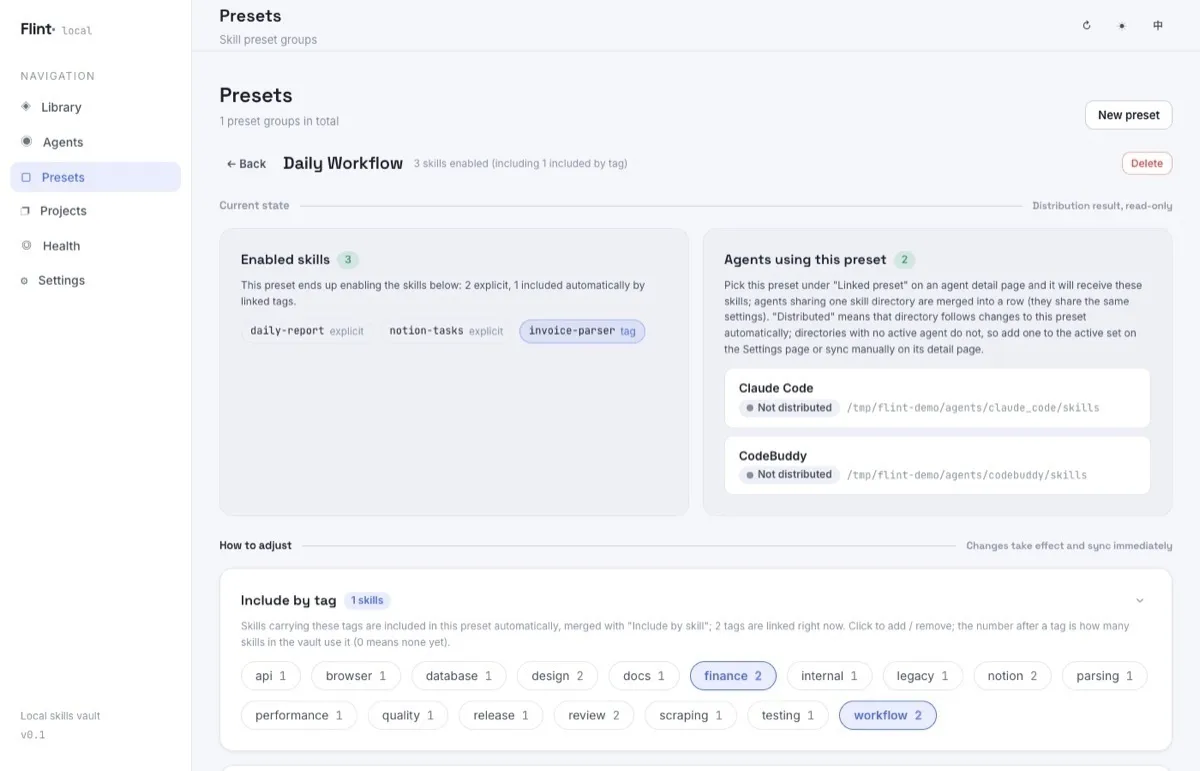
- پیشفرضها (Presets): دستههایی از مهارتها که توسط اعضای صریح (Explicit Members) در ترکیب با مهارتهای منطبق با تگهای مرتبط تعریف میشوند. پیشفرضها کلید روشن/خاموش ندارند؛ به محض تغییر اعضا یا تگها، آنها فوراً به تمام عاملهای فعال متصل شده توزیع میشوند.
- پروژهها (Projects): ادغام با مسیرهای پروژه و تگها. مهارتهای منطبق به طور خودکار در دایرکتوری
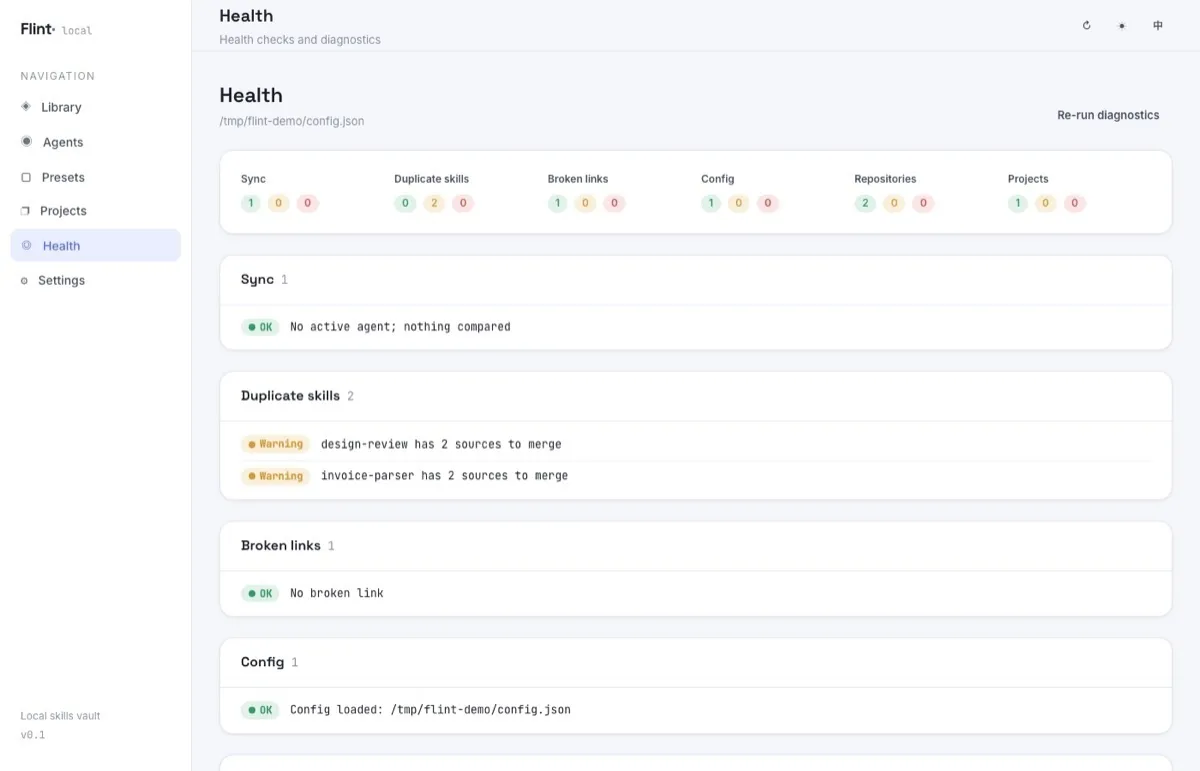
.agents/skillsپروژه قرار میگیرند که در بین ماشینهای مختلف مستقل است و میتواند در Git ثبت (Commit) شود. مهارتهایی که در داخل یک پروژه تکامل یافتهاند نیز میتوانند به مخزن اصلی بازگردانده شوند. - عیبیابی (Diagnostics): یک سیستم بررسی سلامت که شش بعد را پوشش میدهد: همگامسازی، تکراریها، Symlinkهای شکسته، پیکربندی، مخازن و پروژهها. تمام مشکلات در یک جا لیست شده و پس از تأیید، با یک کلیک قابل رفع هستند.
- تنظیمات (Settings): کنترل روش نصب پیشفرض (Symlink/Copy)، مدیریت واچر همگامسازی افزایشی برای حالت کپی، مدیریت عاملهای سفارشی و مشاهده لاگها.
فلسفه «Obsidian» برای هوش مصنوعی
Flint نام و فلسفه خود را از Obsidian، ابزار مدیریت دانش، گرفته است. همانطور که ابسیدین شیشهای آتشفشانی است که با ضربه به تیغ تبدیل میشود، Flint نیز «سنگِ ابزار» برای مهارتهاست. این ابزار سه اصل محوری را به کار میگیرد:
۱. محلی یعنی خصوصی: مهارتها فقط به عنوان فایلهای معمولی روی دیسک محلی وجود دارند. هیچ ابر، هیچ حساب کاربری و هیچ تلهمتری (جمعآوری داده) وجود ندارد.
۲. فرمتهای باز: یک مهارت صرفاً یک دایرکتوری SKILL.md روی دیسک است. این تضمین میکند که کاربران هرگز در اکوسیستم Flint زندانی نشوند و بتوانند داراییهای خود را با Git ویرایش، مقایسه (Diff) یا ثبت کنند.
۳. تیز کردن ابزارها: فرآیند جمعآوری، حذف تکراریها و تگگذاری به عنوان «تراش دادن» (Knapping) توصیف میشود — یعنی ضربه زدن به دادههای خام برای تبدیل آنها به ابزارهای دقیق. فرآیند استقرار نیز همان «جرقه» است که اجازه میدهد این ابزارها مشتعل شده و به کار بیفتند.
برای حفظ سازگاری، Flint تگها را در بخش Frontmatter سطح بالای فایل SKILL.md مینویسد. این کار از اجماع متنباز پیروی میکند و تضمین میکند که بیش از ۴۰ ابزار دیگر، از جمله Claude Code و agentskills.io، بتوانند این متادیتاها را به صورت بومی بخوانند. علاوه بر این، Flint با حذف خودکار مهارتهای همنام از منابع مختلف، تکهتکه شدن اکوسیستم را به حداقل میرساند. تفاوتها و ارجاعات شکسته در صفحه عیبیابی نمایش داده میشوند تا در همانجا مدیریت شوند.
شروع به کار
Flint ابزار کوچکی است که به صورت محلی روی Node.js نسخه ۲۰ یا بالاتر اجرا میشود. کوتاهترین مسیر برای استقرار شامل چهار گام است:
۱. نصب: اجرای ./start.sh در ریشه مخزن. این اسکریپت نسخههای Node، وابستگیها و پورتهای مورد استفاده را بررسی کرده و سپس npm install را اجرا میکند. فرانتاِند در localhost:5173 و API بکاِند در localhost:8787 در دسترس خواهد بود.
۲. ثبت یک مخزن: تعریف یک دایرکتوری روی دیسک به عنوان «منبع حقیقت» (Source of Truth). مخازن Third-party به صورت فقط خواندنی ثبت میشوند، هرچند مهارتهای آنها را میتوان در هر زمان به مخزن شخصی وارد کرد.
۳. ایجاد یک پیشفرض: گروهبندی مهارتها با استفاده از ترکیبی از اعضای صریح و تگهای مرتبط. صفحه جزئیات پیشفرض به کاربران اجازه میدهد این موارد را از طریق گزینههای «شامل کردن بر اساس تگ» و «شامل کردن بر اساس مهارت» تنظیم کنند.
۴. اعمال پیشفرض روی یک عامل: علامتگذاری یک عامل به عنوان «فعال» در صفحه جزئیات آن و متصل کردن پیشفرض مورد نظر.
این گردشکار اصطکاک جابهجایی بین عاملها را از بین میبرد. به جای بازسازی مجموعه ابزارها با هر بار انتشار مدل جدید، کاربر صرفاً کتابخانه داراییهای شخصی موجود خود را به عامل جدید متصل میکند.
تحلیل: تغییر به سمت مهارتهای «دادههای کوچک» (Small-Data)
این توسعه نشاندهنده تغییری در نحوه نگاه ما به بهرهوری هوش مصنوعی است. ما در حال فاصله گرفتن از «مهندسی پرامپت» به عنوان یک مهارت عمومی و حرکت به سمت «مدیریت دارایی» قابلیتهای خصوصی هستیم. ارزش دیگر در دانستن نحوه صحبت با هوش مصنوعی نیست، بلکه در مالکیت مجموعههای ابزار خاص و خصوصی است که هوش مصنوعی میتواند آنها را اجرا کند.
برای یک متخصص معمولی، این بدان معناست که «خندق رقابتی» (Moat) دیگر ابزار هوش مصنوعی نیست که او استفاده میکند، بلکه کتابخانهای از فایلهای SKILL.md است که در طول زمان گردآوری و اصلاح کرده است. با جداسازی مهارت از عامل، کاربر مالکیت گردشکار خود را باز مییابد و با مدل هوش مصنوعی به عنوان یک موتور قابل جایگزین برخورد میکند، نه به عنوان مالک منطق کاری.
در آینده منتظر ظهور «بازارهای مهارت» استاندارد باشید که از فرمت SKILL.md پیروی میکنند؛ این امر به کاربران اجازه میدهد گردشکارهای تخصصی سطح حرفهای را به همان راحتی که اکنون پلاگینها را نصب میکنند، وارد سیستم خود کنند.



گفتگو