اگر برای بهینهسازی استنتاج محلی روی سختافزارهای اپل تلاش میکنید، احتمالاً تصور میکنید پردازش همزمان چندین درخواست همیشه سرعت را بالا میبرد. اما یک گزارش فنی نشان میدهد که گاهی همین «بهینهسازیها» میتوانند عملکرد سیستم را به شدت تخریب کنند.
طبق گزارشی که در ۱۱ اکتبر ۲۰۲۶ منتشر شد، فعال کردن دستهبندی پیوسته (Continuous Batching) — شبیه به مدیریت صف در یک رستوران که به جای انتظار برای تکمیل یک میز، هر ظرف آماده را سریعاً سرو میکند — توان عملیاتی (Throughput) کلی را در یک مکمینی M2 با ۱۶ گیگابایت حافظه یکپارچه، از ۱۶.۸ به ۸.۷ توکن در ثانیه کاهش داد. این افت شدید هنگام اجرای مدل ۴-بیتی Qwen2.5 7B رخ داد، در حالی که هر درخواست ۵۱۲ توکن تولید میکرد و رمزگشایی گمانهزنانه (Speculative Decoding) غیرفعال بود. این موضوع در تضاد با تلاشهای اخیر برای افزایش سرعت است، همانطور که راهکارهای جدید برای شتاببخشی به توکنها از طریق دور زدن گلوگاه حافظه سعی دارند کارایی را بدون افت کیفیت ارتقا دهند.
بسیاری از توسعهدهندگان بر این باورند که پردازش دستهای با بازاستفاده از وزنهای مدل، همیشه کارایی را افزایش میدهد. با این حال، این فرض زمانی شکست میخورد که بکاند سختافزاری، هستههای اجرایی (Execution Kernels) را بر اساس تعداد ردیفهای ورودی تغییر دهد. همانطور که در تحلیل قبلی ما دربارهی شکاف قابلیتهای مدلهای زبانی اشاره کردیم، این مورد برجسته میکند که چگونه جزئیات لایههای پایین پیادهسازی میتوانند دستاوردهای معماری سطح بالا را خنثی کنند.
سازوکار انتخاب هسته
به نقل از مستندات فنی این پروژه، کند شدن سیستم به دلیل یک آستانه (Threshold) خاص در مسیر Metal فریمورک Candle رخ داده است. منطق این انتخاب در فایل candle-core/src/quantized/metal.rs (خط ۳۷۲) قرار دارد. کد ابتدا تعداد ردیفهای ورودی را بررسی میکند: اگر بعد ورودی برابر با ۱ باشد، مسیر fwd_mv را برمیگرداند. در غیر این صورت، در خط ۴۱۴، تابع call_quantized_matmul_mm_t فراخوانی میشود.
وقتی تنها یک درخواست پردازش میشود، سیستم از مسیر GEMV (ضرب ماتریس در بردار یا General Matrix-Vector multiplication) استفاده میکند که در آن وزنها در یک بردار ضرب میشوند. اما به محض اضافه شدن درخواست دوم، ورودی از یک ردیف به دو ردیف تغییر میکند. این اتفاق باعث سوئیچ به مسیر GEMM (ضرب ماتریس در ماتریس یا General Matrix-Matrix multiplication) میشود که برای مدیریت چندین بردار ورودی به صورت همزمان طراحی شده است.
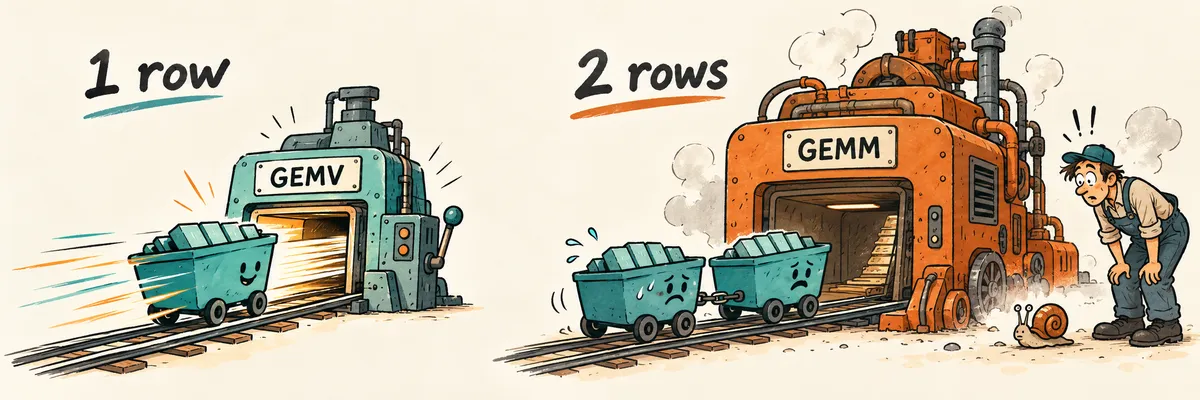
اگرچه GEMM برای دستههای بزرگ طراحی شده، اما سربار (Overhead) آن برای تنها دو درخواست، بیشتر از سودش بود. توسعهدهنده برای حل این مشکل، یک راهکار جایگزین (Fallback) پیاده کرد که ورودیهای کوچک را به ردیفهای تکتایی تقسیم کرده و برای هر کدام GEMV را اجرا میکند و سپس نتایج را به هم متصل (Concatenate) میکند. این تغییر، توان عملیاتی را برای اندازه دسته ۲، دوباره به ۱۶.۲۵ توکن در ثانیه رساند که تقریباً با خط پایه بدون دستهبندی (۱۶.۱۵ توکن/ثانیه) برابری میکرد.
محکهای عملکردی
آزمونها نشان داد که یک نقطه عطف مشخص وجود دارد که در آن GEMM در نهایت به انتخاب سریعتری تبدیل میشود. نتایج توان عملیاتی کلی بر حسب توکن در ثانیه به شرح زیر است:
- ۳ درخواست: روش GEMV ردیفی (۱۷.۵۲ توکن/ثانیه) بر GEMM (۱۳.۰۵ توکن/ثانیه) پیروز شد که تفاوتی معادل ۱۳۴.۳٪ است.
- ۴ درخواست: روش GEMV ردیفی (۱۸.۰۷ توکن/ثانیه) با اختلاف اندکی بر GEMM (۱۶.۵۵ توکن/ثانیه) برتری داشت (تفاوت ۱۰۹.۲٪).
- ۵ درخواست: در نهایت GEMM (۱۹.۹۲ توکن/ثانیه) از GEMV ردیفی (۱۸.۰۶ توکن/ثانیه) پیشی گرفت و نسبت عملکرد به ۹۰.۷٪ رسید.
بر اساس این نتایج، توسعهدهنده تعداد چهار ردیف را به عنوان آستانه پیشفرض برای سوئیچ کردن در این حجم کاری خاص انتخاب کرد.
علاوه بر سرعت، این سوئیچ باعث بروز یک مشکل ظریفتر شد: ناپایداری عددی. توسعهدهنده متوجه شد که استفاده از GEMM به جای GEMV، متن تولید شده را تغییر میدهد، حتی وقتی از رمزگشایی حریصانه (Greedy Decoding) — شبیه به انتخاب همیشگی کوتاهترین مسیر در یک نقشه بدون بررسی گزینههای دیگر — استفاده میشود. در یک تست، از مدل Qwen خواسته شد تا صحنهای علمی-تخیلی درباره یک مکانیک و یک آرشیویست بنویسد که در حال بررسی یک سیگنال اضطراری در یک گلخانه متروکه در ماه هستند؛ نتیجه این شد که دو داستان کاملاً متفاوت تولید شد.
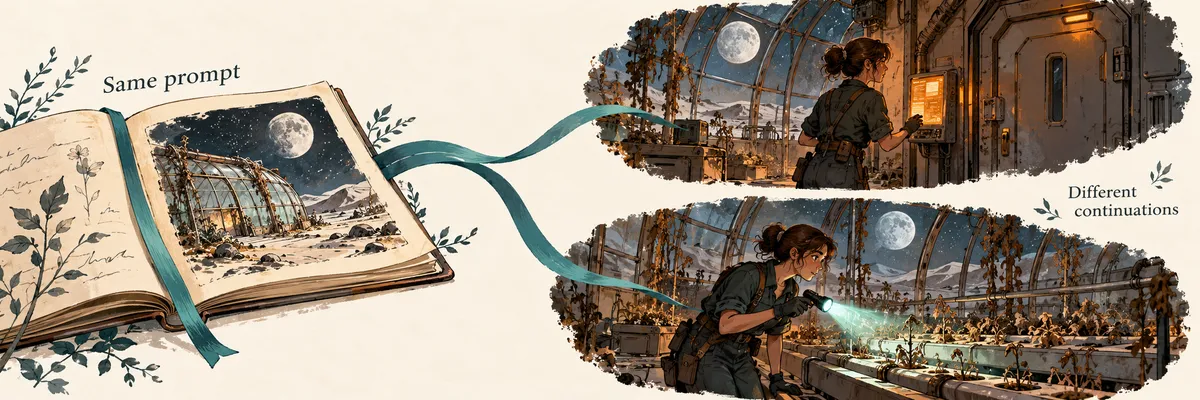
در ابتدا ۵۹۷ کاراکتر دقیقاً یکسان بودند، اما سپس ادامهی متنها از هم جدا شدند. مسیر GEMM متنی تولید کرد که میگفت: «مارا به سمت در دوم رفت، جایی که یک ترمینال اضطراری قرار داشت...» در حالی که مسیر GEMV تولید کرد: «پرتو چراغقوهی مارا تاریکی را شکافت و ردیفهایی از بسترهای هیدروپونیک خشک را روشن کرد...»
واگرایی عددی و حافظه KV
این واگرایی به این دلیل رخ داد که هستهها نتایج اعداد ممیز شناور (Floating-point) متفاوتی تولید کردند. در یک تست رمزگشایی گمانهزنانه با استفاده از مدل Qwen2.5 0.5B برای پیشنهاد چهار توکن در هر مرحله، نرخ پذیرش پیشنویس (Draft Acceptance Rate) از ۳۲.۹٪ در حالت سریال به ۳۷.۱٪ در حالت همزمان تغییر کرد.
ردیابی تست نشان داد که در توکن ۴۷۶، مدل پیشنهاددهنده (Drafter) شناسههای توکن یکسانی را پیشنهاد داد، اما امتیازات هدف (Target Scores) جابهجا شدند. در پذیرش سریال، توکن ۴۷۶ امتیاز ۲۵.۵۷۱۲۳۲ و توکن ۳۲۳ امتیاز ۲۵.۵۶۵۷۷۵ را کسب کردند. اما در دستهبندی پیوسته، امتیاز توکن ۴۷۶ به ۲۵.۵۴۹۶۱۸ افت کرد در حالی که امتیاز توکن ۳۲۳ به ۲۵.۵۶۲۲۲۰ افزایش یافت. این تغییر بسیار ناچیز برای تغییر انتخاب حریصانه مدل کافی بود.
نکته تکاندهنده این است که این اثر حتی پس از پایان سایر درخواستهای موجود در دسته باقی ماند. دلیل این واگرایی، یک دستهی قبلی بود که ۱۲۰ توکن پیشپُرکردن (Prefill) از یک درخواست جدید را با چهار توکن تأیید (Verification) از یک درخواست موجود ترکیب کرده بود. این ۱۲۴ ردیف از آستانه عبور کرده و GEMM را فعال کردند و تفاوتهای عددی را وارد وضعیت ذخیره شده در حافظه KV (KV Cache) کردند. حافظه KV شبیه به یادداشتهای سریع مدل از کلمات قبلی است تا مجبور نباشد هر بار همه چیز را از اول بخواند. این چالش در مدیریت حافظه، ما را به یاد بحث حافظه مجازی در برابر تخصیص ایستا در مدیریت KV-Cache میاندازد که به دنبال بهینهسازی فضای ذخیرهسازی این دادههای حیاتی است. حتی وقتی سیستم برای درخواست باقیمانده به GEMV بازگشت، تفاوتهایی که قبلاً در حافظه KV ذخیره شده بودند، پابرجا ماندند.
این یعنی یک تصمیم موقت برای دستهبندی، میتواند مسیر یک گفتگو را برای همیشه تغییر دهد. برای توسعهدهندگان موتورهای استنتاج محلی، این ثابت میکند که بهینهسازیهایی مثل دستهبندی پیوسته میتوانند رفتارهای غیرقطعی (Non-deterministic) در رمزگشایی حریصانه ایجاد کنند که قاعدتاً باید قطعی باشد.
این موضوع تمرکز را از زمانبندی سطح بالا (High-level Scheduling) به دقت هستههای بکاند منتقل میکند. اگر در حال بهینهسازی برای سختافزارهای لبه (Edge) مانند Apple Silicon هستید، نمیتوانید به انتخاب پیشفرض هسته برای همزمانیهای مقیاس کوچک اعتماد کنید. برای کسانی که به دنبال بهرهوری حداکثری در این پلتفرم هستند، تجربه تنظیم دقیق مدلهای کوچک روی مک نشان میدهد که سختافزار اپل پتانسیل بالایی دارد، مشروط بر اینکه لایههای پایین به درستی مدیریت شوند.
برای تضمین خروجی سازگار و حداکثر سرعت، توسعهدهندگان باید نقطه تلاقی (Crossover Point) بین GEMV و GEMM را برای سختافزار و کوانتش مدل خاص خود به صورت دستی پروفایل کنند. میتوانید با بازرسی منطق انتخاب هسته در بکاند خود شروع کنید تا ببینید آیا دستههای کوچک باعث فعال شدن مسیرهای ناکارآمد میشوند یا خیر.
گام بعدی شما
- اگر از سختافزارهای Apple Silicon استفاده میکنید، هرگز به انتخاب پیشفرض هستهها برای تعداد درخواستهای کم اعتماد نکنید.
- منطق انتخاب هسته در بکاند خود را بررسی کنید تا مطمئن شوید دستههای کوچک باعث فعال شدن مسیرهای ناکارآمد نمیشوند.
- نقطه تلاقی سرعت GEMV و GEMM را برای مدل و کوانتش خاص خود به صورت دستی پروفایل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو