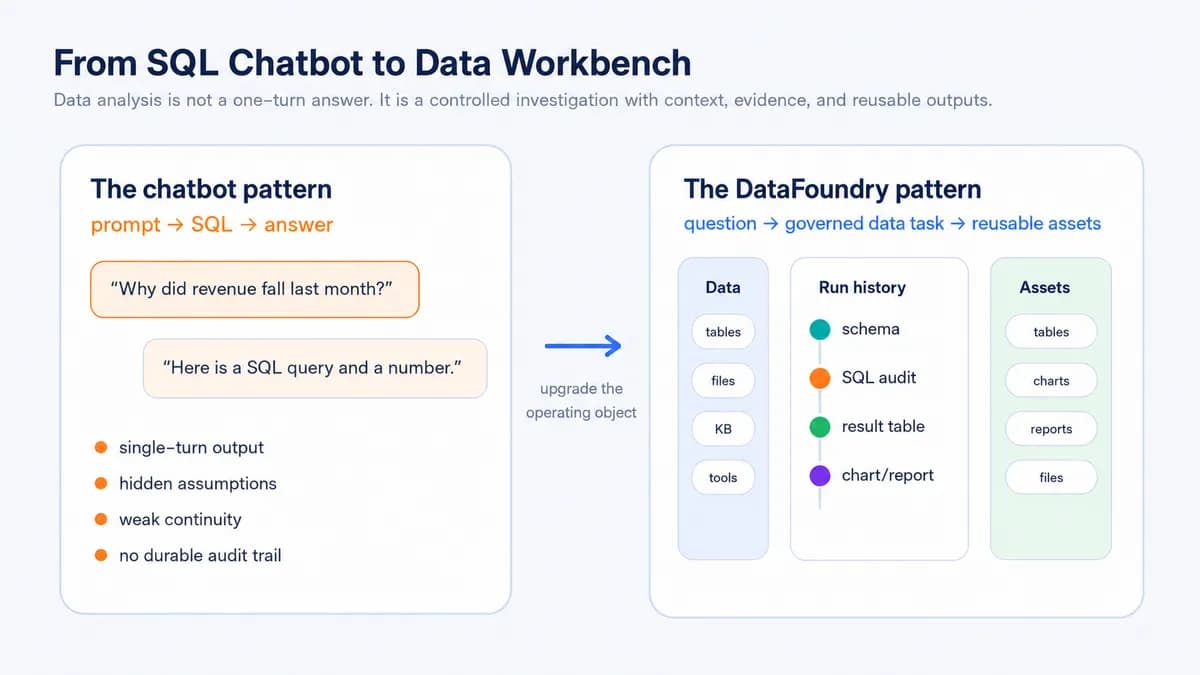
اگر مدیر داده یا تحلیلگری هستید که هر بار برای بررسی یک گزارش ساده باید ساعتها کد SQL را دیباگ کنید، بدانید که عصر «پرسش و پاسخ» ساده در تحلیل دادههای پیچیده به پایان رسیده است. یک پرامپت طبیعی تنها نمیتواند پاسخ یک سؤال استراتژیک تجاری را بدهد؛ تحلیل واقعی نیازمند یک جریان کاری است، نه یک پنجره چت ساده. در حالی که اکثر ابزارهای هوش مصنوعی با تحلیل دادهها به عنوان یک تعامل سادهی چت برخورد میکنند، DataFoundry که به عنوان یک پروژه متنباز عرضه شده است، این پارادایم را از یک چتبات به یک «میز کار نظارتی» (Governed Workbench) تغییر میدهد و با تحلیل دادهها به جای یک مسئله پرسش و پاسخ تکمرحلهای، به عنوان یک جریان کاری چندمرحلهای برخورد میکند.
اکثر استقرارهای هوش مصنوعی در سازمانها با شکافی عمیق بین «دموی موفق» و «آمادگی برای تولید» دستوپنجه نرم میکنند. یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بهراحتی کد SQL مینویسد، اما اغلب در درک تعاریف تجاری خاص شرکت شکست میخورد یا ریسک تغییر دادههای عملیاتی (Production) را به همراه دارد. ابزارهای فعلی معمولاً یک مسیر خطی را دنبال میکنند: پرامپت $\rightleftharpoons$ SQL $\rightleftharpoons$ پاسخ. این رویکرد ماهیت تکرارشوندهی تحلیلهای واقعی را نادیده میگیرد؛ تحلیلی که نیازمند بازرسی طرحواره (Schema)، شفافسازی معیارها (Metrics) و اعتبارسنجی نتایج است.
در دنیای واقعی، پرسشهای عملی متعددی ایجاد میشوند: عامل از کدام جداول استفاده کرد؟ آیا مدل متوجه شد که «درآمد» در شرکت ما دقیقاً به چه معناست؟ آیا میتوانم کد SQL را ببینم؟ آیا میتوانم این تحلیل را بعداً بازپخش (Replay) کنم؟ آیا مدل هرگز به اعتبارنامهها (Credentials) دسترسی داشت؟ آیا میتوانم از نمودار، جدول یا گزارش تولید شده در جای دیگری استفاده کنم؟
DataFoundry با قرار دادن عامل (Agent) در یک فضای کاری نظارتی، این نقاط شکست را برطرف میکند. این رویکرد یادآور تلاشهای مشابه برای خودکارسازی مدیریت دیتابیس است، مانند آنچه در بهکارگیری الگوی ReAct توسط Pilotbase برای کاهش بار ذهنی توسعهدهندگان مشاهده شد. بر اساس مستندات فنی این پروژه، این طراحی تضمین میکند که مدل هرگز با اعتبارنامههای خام دیتابیس سر و کار نداشته باشد. در عوض، تمام دسترسیها از طریق یک «درگاه داده» (Data Gateway) جریان مییابند که اجرای «فقط خواندنی» (Read-only)، محدودیت تعداد ردیفها، تایماوتها و ماسک کردن دادههای حساس را اجبار میکند.
مشکل: تحلیل داده، یک پیام چت نیست
در یک دموی ساده، چتبات یک پرامپت را به SQL تبدیل میکند و پاسخی ارائه میدهد. اما در دنیای واقعی، کاربری که میپرسد «چرا درآمد ماه گذشته کاهش یافت؟» به یک جریان کاری بسیار پیچیدهتر نیاز دارد. یک عامل مفید نمیتواند صرفاً حدس بزند؛ او باید منبع داده صحیح را بیابد، ساختار جداول را بازرسی کند، تعاریف تجاری را رمزگشایی نماید و Joinها را بهصورت ایمن اجرا کند.
این فرآیند سپس نیازمند مقایسهی بازههای زمانی، شناسایی نقاط پرت (Outliers)، ایجاد جداول میانی و ترسیم یک نمودار است. این توالی — شامل پرسش، بازرسی، شفافسازی، پرسوجو، بررسی، حفاری عمیق (Drill down)، مقایسه، توضیح، ذخیره و بازبینی — یک مسئلهی جریان کاری است، نه یک مسئلهی پرسش و پاسخ. هدف این است که تحلیل داده قابل کنترل، قابل بازرسی و قابل استفاده مجدد باشد، نه اینکه صرفاً دیتابیسها به «شریکهای چت» بهتری تبدیل شوند.
معماری اعتماد
این پلتفرم تجربهی «جعبه سیاه» چتباتها را با یک چرخه حیات شفاف از وظایف جایگزین کرده است. هر تحلیل به عنوان یک «اجرا» (Run) با وضعیتی پایدار تعریف میشود. این ویژگی به کاربران اجازه میدهد دقیقاً بازرسی کنند که عامل به کدام جداول دسترسی داشته و کدام فیلدها را انتخاب کرده است.
اجزای کلیدی فنی عبارتاند از:
- میز کار وب (Web workbench): رابطی برای اکتشاف تعاملی کارهای داده.
- رابط کاربر ترمینالی (TUI): طراحیشده برای گردش کارهای ترمینال و سرورهای دوردست.
- درگاه داده (Data Gateway): ایجاد یک مرز امنیتی سخت بین LLM و منبع داده.
- پشتیبانی از مدلهای متنوع: قابلیت استفاده از هر مدلی که با پروتکل OpenAI سازگار باشد.
- فضای کاری نظارتی (Governed Workspace): محیطی یکپارچه برای منابع داده، دانش، ابزارها و زمان اجرای عامل.
بررسی عمیق: امنیت و مرز زمان اجرا
یک تفاوت بنیادین میان یک «عامل کدنویسی» (Coding Agent) و یک «عامل داده» (Data Agent) وجود دارد. یک عامل کدنویسی در مرزهایی متشکل از فایلها، تستها، Diffها، Commitها و Pull Requestها فعالیت میکند. اما یک عامل داده، با منابع داده حساس، طرحوارهها، اعتبارنامهها، مجوزها و نتایج تجاری سر و کار دارد. این موارد نیازمند یک مرز زمان اجرای (Runtime Boundary) متفاوت هستند تا از تغییر ناخواسته دادهها یا نشت اعتبارنامهها جلوگیری شود.
در DataFoundry، مدل «زمینه نظارتی» (Governed Context) دریافت میکند، اما اجرای عملیات کاملاً مجزاست. درگاه داده تضمین میکند که عامل نتواند پروتکلهای امنیتی را دور بزند. با استفاده از اجرای «فقط خواندنی» به عنوان پیشفرض، سیستم تضمین میکند که هوش مصنوعی نتواند بهطور تصادفی یا عمدی دادههای عملیاتی را تغییر دهد. این جداسازی (Decoupling) به این معناست که عامل میتواند بهطور بهینه کار کند، در حالی که مرز دادهها راسخ در دستان مدیریت سیستم باقی میماند.
اتصال گسترده و حسابرسی
این ابزار در بدو راه از ۲۸ نوع منبع داده پشتیبانی میکند. این لیست شامل استکهای رایج زیر است:
- دیتابیسهای رابطهای: PostgreSQL و MySQL.
- انبار دادههای ابری: Snowflake، BigQuery و ClickHouse.
- NoSQL و کش: MongoDB، Redis و Elasticsearch.
- فایلهای تخت: CSV و Excel.
حتی یک دموی داخلی DuckDB برای تستهای محلی بدون نیاز به راهاندازی دیتابیس خارجی گنجانده شده است.
برخلاف چتباتها که در آنها نمودارها یا جداول مفید در تاریخچه گفتگو محو میشوند، DataFoundry با این خروجیها به عنوان «داراییهای دائمی» (Permanent Assets) برخورد میکند. در اینجا زبان طبیعی تنها به عنوان نقطه ورود در نظر گرفته میشود. خروجی واقعی — خواه یک جدول باشد، یک گزارش یا یک نمودار — به یک اثر (Artifact) قابل استفاده مجدد تبدیل میشود. هر اجرا یک ردپای حسابرسی (Audit Trail) بر جای میگذارد که شامل موارد زیر است:
- پرسوجوهای SQL و جریانهای رویداد.
- مراحل بازرسی طرحواره (Schema inspection).
- خروجیهای جدولی و خروجیهای فایلی.
- تاریخچه وظایف قابل بازپخش.
این ساختار باعث میشود تحلیلها «بازپخشپذیر» باشند؛ به این معنی که یک تحلیلگر انسانی میتواند زنجیره شواهد را قبل از اعتماد به نتیجه نهایی تأیید کند. این امر تجربه را از «هوش مصنوعی اینطور گفت» به وظیفهای تبدیل میکند که میتوان آن را بازبینی، دیباگ، ادامه داد و به اشتراک گذاشت.
تکامل به سمت گراف داده (DataGraph)
پروژه اکنون در حال حرکت به سمت مفهومی به نام گراف داده (DataGraph) است؛ یک لایه معنایی (Semantic Layer) که با استفاده از میز کار تکامل مییابد. بخش بزرگی از ارزشمندترین زمینههای داده هرگز بهصورت مکتوب در نمیآیند؛ بلکه در عادتهای تحلیلگران، قراردادهای نامگذاری، الگوهای قدیمی SQL و منطق داشبوردها نهفتهاند.
به جای اینکه هر پرسوجو از صفر شروع شود، DataGraph به میز کار اجازه میدهد تا پس از هر بار تحلیل، کسبوکار را بهتر بشناسد. هدف این لایه ذخیرهسازی موارد زیر است:
- روابط: اتصالات بین جداول و معنای فیلدها.
- منطق تجاری: تعاریف معیارها و سؤالات رایج تجاری.
- الگوها: الگوهای مفید پرسوجو و زنجیرههای شواهدی.
- حاکمیت: تبار دادهها (Lineage) و نکات مربوط به سیاستهای دسترسی.
این رویکرد یک مشکل اساسی را حل میکند: عاملهای هوش مصنوعی اغلب به دادههای زیادی دسترسی دارند اما درک نمیکنند که این دادهها چگونه به هم متصل هستند. با ثبت «دانش جمعی» (Tribal Knowledge) یک تیم، میز کار به مرور زمان هوشمندتر میشود.
پیادهسازی محلی و بازخورد
توسعهدهندگان میتوانند با کلون کردن مخزن گیتهاب پروژه در مسیر https://github.com/datagallery-lab/datafoundry.git آن را آزمایش کنند. روند راهاندازی شامل مراحل زیر است:
- اجرای دستور
npm install. - پیکربندی فایل
.envوapps/web/.env.localبر اساس نمونههای ارائه شده. - اجرای دستور
npm run dev.
پس از آن، رابط وب در آدرس http://127.0.0.1:3000/data-tasks در دسترس خواهد بود. یک جریان تست پیشنهادی این است که از عامل بخواهید: «جداول این منبع داده را به من نشان بده و فیلدهای اصلی هر کدام را توضیح بده»؛ این درخواست باعث فعال شدن زنجیره کامل میشود: بازرسی طرحواره $\rightleftharpoons$ SQL خواندنی $\rightleftharpoons$ حسابرسی SQL $\rightleftharpoons$ خروجی جدول $\rightleftharpoons$ تاریخچه اجرای قابل بازپخش.
تیم پروژه بهطور فعال بهدنبال بازخورد از کسانی است که در حال ساخت عاملهای BI، سیستمهای Text-to-SQL، ابزارهای حاکمیت داده، لایههای معنایی یا ابزارهای داخلی هوش مصنوعی هستند. بهطور خاص، تیم بهدنبال ورودی در زمینههای زیر است:
- کدام منابع داده باید در اولویت بهبودهای بعدی باشند.
- جریانهای کاری تحلیل در دنیای واقعی چه تفاوتی با مدل فعلی دارند.
- چه ویژگیهای خاصی برای حسابرسی یا بازپخش کم است.
- گراف داده (DataGraph) چه مواردی را باید ذخیره کند.
- در کدام بخشها تجربه کاربری (UX) هنوز بیش از حد شبیه چتباتهای سنتی است.
این چرخش از «چت» به «میز کار»، پروفایل ریسک عاملهای داده را بهطور بنیادین تغییر میدهد. با جداسازی «قصد» (Intent) عامل از «مرز اجرای» سیستم، DataFoundry اجازه میدهد عامل بدون دریافت «کلیدهای خزانه»، بهطور بهینه کار کند. برای توسعهدهندگان و تیمهای BI، این به معنای آن است که هوش مصنوعی دیگر فقط راهی برای تولید یک پرسوجوی سریع نیست، بلکه ابزاری برای ساخت یک مخزن داده نظارتشده و قابل حسابرسی است که در آن مسیر رسیدن به پاسخ، به اندازه خود پاسخ اهمیت دارد.
گام بعدی شما
- مخزن گیتهاب را کلون کرده و با یک دیتابیس محلی (مانند DuckDB) تست کنید.
- جریان کاری «بازرسی ساختار $\rightleftharpoons$ SQL خواندنی $\rightleftharpoons$ حسابرسی» را با یک سؤال پیچیده تجاری به چالش بکشید.
- اگر روی سیستمهای Text-to-SQL کار میکنید، معماری Data Gateway را برای مدیریت دسترسیها بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو