اگر امروز برای خرید یک لپتاپ یا حافظه خارجی بودجهای در نظر گرفتهاید، احتمالاً با قیمتی بسیار بالاتر از دو سال پیش مواجه میشوید. این گرانی اتفاقی نیست، بلکه نتیجه مستقیم سیطره مدلهای ChatGPT و Claude بر منابع سختافزاری جهان است. این ابزارها به دلیل اشتهای بیش از حد به منابع، هزینههای سختافزاری را به شدت بالا بردهاند.
طبق گزارشهای منتشر شده تا ۱۶ ژوئیه ۲۰۲۶، غولهای فناوری حدود ۷۰ درصد از کل حافظههای پیشرفته دنیا را برای تغذیه مراکز داده خود میبلعند. این حجم خرید خیرهکننده، یک کمبود سیستماتیک ایجاد کرده که مستقیماً جیب مصرفکنندگان عادی را هدف قرار داده و دسترسی به قطعات حیاتی را دشوار کرده است.
این بحران سختافزاری در واقع نمودی فیزیکی از یک شکست مهندسی عمیق است. برخلاف موجهای قبلی فناوری مثل استریمینگ یا گوشیهای هوشمند که بهطور بهینه مقیاس گرفتند و با رشد تعداد کاربران، بهرهوری افزایش یافت، هوش مصنوعی زاینده (Generative AI) — شبیه به ماشین عظیمی است که برای تولید یک تکه نان، کل گندمزار را میسوزاند. این فناوری منابع را با سرعتی مصرف میکند که توان خرید (Affordability) رایانههای پایه را برای همه به خطر انداخته است. این ناکارآمدی بخشی از یک الگوی بیثباتی گستردهتر است؛ همانطور که در پوشش پیشین ما درباره بحران رضایت کاربران و دادههای آموزشی برای این مدلها اشاره کردیم، صنعت اکنون با یک تضاد بنیادی میان رشد سریع و پایداری منابع روبروست.
زمینهٔ اتلاف محاسباتی
برای درک تفاوت این وضعیت و اینکه چرا هوش مصنوعی با سایر فناوریها متفاوت است، باید به تحولات بزرگ قبلی نگاه کنیم. ظهور گوشیهای هوشمند نیاز به تولید میلیاردها دستگاه داشت و همچنان روزانه حجم عظیمی از دادهها را جابهجا میکند. استریمینگ ویدیو و موسیقی در حال حاضر بخش بزرگی از ترابایتهای ترافیک اینترنت در سراسر جهان را به خود اختصاص داده است. حتی اینترنت اشیا (IoT) نیز میلیاردها دستگاه خانگی را به شبکه جهانی اضافه کرده است.
علاوه بر این، صنایع کاملی عملیات خود را به نرمافزارهای ابری (Cloud) منتقل کردهاند. اگرچه این نرمافزارها در مراکز داده میزبانی میشوند، اما هرگز باعث جهشهای فاجعهبار در مصرف برق یا کمبودهای شدید قطعات نشدند. تفاوت اصلی و بنیادین در معماری نرمافزاری است که اکنون در حال استقرار است و برخلاف سیستمهای ابری سنتی، نیازی به منابعی فراتر از حد تصور دارد.
فشار بر زیرساختها
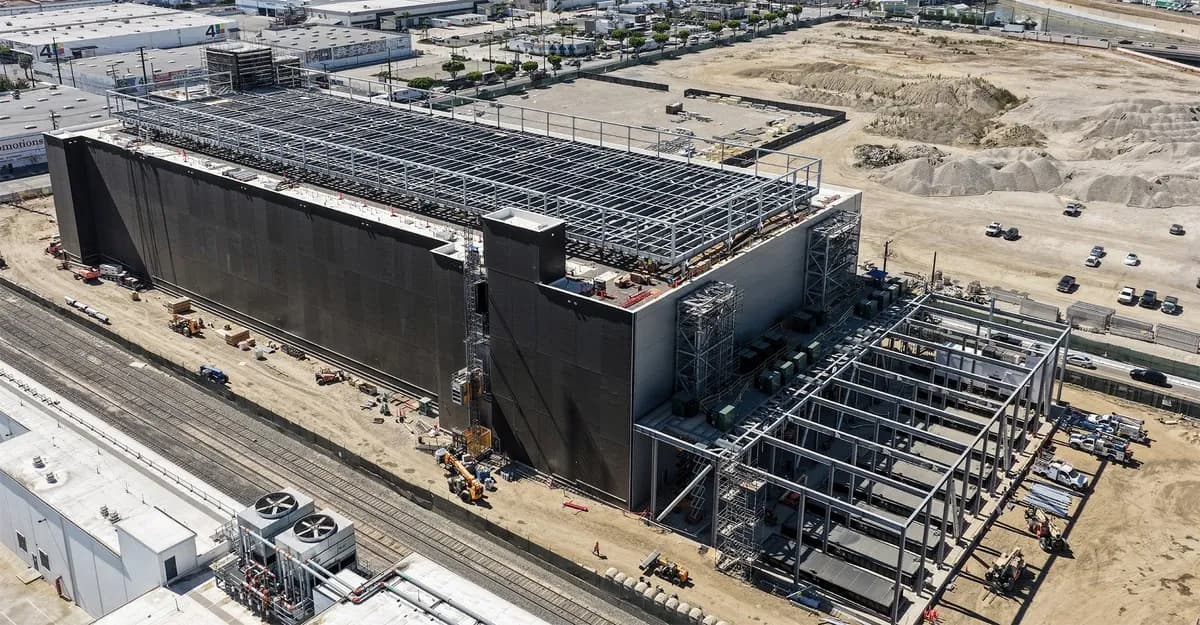
این فشار در ردپای (Footprint) فیزیکی صنعت کاملاً مشهود است. شرکتهای فناوری با سرعتی باورنکردنی در حال گسترش مراکز داده خود هستند. بر اساس برنامهریزیهای فعلی، آنها قصد دارند ظرفیت کل مراکز داده در ایالات متحده را طی چند سال آینده تا ۸ برابر افزایش دهند تا بتوانند تقاضای پردازشی مدلهای خود را پاسخ دهند.
نیازهای انرژی برای این گسترش، بیسابقه و تکاندهنده است. تقاضا برای برق در این سایتها در حال حاضر چنان زیاد شده است که برخی شرکتها برای تأمین انرژی مورد نیاز، موتورهای جت را بازسازی کرده و برای تولید برق به کار گرفتهاند. این سطح از ولع برای منابع، تمام استانداردهای انقلابهای دیجیتال پیشین را کنار زده و نشان میدهد که ما با مقیاسی از مصرف روبرو هستیم که بسیار فراتر از نیازهای هر فناوری قبلی است. این فشار بر زیرساختها تنها به برق محدود نمیشود و هزینههای پنهان زیستمحیطی و مصرف آب در مراکز داده ابعاد دیگری از این بحران منابع را آشکار میکند.
تلهٔ قوانین مقیاسپذیری
بیشتر نرمافزارها بهصورت لوگاریتمی مقیاس میگیرند؛ به این معنا که هزینه افزودن هر کاربر جدید با گذشت زمان کم میشود. سرمایهگذاران جسورانه (Venture Capitalists) هنگام ارزیابی استارتآپها دقیقاً به دنبال همین کارایی هستند؛ آنها میخواهند ببینند که هزینه جذب هر کاربر جدید کاهش مییابد تا شرکت بتواند میلیونها کاربر را پشتیبانی کرده و سود خود را افزایش دهد. این کار معمولاً از طریق مهندسی دقیق سیستمهایی که درخواستها را مدیریت میکنند — مثل نحوه درخواست یک تاکسی در Uber یا پست کردن یک عکس — محقق میشود تا با رشد سیستم، کارایی آن نیز بیشتر شود.
اما هوش مصنوعی زاینده این مسیر را طی نمیکند. به نقل از گزارش The Atlantic، مدلهای زبانی بزرگ (LLM) بهصورت کوادراتیک یا درجهدوم مقیاس میگیرند: یعنی با افزایش ورودی، زمان و حافظه مورد نیاز با سرعتی بسیار بیشتر (به توان دو) افزایش مییابد. در دنیای علوم کامپیوتر، هر دانشجویی میداند که مقیاسدهی درجهدوم «بسیار بد» و ناکارآمد است.

رهبران صنعت رویکرد «بهزور» (Brute-force) را برای پیشرفت پذیرفتهاند. این تصمیم بر اساس باور به قوانین مقیاسپذیری (Scaling Laws) است؛ این ایده که هر مشکلی را میتوان صرفاً با بزرگتر کردن مدل حل کرد. برای مثال، سام آلتمن، مدیرعامل OpenAI، در سپتامبر در وبلاگ خود نوشت که شاید ۱۰ گیگاوات محاسبات (Compute)، کلید یافتن راهی برای درمان سرطان باشد.

با این حال، این رویکرد بازدهی نزولی دارد. هرچه یک مدل هوش مصنوعی بزرگتر شود، میزان بهبودی آن با هر پارامتر اضافهشده کمتر میشود. در نتیجه، مدلها باید با سرعتی حتی بیشتر بزرگ شوند تا پیشرفت آنها ثابت بماند و متوقف نشود. تخمینهای مستقل نشان میدهد حجم مدلها از ۱۷۵ میلیارد پارامتر در سال ۲۰۲۰ به بیش از ۱ تریلیون پارامتر در امروز رسیده است، هرچند اندازه واقعی مدلهایی که Claude و ChatGPT را فعال میکنند، به صورت محرمانه نگه داشته شده است.
خسارات اقتصادی و سختافزاری
این اشتهای سیریناپذیر برای محاسبات، اثرات موجگونهای در بازار الکترونیک ایجاد کرده و خرید تجهیزات را برای کاربر عادی گران کرده است. حافظهها بهجای بازار مصرف، به سمت مراکز داده سرازیر میشوند که با سرعتی باورنکردنی در حال گسترش هستند. این وضعیت منجر به افزایشهای قیمتی مشخص و قابلاندازهگیری شده است:
- هزینه سختدیسکها: قیمت درایوهای سطح حرفهای (Reporting-grade) از ۳۵۰ دلار در دو سال پیش به ۸۰۰ دلار در دو هفته اخیر رسیده و بسیاری از این مدلها اکنون موجود نیستند.
- قیمت لپتاپها: قیمت برخی از لپتاپها تا ۵۰ درصد افزایش یافته است.
- سختافزارهای پایه: رایانههای ارزانقیمت شدیدترین ضربه را خوردند. پیشبینیها حاکی از آن است که رایانههای Entry-level ممکن است تا سال ۲۰۲۸ کاملاً از بازار حذف شوند.
- تقاضای برق: فشار الکتریکی در سایتهای مرکز داده چنان شدید است که استفاده از موتورهای جت برای تأمین برق به یک راهکار عملی تبدیل شده است.
نرخ شکست در سازمانها
این ناکارآمدی فقط یک مشکل سختافزاری نیست، بلکه یک قاتل برای تولیدات تجاری است. دادههای S&P Global Market Intelligence نشان میدهد ۴۲ درصد از شرکتها در سال ۲۰۲۵ پیش از رسیدن به مرحله تولید، پروژههای هوش مصنوعی خود را رها کردهاند (در حالی که این رقم سال قبل ۱۷ درصد بود). علاوه بر این، گزارش RAND Corporation تخمین میزند بیش از ۸۰ درصد پروژههای هوش مصنوعی شکست میخورند؛ رقمی که تقریباً دو برابر نرخ شکست پروژههای IT سنتی و معمول است.
جستوجو برای کارایی
برخی پژوهشگران سعی میکنند با بازگشت به اهداف اولیه هوش مصنوعی، یعنی شبیهسازی فرآیندهای ذهنی انسان، این چرخه مخرب را بشکنند. در گذشته، محققان عادتهای ذهنی خود را مشاهده و سپس آن قواعد را در قالب کد پیاده میکردند. این تلاش برای توصیف قوانین فکر انسان در نهایت کنار گذاشته شد زیرا این فرآیند بسیار دشوار است که بتوان آن را به طور دقیق بیان کرد.
اما این متد قدیمی مزیت بزرگی داشت: مصرف بسیار کمتر منابع و داده. مدلهای امروزی در عوض، میلیونها مثال را برای تقلید به کامپیوتر میدهند. این کار باعث میشود در تولید زبان و موسیقی بهتر عمل کنند چون مواد اولیه بیشتری برای الگوبرداری دارند، اما این روش بهشدت اسرافکار است.
الکسیا جولیکور-مارتینو از مایکروسافت یک «مدل بازگشتی کوچک» توسعه داد که برای حل مسائل منطقی در زمینههایی مانند زیستشناسی و مهندسی برق طراحی شده است. کار او که جایزه ۵۰ هزار دلاری برد، نشان میدهد اتکا به مدلهای بنیادی عظیم که توسط شرکتهای بزرگ با صرف میلیونها دلار آموزش دیدهاند، یک «تله» است. او در پاسخ به سوال درباره رویکرد بهزورِ صنعت، آن را «کمی دیوانهوار» خواند و تأکید کرد که «در یک نقطه باید یاد بگیرید کمی بهینهتر باشید».
با این حال، صنعت همچنان به رویکرد متورم پایبند است. ایلیا سوتسکیور، همبنیانگذار و دانشمند ارشد سابق OpenAI، در نوامبر اشاره کرد که روش بهزور، «راهی کمریسک برای سرمایهگذاری منابع» است. او استدلال کرد که سرمایهگذاری روی پژوهشی که محصول فعلی (که ارزشهای تریلیون دلاری ایجاد کرده) را بازطراحی کند، بسیار سختتر است. این هزینه بالا و ناکارآمدی، سودآوری واقعی این شرکتها را به یک علامت سؤال بزرگ تبدیل کرده است.
دیوار قانون مور
بحران با این واقعیت تشدید میشود که سختافزارها دیگر با سرعت سابق پیشرفت نمیکنند. از دهه ۱۹۵۰، تولیدکنندگان از قانون مور پیروی میکردند و تراشهها را بهطور مداوم سریعتر، کوچکتر و ارزانتر میساختند. اما در سالهای اخیر، اجزا چنان کوچک شدهاند که تولیدکنندگان به محدودیتهای فیزیکی در سطح مولکولی رسیدهاند و این امر پیشرفت را بهطور قابلتوجهی کند کرده است.
بهجای کوچک کردن قطعات، تولیدکنندگان اکنون سختافزارهای جدیدی را توسعه میدهند که بهطور خاص برای هوش مصنوعی طراحی شدهاند. اگرچه این کار بهبودهای تدریجی ایجاد میکند، اما نمیتواند با منحنی نمایی تقاضای رو به رشد هوش مصنوعی رقابت کند.
این وضعیت یک حلقه خطرناک ایجاد میکند: هوش مصنوعی ناکارآمد در نسخههای ۲۰۲۴ و ۲۰۲۵ Windows و MacOS ادغام شده است؛ به این معنی که برای اجرای یک کامپیوتر شخصی ساده، حالا به قدرت پردازشی بیشتری نیاز داریم. گوشیهای هوشمند با سختافزار ارتقایافته برای ویژگیهای AI فروخته میشوند و برنامههایی مثل Adobe Photoshop و Microsoft Word اکنون برای عملکرد درست، به سیستمهای قدرتمندتری نیاز دارند.
افسانه ابرهوش
در نهایت، ناکارآمدی برای کسانی که باور دارند در حال بازسازی خودِ «هوش» هستند، اهمیت چندانی ندارد. در سیلیکون ولی یک باور تقریباً مذهبی وجود دارد که چیزی شبیه به ذهن از دل مدلهای زبانی بزرگ پدید میآید؛ با وجود اینکه اینها فقط نرمافزارهای آماری برای تولید زبان هستند که فاقد عقل سلیم بوده و حتی نمیتوانند حقایق پایه را به یاد آورند.
حتی یان لکون، یکی از «پدران» هوش مصنوعی، اخیراً به نیویورک تایمز گفت: «LLMها مسیری به سوی ابرهوش یا حتی هوش در سطح انسان نیستند». با این حال، جذابیت این افسانه چنان قوی است که مهندسان باور دارند هیچچیز — حتی اصول پایه علوم کامپیوتر مثل کارایی و بهینهسازی — نباید سد راه آنها شود.
این مسیر ثابت میکند که صنعت «جذابیت افسانهای» ابرهوش را بر اصل مهندسی و کارایی ترجیح داده است. با هر معیار اقتصادی و مهندسی، این شاید بدترین فناوری باشد که تاکنون در مقیاس جهانی به کار گرفته شده است.
پرسش حیاتی برای دو سال آینده این است که آیا صنعت میتواند به سمت شبیهسازی بهینه از فرآیندهای ذهنی انسان تغییر مسیر دهد یا خیر. شرکتهای چتبات از ناکارآمدی خود آگاهاند؛ داریو آمودی، مدیرعامل Anthropic، از «ضریبهای محاسباتی» (Compute Multipliers) یاد کرده است، اما این پیشرفتها بهطور مبهم توصیف شدهاند و هیچ مدرکی دال بر حل مشکل مقیاسدهی درجهدوم یا انفجار اندازه مدلها وجود ندارد. شرکت Anthropic در پاسخ به درخواست برای جزئیات بیشتر، از پاسخ رسمی خودداری کرد.
گام بعدی شما
- اگر در حال خرید تجهیزات IT هستید، به جای تکیه بر مدلهای عمومی، به دنبال سختافزارهای بهینه برای مدل زبانی کوچک (SLM) باشید.
- در پروژههای سازمانی، نرخ شکست ۸۰ درصدی را جدی بگیرید و پیش از مقیاسدهی، بر روی «بهینه رویی» (Inference Optimization) تمرکز کنید.
- چشم به تحولات در معماریهای جایگزین LLM داشته باشید که به جای تقلید آماری، بر منطق ساختاری تمرکز میکنند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو