اگر امروز برای اشتراکهای ابری هزینه میکنید، وسوسه نشوید که با خرید یک سرور محلی، این هزینهها را به صفر برسانید. طبق گزارشی که در ۱۶ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، بازگشت سرمایه برای سختافزارهای محلی اغلب بیش از چهار سال طول میکشد. این تحلیل زمانی است که هزینه سختافزار با اشتراکهای ماهانه ابری مقایسه شود.
یک سرور مناسب برای توسعه هوش مصنوعی بین ۸۰,۰۰۰ تا ۲۰۰,۰۰۰ رئال (برزیل) هزینه دارد، در حالی که ابزارهایی مثل Copilot، Claude Code یا Cursor ماهانه بین ۲۰ تا ۱۰۰ دلار برای هر کاربر هزینه دارند. برای اکثر تیمهای کوچک، محاسبات مربوط به میزبانی محلی بهسادگی توجیهپذیر نیست. بسیاری از برنامهنویسان بهدلیل افزایش هزینههای ابری، به فکر بازگرداندن استنتاج (Inference) — که مثل لحظه آشپزی واقعی است، نه دوره آموزش آشپز — به سختافزارهای محلی هستند.
اما این تصمیم معمولاً بار عملیاتی پنهان مدیریت درایورها، کانتینرها و امنیت شبکه را نادیده میگیرد. همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، کنترل کامل روی سختافزار لزوماً به معنای بهرهوری بیشتر نیست. در حالی که ارائهدهندگان ابری مدلها را بهطور نامحسوس و بدون وقفه بهروز میکنند، سرورهای محلی تیم را به سختافزاری خاص محدود میکنند که احتمالاً طی ۱۸ تا ۲۴ ماه آینده با کمبود حافظه ویدیویی (VRAM) مواجه میشود.
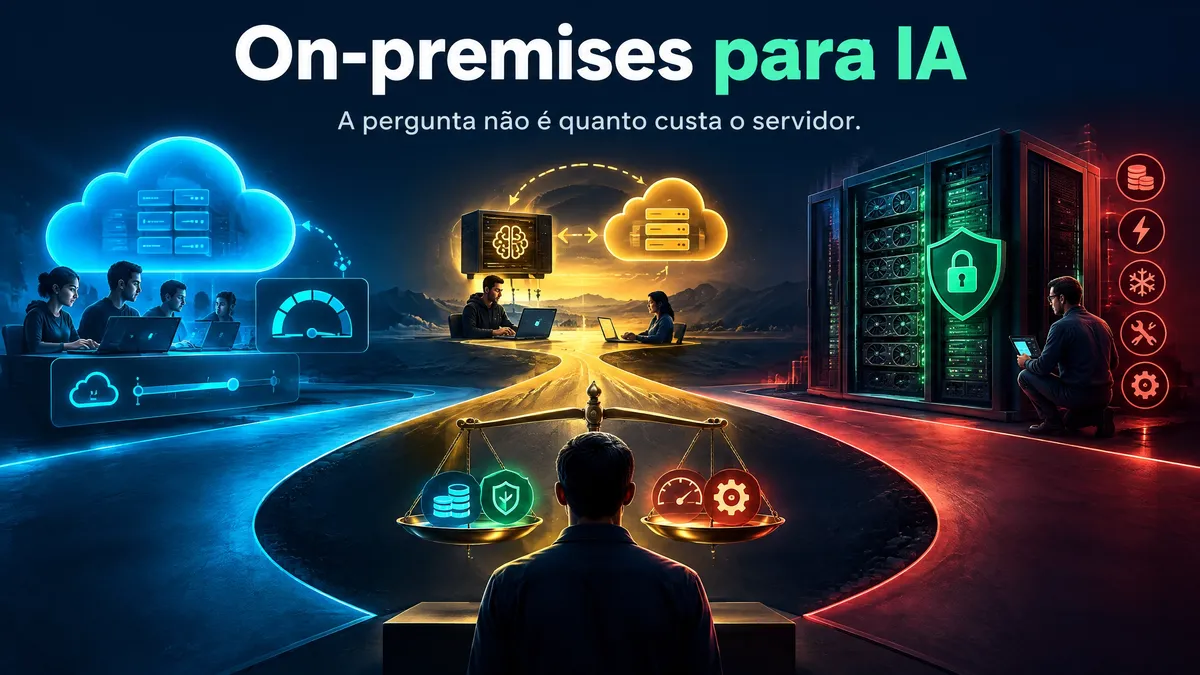
هزینه پنهان مالکیت
اجرای سرور محلی یعنی تیم شما باید نقش اپراتور GPU را ایفا کند. این شامل مدیریت زیرساختهای پایه و دستوپنجه نرم کردن با کهنگی سریع سختافزار است. برخلاف فضای ابری که مدلها را بدون اطلاع کاربر جابهجا یا ارتقا میدهد، سرور محلی ایستا است. اگر VRAM به گلوگاه تبدیل شود، عملکرد مدل افت میکند یا اصلاً بارگذاری نمیشود و تیم با بنبست فنی مواجه میشود.
به نقل از نویسنده این گزارش، برای تیمهایی با مصرف متوسط، استفاده از سیستمهای کشینگ (Caching) ابری که بهخوبی پیادهسازی شده باشند، میتواند هزینه توکن (Token) — که مثل برشهای کوچک یک کیک است و مدل متن را تکهتکه میخورد — را به سطحی برساند که حتی در برابر جداول محاسباتی سختافزار محلی نیز توجیهپذیر نباشد. در یک بازه ۲ تا ۳ ساله، مدل اشتراکی و API سادهترین و ارزانترین گزینه برای کسانی است که حوصله و تخصص لازم برای مدیریت زیرساخت را ندارند.
با این حال، وقتی الزامات غیرمالی خاصی وارد میدان میشوند، گفتگو تغییر میکند:
زمان برتری زیرساختهای محلی
در سه حالت خاص، سختافزار محلی برنده است:
- قوانین و مقررات: وقتی قراردادها، قوانین LGPD یا قوانین سختگیرانه مشتریان اجازه خروج کد از شبکه داخلی را نمیدهند، میزبانی محلی یک ضرورت قانونی و اجباری است، نه یک انتخاب مالی. در اینجا موضوع انطباق با قوانین است، نه هزینه.
- حجم مصرف بالا و ثابت: اگر مصرف ماهانه شما در حد دهها میلیون توکن با نوسان کم باشد، استهلاک سختافزار رقابتی میشود. وقتی استفاده از مدلها مستمر و پیشبینیپذیر باشد، سرمایهگذاری اولیه بازگشت سرمایه سریعتری خواهد داشت.
- ایستگاههای کاری ترکیبی: تجهیز برنامهنویسان به تراشههای Apple Silicon با رم ۶۴ یا ۱۲۸ گیگابایت برای اجرای مدلهای ۸ تا ۳۲ میلیارد پارامتری از طریق Ollama یا vLLM برای کارهای سبک و تکمیل خودکار کد (Autocomplete)، در حالی که مدلهای سنگین در ابر باقی بمانند. این استراتژی درامهای عملیاتی را کاهش میدهد.
مقیاسپذیری برای تیمهای بزرگتر
برای تیمهای بزرگ، ترکیب vLLM با یک پروکسی سازگار با OpenAI مثل LiteLLM میتواند هزینههای کل را تقریباً ۴۰٪ نسبت به APIهای کششده کاهش دهد. این مدل استفاده مشترک از GPU اجازه میدهد منابع سختافزاری بهطور بهتری در سراسر سازمان توزیع شوند. این رویکرد در کنار بهینهسازیهای لایهای، مشابه آن چیزی است که در تلاقی RAG و MCP برای ساخت پشتههای واحد مشاهده میکنیم تا بهرهوری سیستم به حداکثر برسد.
اما یک نکته حیاتی وجود دارد: استفاده از مدلهای محلی ضعیفتر، اغلب زمان عیبیابی (Debugging) را افزایش میدهد. نویسنده هشدار میدهد که صرفهجویی در هزینه توکنها با صرفهجویی در ساعتهای گرانبهای مهندسی یکی نیست. افت کیفیت مدل میتواند منجر به کاهش خالص بهرهوری کل تیم شود.
این تغییر دیدگاه نشان میدهد که هدف نباید صفر کردن صورتحساب ابری باشد، بلکه باید بارهای کاری را بهطور استراتژیک تخصیص داد. کارهای حساس به حریم خصوصی یا با حجم بسیار بالا باید در محیط داخلی (On-premise) باشند، در حالی که کارهای نیازمند استدلال پیچیده باید در مدلهای تراز اول ابری باقی بمانند.
در نهایت، تصمیم برای خرید سرور باید بر اساس تأخیر (Latency)، پیشبینیپذیری و محرمانگی باشد، نه صرفاً میل به حذف هزینههای ماهانه. کسانی که هوش مصنوعی محلی را یک ابزار استراتژیک میبینند و نه یک معجزه برای کاهش هزینه، از تبدیل شدن تیم توسعهشان به یک تیم زیرساخت جلوگیری میکنند.
برای تعیین نقطه شکست اقتصادی خود، میتوانید مقاله «اقتصاد استنتاج عاملهای کدنویسی سازمانی» (arXiv:2607.13080) را بررسی کنید تا توان عملیاتی توکنهای خود را با استهلاک سختافزار بسنجید. این پژوهش، در کنار مطالعات روی معماریهای PagedAttention و vLLM، مبنای فنی لازم برای تصمیمگیری درباره زمان مناسب برای بازگشت به زیرساخت محلی را فراهم میکند.
گام بعدی شما
- اگر حجم توکنهای ماهانه شما زیر ۱۰ میلیون است، روی بهینهسازی پرامپتها و کشینگ ابری تمرکز کنید.
- برای کارهای حساس، مدلهای کوچک (SLM) را روی لپتاپهای با رم بالا و ابزار Ollama تست کنید.
- پیش از خرید سرور، هزینه ساعتی مهندسی تیم خود را در برابر هزینه توکنها مقایسه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو