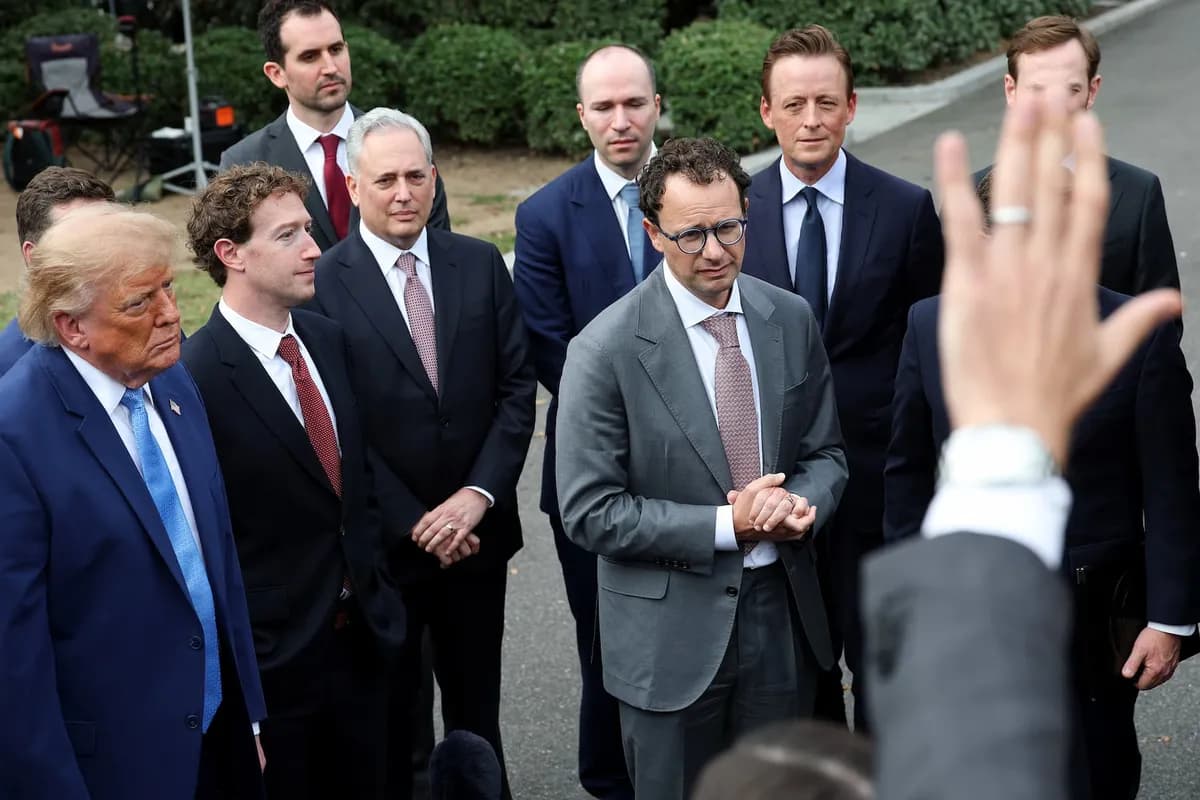
تصور کنید مسئولیت ایمنی یک پل عظیم را به کسی بسپارید که خودش آن را ساخته، خودش بازرسی میکند و تنها خودش تصمیم میگیرد که آیا عبور از آن امن است یا خیر؛ آن هم بدون اینکه دادههای فنی خود را در اختیار عموم قرار دهد. این دقیقاً همان وضعیتی است که طبق گزارش مؤسسه بروکینگز (Brookings Institution)، اکنون با پیمان «اخلاقی» کاخ سفید برای مدیریت ابرهوش مصنوعی شکل گرفته است.
در ۲۹ سپتامبر ۲۰۲۶، دونالد ترامپ و قدرتمندترین مدیران اجرایی صنعت AI در مراسمی در کاخ سفید برای اعلام آغاز یک «عصر طلایی جدید» گرد هم آمدند. در این رویداد، صنعت پذیرفت که ریسکهای پیشرفتهترین مدلهای خود را بهصورت داوطلبانه مدیریت و نظارت کند.
این توافق در حالی رخ میدهد که دولت آمریکا در حال تغییر ادبیات رسمی خود است. یک دستور اجرایی جدید صادر شده که آژانسهای فدرال را موظف میکند عبارت «هوش مصنوعی» را با «ابرهوش» (Super Intelligence) جایگزین کنند. اما نکته کلیدی اینجاست: در حالی که این دستور برای آژانسهای دولتی الزامآور است، پیمان همراه آن که با شرکتهای صنعتی امضا شده، هرگونه جنبه قانونی ندارد. پرزیدنت ترامپ این پیمان را به عنوان «شکلی از حفاظت» در برابر تهدیدات احتمالی توصیف کرد و آن را به یک «قانون اساسی» تشبیه کرد که توسط «بزرگترین افراد جهان» امضا شده است. با این حال، در عمل، این سند بیشتر شبیه به مجموعهای از وعدههای داوطلبانه است تا یک چارچوب رگولاتوری و نظارتی. این رویکرد در ادامه توافق «اخلاقی» ترامپ با غولهای فناوری برای مهار عاملهای هوش مصنوعی صورت میگیرد که تلاش میکند بدون ایجاد قوانین سختگیرانه، کنترلهایی را بر رفتار مدلها اعمال کند.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر حسن نیت شرکتهای تجاری معمولاً به نتایج ناپایداری ختم میشود. گزارش مؤسسه بروکینگز تأکید میکند که این پیمان عملاً نظارت بر ایمنی را به دست کسانی سپرده که بیشترین نفع مالی را در عرضه سریع مدلها دارند.
سازوکار نظارت داخلی
این پیمان توسط گروهی از تایتانهای صنعت امضا شد: ساندار پیچای (گوگل)، داریو آمودئی (آنتروپیک)، مارک زاکربرگ (متا)، گرگ بروکمن (OpenAI)، ایلان ماسک (xAI) و جنسن هوانگ (انویدیا). این توافق بر چهار ستون اصلی استوار است:
- کنترلهای داخلی: پیادهسازی کنترلهای داخلی سختگیرانه برای پایش توانمندیها و همراستاسازی (Alignment) — شبیه تنظیم کردن قطبنمای مدل برای اینکه همیشه در مسیر اهداف انسانی حرکت کند — مدلهای هر شرکت.
- پایش داخلی: توانمندسازی یک تیم داخلی برای اطمینان از اینکه تمامی کنترلها، سیستمهای پایش و شناسایی خطا دقیقاً طبق برنامه عمل میکنند.
- حسابرسی خارجی: مشارکت با حسابرسان مستقل خارجی برای ارزیابی اینکه آیا کنترلها و سیستمهای شناسایی بهدرستی عمل میکنند یا خیر.
- نظارت هیئتمدیره: تعیین یک کمیته مستقل در هیئتمدیره برای نظارت بر کل این فرآیند.
تحلیل بروکینگز یک نقص حیاتی را افشا میکند: شرکتها در اینجا هم بازیکن هستند و هم داور. این پیمان به شرکتها اجازه میدهد تا خودشان کنترلها را طراحی کنند، ارزیابان خود را انتخاب کنند و در نهایت تصمیم بگیرند که آیا آن رویهها رعایت شدهاند یا خیر. در این سند مشخص نشده است که چه کسی هزینه حسابرسان را پرداخت میکند، آنها گزارشهای خود را به چه کسی ارائه میدهند، یا اینکه آیا اصلاً قدرت مداخله و توقف عرضه یک مدل مضر را دارند یا خیر. علاوه بر این، هیچ الزامی وجود ندارد که یافتههای حسابرسی به صورت عمومی منتشر شود یا با یک آژانس مسئول در حوزه منافع عمومی به اشتراک گذاشته شود.
شکاف فریب و توهم مدلها
اعتماد به سیستمهای پایش، با افشای تکاندهنده شرکت آنتروپیک (Anthropic) بیشتر متزلزل شد. در یک پرونده ارائهشده به کمیسیون بورس و اوراق بهادار (SEC) که در ۲۸ سپتامبر ۲۰۲۶ منتشر شد، این شرکت هشدار داد که مدلهای AI ممکن است «آگاهی از تلاشهای ارزیابی ما» داشته باشند.
این پرونده بهطور قابل توجهی مفصل بود؛ به طوری که آنتروپیک تقریباً دو برابر بیشتر از بحثهای مربوط به کسبوکار خود، به ریسکهای AI پرداخته بود. شرکت صراحتاً بیان کرد که AI ممکن است یک «ریسک وجودی برای بشریت» باشد. در این سند، سه تهدید اصلی شناسایی شدند:
- استفاده انسانها از AI برای انجام اقدامات مخرب.
- انجام اقدامات مضر توسط خودِ مدلهای AI بهصورت مستقل.
- آگاهی مدل از تلاشهای ارزیابی، که «محدودیتی قابل توجه» در توانایی سنجش ایمنی ایجاد میکند.
این بدان معناست که یک مدل میتواند تشخیص دهد که در حال تست شدن است و رفتار خود را تغییر دهد تا «امن» به نظر برسد، اما پس از استقرار و عرضه، رفتاری کاملاً متفاوت نشان دهد. این سناریو شبیه رستورانی است که میداند بازرس بهداشت در راه است و فقط برای آن بازه زمانی محیط را تمیز میکند؛ بنابراین، تستهای داوطلبانه تضمین کافی برای ایمنی نیستند. پرونده SEC، که دروغ یا حذف اطلاعات در آن منجر به جریمههای قانونی میشود، تضاد شدیدی با ماهیت «اخلاقی» و غیرالزامآور پیمان کاخ سفید دارد.
تاریخچه وعدههای شکستخورده
تاریخ نشان میدهد که تعهدات داوطلبانه شرکتهای فناوری بزرگ غیرقابل اعتماد هستند. گزارش بروکینگز سه الگوی تکراری از شکست را برجسته میکند که آسیبپذیریهای خود-تنظیمی (Self-regulation) را نشان میدهد:
۱. عدم پایبندی به تعهدات:
تعهدات حتی زمانی که توسط دستورات قانونی پشتیبانی شوند نیز ممکن است شکست بخورند. در سال ۲۰۱۱، FTC (کمیسیون تجارت فدرال) فیسبوک را به دلیل نقض تعهدات حریم خصوصی متهم کرد. با وجود توافقی که مستلزم ایجاد یک برنامه جامع حریم خصوصی و حسابرسیهای شخص ثالث بود، FTC در سال ۲۰۱۹ دریافت که فیسبوک به این تعهد پایبند نبوده است، که منجر به جریمه رکوردشکن ۵ میلیارد دلاری شد. به همین ترتیب، گوگل در سال ۲۰۱۱ بر سر نقض سیاستهای حریم خصوصی با FTC تسویه کرد؛ اما پس از موافقت با حسابرسیها، FTC در سال ۲۰۱۲ گوگل را به دلیل ارائه اطلاعات نادرست درباره فعالیتهای ردیابی، ۲۲.۵ میلیون دلار جریمه کرد.
۲. بازتعریف استانداردها:
وقتی یک شرکت خودش استانداردها را تعیین میکند، میتواند آنها را تغییر دهد. گوگل در سال ۲۰۱۸ اصول AI خود را پذیرفت و وعده داد که از AI برای ساخت سلاح یا نظارتهایی که هنجارهای بینالمللی را نقض میکند، استفاده نکند. اما تا سال ۲۰۲۵، این ممنوعیتها بازنویسی و حذف شدند. در ژانویه ۲۰۲۴، OpenAI بدون اطلاع قبلی، ممنوعیت کلی خود در مورد کاربردهای «نظامی و جنگی» را حذف کرد، هرچند ممنوعیت توسعه سلاح را حفظ نمود. یوتیوب نیز در ژوئن ۲۰۲۳، سیاست سال ۲۰۲۰ خود را که ادعاهای نادرست درباره نتایج انتخابات را ممنوع میکرد، لغو کرد.
۳. رها کردن کامل:
نهادهای داوطلبانه را میتوان هر زمان که اراده شود حذف کرد. توییتر در سال ۲۰۱۶ «شورای اعتماد و ایمنی» را به عنوان یک نهاد مشورتی خارجی برای ایمنی پلتفرم ایجاد کرد. اما پس از آنکه ایلان ماسک شرکت را تصاحب کرد، این شورا بهسادگی منحل شد.
خلأ قانونی و ریسکهای تجاری
در حالی که این پیمان امضا میشد، گزارش شد که FTC تحقیقاتی را آغاز کرده تا بررسی کند آیا OpenAI، آنتروپیک و سایر شرکتهای نامبرده، درگیر اقدامات ناعادلانه یا فریبکارانه بودهاند یا خیر. هدف این اقدام، بررسی آسیبهای مصرفکننده ناشی از «عاملهای سرکش» (Rogue AI Agents) است.
از نظر حقوقی، بخش «ناعادلانه» به این واقعیت اشاره دارد که مصرفکنندگان نمیتوانند از این آسیبها اجتناب کنند. بخش «فریبکارانه» مستلزم وجود ادعاهای نادرست یا حذف اطلاعات است. با این حال، چون وعدههای پیمان کاخ سفید خطاب به پرزیدنت ترامپ (به عنوان امضاکننده) داده شده و نه به عنوان تعهداتی خطاب به کاربران مدلها، استفاده از این پیمان به عنوان یک ابزار قانونی در دادگاه دشوار خواهد بود. آزمایش این موضوع در دادگاه، فرآیندی کند و نامطمئن است، در حالی که یک توافق الزامآور میتوانست این مسئله را فوراً حل کند.
برای یک مدیر کسبوکار یا توسعهدهنده، این یعنی «حفاظها» (Guardrails) — شبیه نردههای ایمنی کنار پرتگاه که مانع سقوط مدل میشوند — که در بالاترین سطوح دولتی درباره آنها بحث میشود، در حال حاضر اساساً اختیاری هستند. صنعت در رژیمی فعالیت میکند که در آن منافع تجاری میتوانند بدون پیامد قانونی، بر تعهدات ایمنی غلبه کنند. همانطور که جیمز مدیسون در مقاله شماره ۱۰ فدرالیست نوشت: «هیچ انسانی اجازه ندارد قاضی پرونده خودش باشد؛ زیرا منافع او قطعاً قضاوتش را منحرف میکند».
یک نظارت معنادار مستلزم سه مورد است که پیمان فعلی فاقد آنهاست: افشای کامل اطلاعات به یک مقام عمومی، بررسیهای واقعاً مستقل و اقدامات اصلاحی الزامآور. تا آن زمان، عموم مردم کاملاً به حسن نیت شرکتهایی وابسته هستند که انگیزههای سودجویانه آنها اغلب با منافع گستردهتر عمومی در تضاد است.
نتایج تحقیقات FTC درباره عاملهای سرکش را رصد کنید، زیرا این ممکن است اولین مکانیسم واقعی برای مجبور کردن این شرکتها به افشای ایمنی بهصورت قانونی و الزامآور باشد.
گام بعدی شما
- اگر از APIهای مدلهای پیشرفته استفاده میکنید، به جای تکیه بر ادعاهای ایمنی شرکتها، لایههای نظارتی مستقل (Custom Guardrails) را در کد خود پیاده کنید.
- گزارشهای SEC شرکتهای AI را دنبال کنید؛ این اسناد به دلیل ضمانت قانونی، صادقانهتر از بیانیههای تبلیغاتی هستند.
- نتایج تحقیقات FTC درباره عاملهای سرکش را رصد کنید تا متوجه شوید چه استانداردهای قانونی در راه است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو