تصور کنید برنامهنویسی هستید که سیستمی ساخته تا قوانین مرخصی شرکت را پاسخ دهد. سیاست شرکت میگوید: «کارمندان میتوانند تا پنج روز از مرخصی سالانه استفادهنشده خود را به سال بعد منتقل کنند. این گزینه تنها پس از تکمیل یک سال سابقه خدمت در دسترس است.» اما هوش مصنوعی به کاربر میگوید «بله، میتوانید مرخصی خود را منتقل کنید»، در حالی که شرط «یک سال سابقه کار» را کاملاً نادیده گرفته است. این اتفاق زمانی میافتد که سیستم بازیابی تنها جمله اول را استخراج کرده و جمله دوم را رها میکند. این یک توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه تعریف میکند — نیست، بلکه نتیجهی یک خطای مهندسی در تکهبندی دادههاست.
تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — برای کار کردن نیاز دارد اسناد حجیم را به قطعات کوچکی به نام تکهبندی (Chunking) تقسیم کند. این تکهها سپس به بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است — تبدیل میشوند تا جستوجو ممکن شود. طبق راهنمای منتشر شده در ۱۷ اکتبر ۲۰۲۶ در وبسایت dev.to، تضاد میان اندازه تکه و حفظ زمینه (Context)، عامل اصلی بازیابیهای ناقص است. تکههای کوچک سریعتر واقعیتهای خاص را مییابند اما سرتیترها یا استثنائات را که به آن واقعیتها معنا میبخشند، حذف میکنند. این چالش با مشکلات تکهبندی با اندازه ثابت که منجر به گسستگی ایدهها در اکثر موارد میشود، همسو است.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی بازیابی دادهها اشاره کردیم، تکههای بزرگتر زمینه را حفظ میکنند اما نویز ایجاد میکنند. وقتی یک بردار سعی میکند چندین موضوع مختلف را نمایندگی کند، معنای آن رقیق میشود. این موضوع باعث میشود تطبیق یک سؤال دقیق و مفصل با تکه متن صحیح دشوارتر گردد. چالش اصلی این است که مقدار متنی که سیستم برای «یافتن» جواب نیاز دارد با مقدار متنی که مدل برای «توضیح» آن میخواهد، لزوماً یکسان نیست و این دو مقدار همیشه نباید برابر باشند.
تکهبندی ساختار-آگاه و بازگشتی
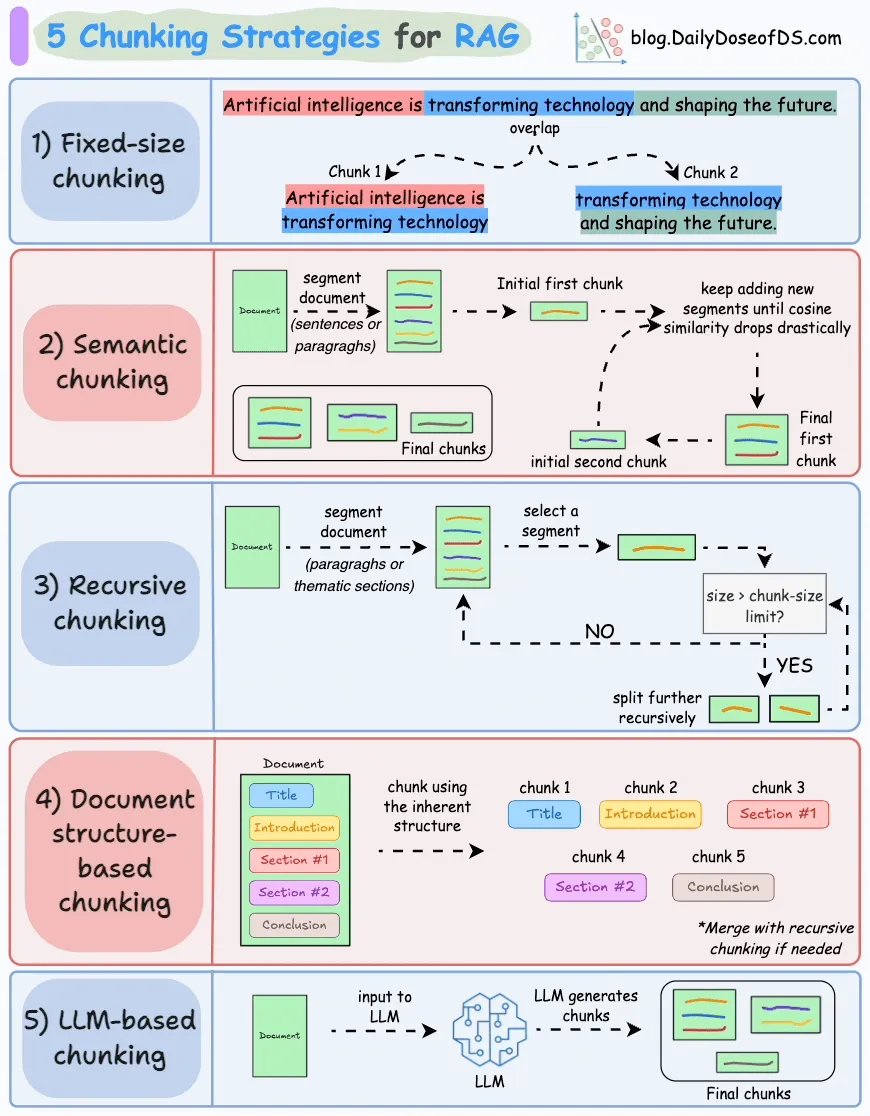
برای اسنادی با سلسلهمراتب مشخص مثل دفترچههای راهنمای فنی، قراردادها یا سیاستهای سازمانی، تکهبندی ساختار-آگاه (Structure-Aware Chunking) استاندارد طلایی است. این روش از سرتیترها برای حفظ زمینه استفاده میکند. سرتیترها نحوه تفسیر ما از متن زیرین را تغییر میدهند؛ برای مثال، تفاوت بین «کارمندان رسمی»، «کارمندان قراردادی» و «کارمندان در دوره آزمایشی» در سرتیتر نهفته است.
در این حالت، یک تکه فقط شامل متن نیست، بلکه یک مسیر متادیتای مشخص را با خود حمل میکند، مثلاً: «سیاست استخدامی ← کارمندان رسمی ← مرخصی سالانه».
- جایگذاری مسیر در بردار: گنجاندن این مسیر مستقیماً در متنِ برداری شده، به سیستم جستوجو کمک میکند تا تکه متن را با دقت بیشتری بیابد.
- ارسال به پرامپت: حضور این مسیر در دستور نهایی به مدل کمک میکند تا قانون را به درستی تفسیر کند.
بدون این ساختار، قانونی که فقط برای کارمندان آزمایشی است، ممکن است برای همه اعمال شود. به همین دلیل است که تجزیه (Parsing) درست سند حیاتی است؛ اگر سرتیترها یا روابط جداول در مرحله استخراج اولیه حذف شوند، هیچ تکهبندی نمیتواند آنها را برگرداند. این نوع نقصها در استخراج دادهها را میتوان در بررسی نقاط شکست RAG در محیطهای سازمانی که باعث مختل شدن خط لولههای هوش مصنوعی میشود، مشاهده کرد.
در مواردی که فرمت سند نامنظم است یا بخشهای ناسازگاری دارد، تکهبندی بازگشتی (Recursive Splitting) یک خط پایه کاربردی است. این رویکرد ابتدا مرزهای بزرگتر مثل شکستگیهای پاراگراف را امتحان میکند و در صورت عدم موفقیت، به سراغ مرزهای کوچکتر میرود. اجرای این روش ساده است و نیازی به یک مدل مجزا برای تصمیمگیری درباره محل هر برش ندارد. با این حال، یک شکستگی پاراگراف تضمین نمیکند که توضیح کاملی ارائه شود؛ ممکن است یک قانون در یک پاراگراف باشد اما استثنای آن در پاراگراف بعدی قرار گرفته باشد. بر اساس گزارش پژوهشی Chroma، تکهبندی بازگشتی اگر درست پیکربندی شود، همچنان در برابر روشهای پیچیدهتر رقابتی است.
بازیابی معنایی و پیشرفته
تکهبندی معنایی (Semantic Chunking) از سیگنالهایی مثل شباهت جملات برای گروهبندی متن استفاده میکند تا موضوعات نامرتبط با هم ترکیب نشوند. اما شباهت در کلمات همیشه به معنای شباهت در مفهوم نیست. دو محصول مختلف ممکن است توصیفات تقریباً یکسانی داشته باشند اما محدودیتهای متفاوتی داشته باشند که باعث شود سیستم آنها را به اشتباه در یک تکه گروهبندی کند. به همین ترتیب، یک استثنای قانونی ممکن است از نظر لحن و کلمات با قانونی که تغییر میدهد، بسیار متفاوت به نظر برسد.
برای حل این مشکل، مقاله ACL 2025 با عنوان «اهمیت قطعهبندی سند برای RAG»، روش PIC را معرفی کرد. این متد از خلاصههای سند برای هدایت نحوه گروهبندی جملات استفاده میکند و بهبودهای قابلاندازهگیری در بنچمارکهای بازیابی نشان داده است. این موضوع نشان میدهد که PIC یک رویکرد عملی برای بررسی است، هرچند لزوماً برای هر نوع سندی برنده مطلق نیست.
یک رویکرد پیشرفته دیگر، بازیابی والد-فرزند (Parent-Child Retrieval) است که وظیفه «مکانیابی» را از «ارائه زمینه» جدا میکند:
- تکههای فرزند: سیستم تکههای کوچک را برای یافتن تطبیق دقیق جستوجو میکند (مثلاً یافتن مقدار مجاز انتقال مرخصی).
- بخشهای والد: پس از یافتن تطبیق، سیستم بخش بزرگتر اطراف آن را شناسایی کرده و برای مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — بازمیگرداند (مثلاً بازیابی شرط سابقه کار).
این روش نیازمند محدودیتهایی است تا با بازگرداندن کل فصلها، بودجه پنجره متنی (Context Budget) را تمام نکند. همچنین بخشهای همپوشان باید ترکیب شوند تا مدل یک تکه متن را چندین بار دریافت نکند.
نقش همپوشانی و تکهبندی دیرهنگام
بسیاری از توسعهدهندگان از همپوشانی (Overlap) برای تکرار بخشی از متن در تکههای مجاور استفاده میکنند. این کار از قطع شدن زمینه در مرزها جلوگیری میکند، اما نمیتواند استثنائی را که چندین صفحه دورتر قرار دارد بازیابی کند. همچنین همپوشانی بیش از حد، پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — را با دادههای تکراری و تقریباً یکسان پر میکند. اگر یک بازیاب پنج تکه برگرداند و سه تای آنها تقریباً یکسان باشند، مدل شواهد واقعی کمتری نسبت به تعداد نتایج دریافت میکند.
تکهبندی دیرهنگام (Late Chunking) مشکل عمیقتری را حل میکند: از دست رفتن معنا پیش از شروع جستوجو. جمله «این قانون فقط برای ساکنان لندن است» را در نظر بگیرید. در RAG استاندارد، متن ابتدا تکه میشود و سپس برداری میگردد. یک مدل برداری که این جمله را در حالت ایزوله پردازش میکند، ممکن است نداند «این» به چه چیزی اشاره دارد.
در تکهبندی دیرهنگام، ترتیب خط لوله تغییر میکند:
۱. یک مدل برداری سازگار، ابتدا یک قطعه متن طولانیتر را پردازش میکند.
۲. سیستم بردارهای تکه را از نمایش توکنهایی میسازد که قبلاً متن اطراف را «دیدهاند».
۳. در نتیجه، خودِ بردار حاوی زمینه کل سند است.
باید توجه داشت که تکهبندی دیرهنگام نیازمند یک خط لوله (Pipeline) برداری خاص و سازگار است؛ صرفاً ارسال یک سند طولانی به یک API برداری استاندارد، این قابلیت را پیادهسازی نمیکند. علاوه بر این، یک بردار بهتر به طور خودکار پاراگراف قبلی را به متن بازیابی شدهای که برای مدل پاسخدهنده ارسال میشود، اضافه نمیکند.
ارزیابی موفقیت
سنجش موفقیت RAG فراتر از بررسی حضور جواب در متن است. یافتن عبارت «۵ روز مرخصی» بدون یافتن «شرط یک سال سابقه»، یک موفقیت جزئی و در عمل یک شکست است. یک ارزیابی قوی باید بپرسد:
- آیا تمام شواهد لازم برای پاسخ بازیابی شدند؟
- آیا شرایط و استثنائات در پاسخ نهایی حفظ شدند؟
- چه مقدار متن نامرتبط به مدل رسید؟
- چه مقدار از متن بازیابی شده تکراری بود؟
- آیا تکههای نقلشده، پاسخ کامل را پشتیبانی میکنند؟
شرکت Chroma پیشنهاد میکند بازیابی در سطح توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی — اندازهگیری شود. این کار فاش میکند که آیا یک تکه بزرگ حاوی جواب، به دلیل نویز زیاد، در واقع نتیجهای ناکارآمد است یا خیر. مقایسه منصفانه اندازه زمینهها — یعنی ثبت مقدار واقعی متن بازیابی شده هنگام مقایسه پنج تکه کوتاه در برابر پنج تکه بلند — برای بهینهسازی ضروری است.
انتخاب استراتژی کاملاً به دادهها بستگی دارد. سرتیترهای واضح، تکهبندی ساختار-آگاه را ترجیح میدهند، در حالی که تغییرات موضوعی بدون علامت، تکهبندی معنایی را توجیه میکنند. فرمت ضعیف، تکهبندی بازگشتی را به یک خط پایه معقول تبدیل میکند. همپوشانی به مرزهای نزدیک کمک میکند، بازیابی والد-فرزند توضیحات محیطی را بازیابی میکند و تکهبندی دیرهنگام فقدان زمینه در هنگام برداری را برطرف میسازد. هدف این است که اطمینان حاصل شود یک نتیجه جستوجوی مرتبط، در عین حال یک شاهد مفید باشد.
گام بعدی شما
- اگر از اسناد ساختاریافته استفاده میکنید، استراتژی تکهبندی را از بازگشتی به ساختار-آگاه تغییر دهید و مسیر متادیتا را به پرامپت اضافه کنید.
- برای کاهش توهمات ناشی از فقدان زمینه، مدل بازیابی والد-فرزند را پیادهسازی کنید تا جستوجو در تکههای کوچک و پاسخدهی با تکههای بزرگ صورت گیرد.
- در صورت دسترسی به مدلهای برداری پیشرفته، تکهبندی دیرهنگام را برای حل مشکل ارجاعات (مثل ضمیر «این» یا «آن») تست کنید.
اما بهینهسازی تکهبندی تنها نیمی از مسیر است؛ اثر بازرتبهبندی (Reranking) بر دقت نهایی پاسخها را در گزارش بعدی بررسی خواهیم کرد.



گفتگو