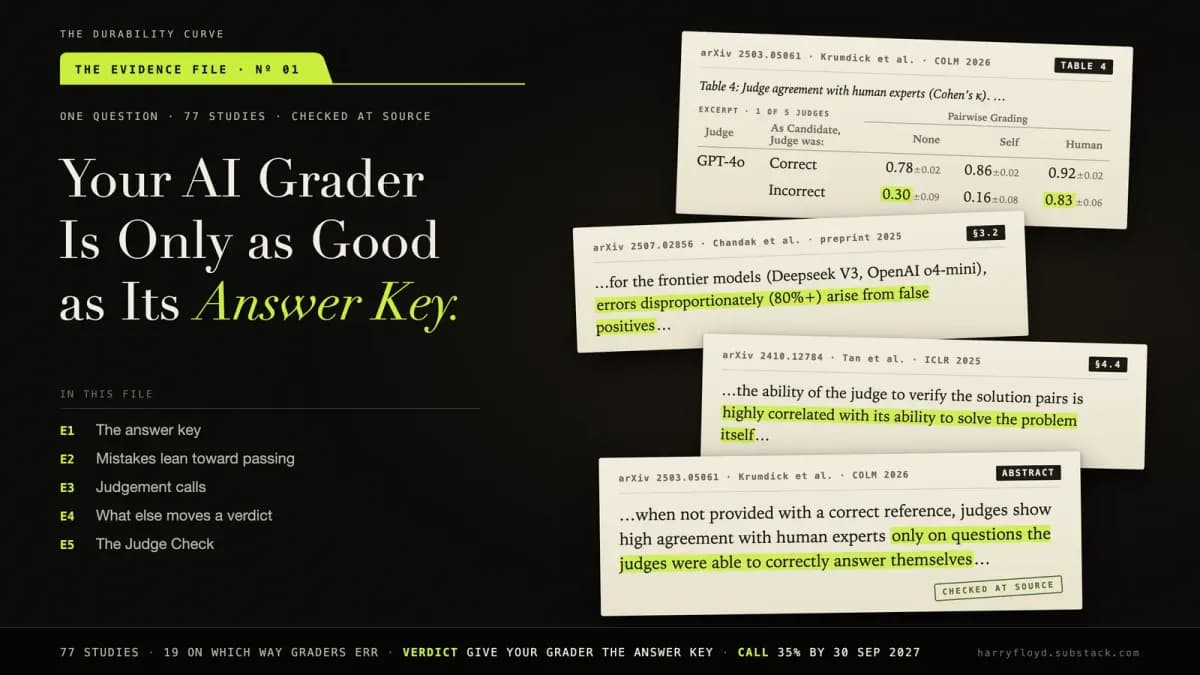
اگر امروز برای ارزیابی کیفیت خروجیهای مدلهای خود به یک مدل زبانی دیگر تکیه میکنید، احتمالاً در حال اندازهگیری «سخاوتمندی» مدل داور هستید، نه دقت مدل مورد آزمایش. بیش از ۸۰٪ خطاهای داوران هوش مصنوعی از نوع «قبولهای کاذب» است؛ یعنی پاسخهایی که توسط انسان رد شدهاند اما مدل آنها را درست علامت زده است. این یافتهها حاصل سنتز ۷۷ مطالعه است که نشان میدهد مدلهایی مانند DeepSeek V3 و o4-mini هنگام نمرهدهی به پاسخهای باز (Free-form) بدون داشتن کلید مرجع، دچار سوگیری خطرناکی به سمت تایید پاسخهای غلط میشوند. در واقع، قابلیت اطمینان یک داور هوش مصنوعی به محض برخورد با سوالی که خودش نمیتواند حل کند، به شدت کاهش مییابد.
برای بسیاری از توسعهدهندگان و پژوهشگران، «نرخ پاس» (Pass Rate) که توسط یک عامل هوش مصنوعی تولید میشود، معیار اصلی برای تصمیمگیری است. شما احتمالاً پرامپتی را روی مجموعهای از سوالات تست اجرا کردهاید و از مدل دیگری خواستهاید پاسخها را تصحیح کند. اما این عدد اغلب بازتابدهندهٔ مهربانی مدل داور است تا عملکرد واقعی مدل دانشآموز یا مدل مورد آزمایش. این همان سخاوتمندی است که در معیار «مبنیسازی» (Groundedness) در مقاله «یک نمره سبز دلیل نیست» دیده شد؛ جایی که مدل وقتی شواهد حذف میشدند، بهترین نمرات را میگرفت. این وضعیت یک نقطه کور سیستماتیک ایجاد میکند: دشوارترین سوالات — یعنی همانهایی که بیشترین اهمیت را دارند — بیشترین احتمال اشتباه در تصحیح را دارند.
رابطه مستقیم بین حل مسئله و تصحیح آن
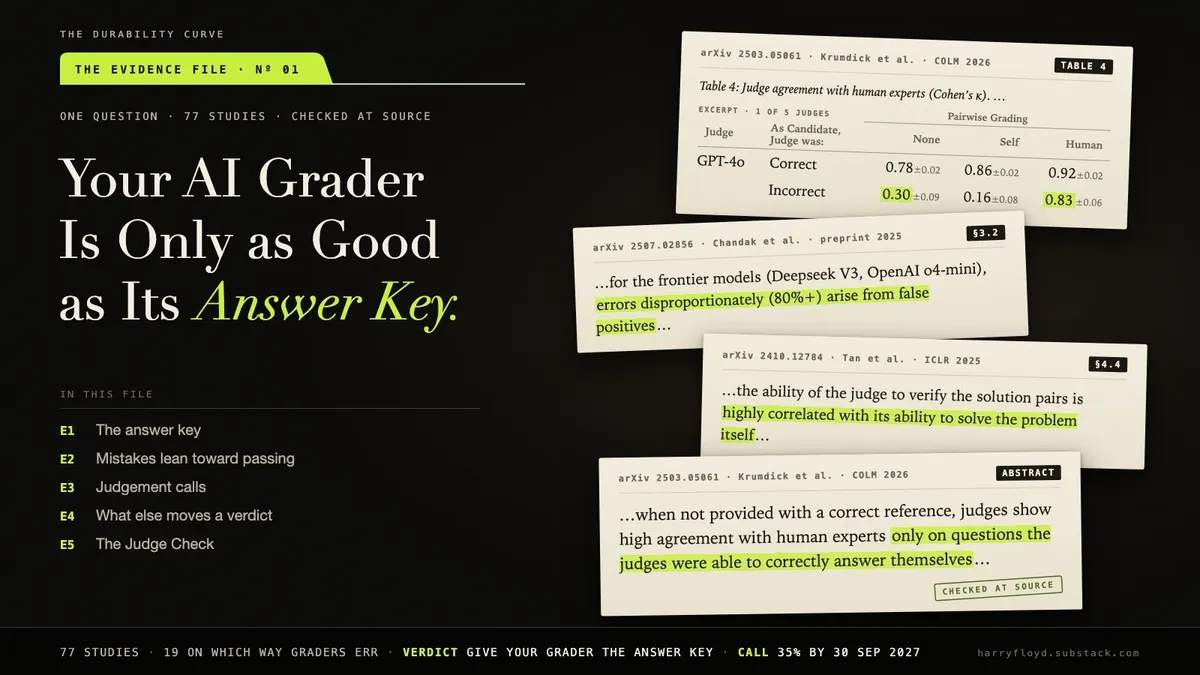
بر اساس مستندات پژوهشی، پیوندی مستقیم میان توانایی مدل در حل یک مسئله و توانایی او در تصحیح آن وجود دارد. در مطالعهای روی وظایف مالی، ریاضی و استدلالی، داوران تنها در سوالاتی با متخصصان انسانی توافق داشتند که خودشان قادر به پاسخ دادن به آنها بودند.
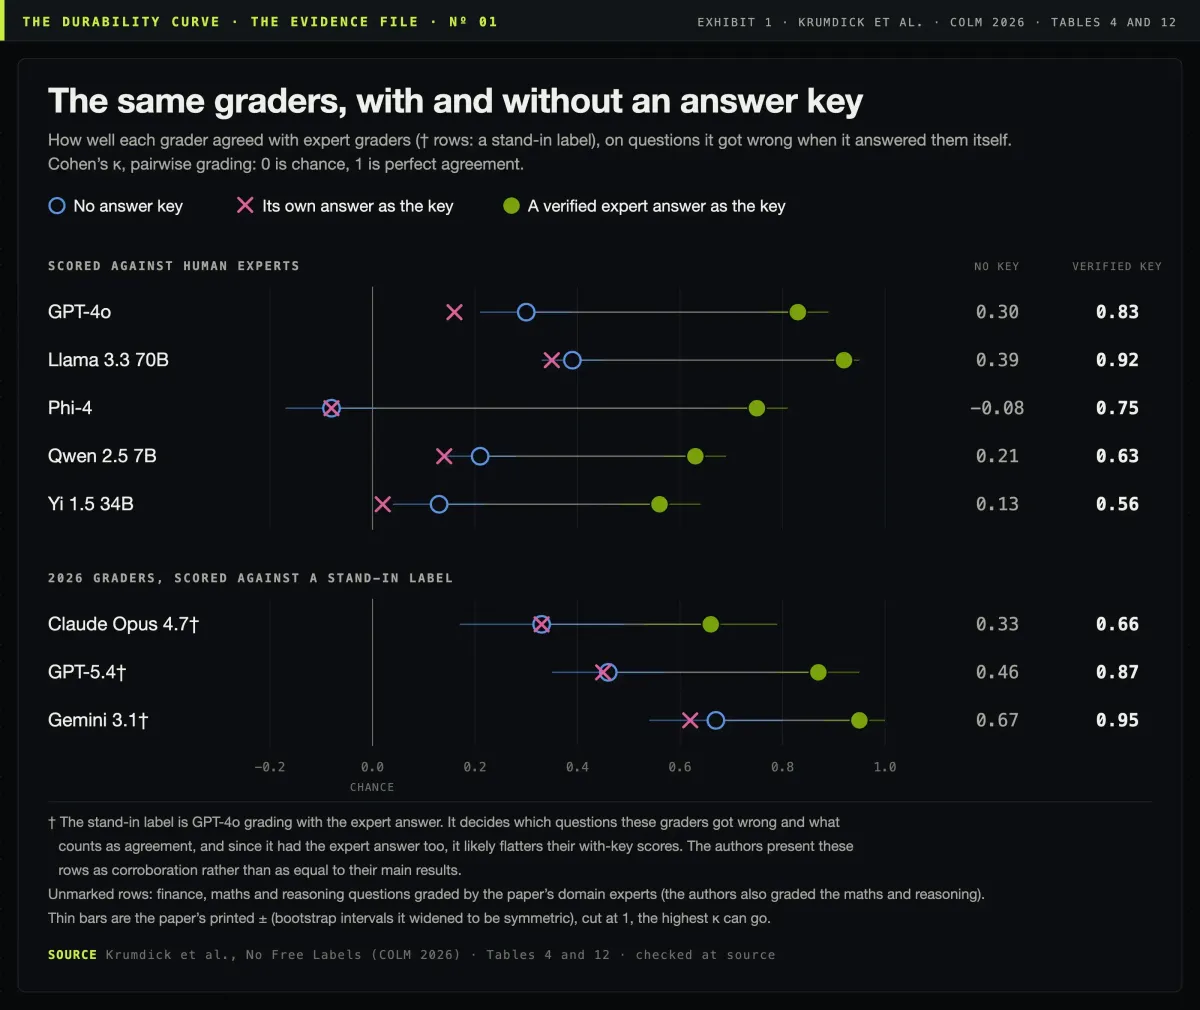
مدل GPT-4o این شکاف را به وضوح نشان داد: میزان توافق این مدل با متخصصان در سوالاتی که خودش درست پاسخ داده بود ۰.۷۸ (ضریب کاپا کوهن) بود، اما در سوالاتی که اشتباه پاسخ داده بود، این عدد به ۰.۳۰ سقوط کرد. در مقیاسی که ۰ به معنای شانس و ۱ به معنای توافق کامل است، این فاصله بسیار زیاد است. حتی وقتی مدل از پاسخ (اشتباه) خودش به عنوان کلید مرجع استفاده کرد، توافق به ۰.۱۶ رسید.
پلتفرم JudgeBench در سال ۲۰۲۴ این موضوع را تایید کرد و دریافت که توانایی یک داور در بررسی پاسخها، همبستگی بالایی با توانایی او در حل همان مسئله دارد. این یعنی بدون یک کلید تاییدشده، داور در مواجهه با سختترین موارد در واقع در حال حدس زدن است.
قدرت کلید پاسخ تاییدشده
ارائه یک کلید پاسخ معتبر، عملکرد داور را متحول میکند. برای GPT-4o، وجود یک کلید تاییدشده توسط متخصص، میزان توافق در سوالات دشوار را از ۰.۳۰ به ۰.۸۳ رساند.
- اصلاح MT-Bench در سال ۲۰۲۳: نویسندگان پیشنهاد کردند داور ابتدا خودش به سوال پاسخ دهد و سپس از آن به عنوان مرجع استفاده کند. در سوالات ریاضی، این کار نرخ شکست را از ۷۰٪ به ۱۵٪ کاهش داد.
- یافتههای Prometheus: سازندگان این مدل دریافتند که داشتن مرجع، داور را از ضرورت حل مسئله رها میکند؛ البته به شرطی که پاسخ خودِ داور درست باشد.
- میانبر تایید: پاسخی که توسط مدل نوشته و توسط انسان چک شده بود، نمره ۰.۶۱ گرفت که به نمره پاسخهای انسانی (۰.۶۹) نزدیک است. این نشان میدهد تایید پاسخ مدل اغلب کافی است.
- خطر کلیدهای «تقریباً درست»: در بررسی پنج داور، استفاده از کلیدی که خطای جزئی داشت، نمره ۰.۲۱ گرفت؛ یعنی بدتر از اینکه هیچ کلیدی در کار نباشد (۰.۴۶) یا حتی کلیدی کاملاً بیربط استفاده شود (۰.۵۰).
سوگیری به سمت قبولهای کاذب
وقتی داوران هوش مصنوعی اشتباه میکنند، بهندرت یک پاسخ درست را رد میکنند؛ در عوض، معمولاً پاسخ غلط را قبول میکنند. از میان ۱۹ مطالعه که جهت خطا را ردیابی کردند، ۱۲ مورد تمایل شدید به قبول کردن کارهای شکستخورده را نشان دادند. سه مطالعه تمایل به «ردهای کاذب» داشتند و چهار مورد نتایج مختلطی را نشان دادند.
در تصحیح اثباتهای سطح دانشگاهی، این سوگیری حتی با وجود راهنما ادامه داشت. داوران با وجود داشتن یک روب ریک (Rubric) — که شبیه به یک چکلیست برای ارزیابی است و میگوید باید به دنبال چه مواردی باشیم — همچنان بین ۳۸.۰٪ تا ۴۵.۷٪ از اثباتهایی را که متخصصان رد کرده بودند، قبول کردند. این موضوع اهمیت استانداردسازی ارزیابیهای انسانی را برای حذف توهمات مدلهای داور دوچندان میکند. در مقابل، آنها تنها ۵.۰٪ تا ۱۲.۳٪ از اثباتهای درست را به اشتباه رد کردند. دو داور دیگر حتی 너رمتر (سخاوتمندتر) بودند. این ثابت میکند که یک روب ریک ضعیفتر از یک کلید پاسخ (که دقیقاً میگوید جواب چیست) است.
استثنائات و موارد خاص
همه وظایف تصحیح از این الگو پیروی نمیکنند. بررسی کد (Code Review) اغلب در جهت مخالف حرکت میکند. GPT-4o در دو بنچمارک، ۲۶.۲٪ و ۳۵.۹٪ از برنامههای درست را به اشتباه رد کرد، در حالی که این بررسیها بر اساس یک مشخصات (Spec) مکتوب انجام شده بود. این نرخ شکست زمانی که از مدل خواسته شد کد را توضیح دهد و تعمیر کند، به ۷۳.۲٪ و ۸۷.۹٪ رسید. اگر داور شما نقش منتقد یا تعمیرکار دارد، باید «ردهای کاذب» را جداگانه محاسبه کنید. این چالشها در بازبینیهای دقیقتر مشهود است، مشابه آنچه در شناسایی خطاهای پنهان در نویسندگی فنی توسط بازبینی انسانی مشاهده شد.
قضاوتهای ذهنی — جایی که پاسخ واحد «درستی» وجود ندارد — سختترین مرز هستند:
- علوم: مدل o3 در ۶۵.۱٪ موارد با رای انسانها همسو بود (در حالی که حدس تصادفی ۵۰٪ است).
- تصحیح بالینی: هیچ مدلی نتوانست در تمام ۵ وظیفه مورد آزمایش با توافق پزشکان همسو شود. تنها مدلی که روی تعداد کمی از موارد نمرهگذاریشده توسط پزشک تنظیم دقیق (Fine-tuning) شده بود، در ۳ مورد از ۵ وظیفه به این سطح رسید.
- HealthBench: داور GPT-4.1 شرکت OpenAI در ۵ مورد از ۷ محور، نمرهای بالاتر از میانگین پزشکان گرفت، هرچند این مطالعه از ابتدا از معیارهای نوشتهشده توسط پزشکان استفاده کرده بود.
- ترجیحات چت: GPT-4 در ۸۵٪ موارد با برچسبگذاران متخصص توافق داشت (بدون احتساب موارد مساوی)، که از توافق انسان با انسان (۸۱٪) بیشتر بود. اما وقتی موارد مساوی لحاظ شدند، این عدد برای جفتها ۶۶٪ و برای پاسخهای تک را ۶۰٪ بود. یک آزمون سختگیرانهتر روی MT-Bench نشان داد که هیچ مدلی نمیتواند از نظر آماری جایگزین یک ارزیاب انسانی شود.
- Chatbot Arena: توافق GPT-4 با متخصصان بین ۷۶.۳٪ تا ۸۱.۰٪ بود، در حالی که متخصصان با یکدیگر بین ۷۹.۴٪ تا ۸۹.۸٪ توافق داشتند.
تاثیر چیدمان و ترتیب
فرمتبندی میتواند بیسروصدا رای داور را تغییر دهد. مدل GPT-5.4 تنها با جابهجایی ترتیب دو پاسخ، در یک بنچمارک ۱۱.۴٪ و در دیگری ۱۰.۵٪ رای خود را تغییر داد. مدلهای Gemini 3.1 Pro و Claude Opus 4.6 پایدارتر بودند و تغییرات آنها بین ۲.۰٪ تا ۳.۸٪ بود.
علاوه بر این، مدلها علاقه شدیدی به فرمت Markdown دارند. ۴ داور از ۵ مورد، در ۷۳٪ تا ۹۷٪ مواقع Markdown را به متن ساده ترجیح دادند، در حالی که انسانها در ۳۰ جفت نمونه، تنها در ۵۷٪ موارد این ترجیح را داشتند.
محدودیتهای راهکارهای رایج
استراتژیهای متداول برای بهبود تصحیح، اغلب کمتر از شهرتشان عمل میکنند. پانلی متشکل از سه داور کوچکتر، در سه مجموعه پرسشوپاسخ توانستند GPT-4 تنها را شکست دهند، اما در نهایت فقط با بهترین عضو همان پانل برابر شدند. همچنین، اگر داور بهتر از مدلی نباشد که آن را میسنجد، استفاده از تعداد کمی برچسب انسانی برای اصلاح آن، نمیتواند حجم کار انسان را بیش از نصف کاهش دهد.
پروتکل «بررسی داور» (Judge Check)
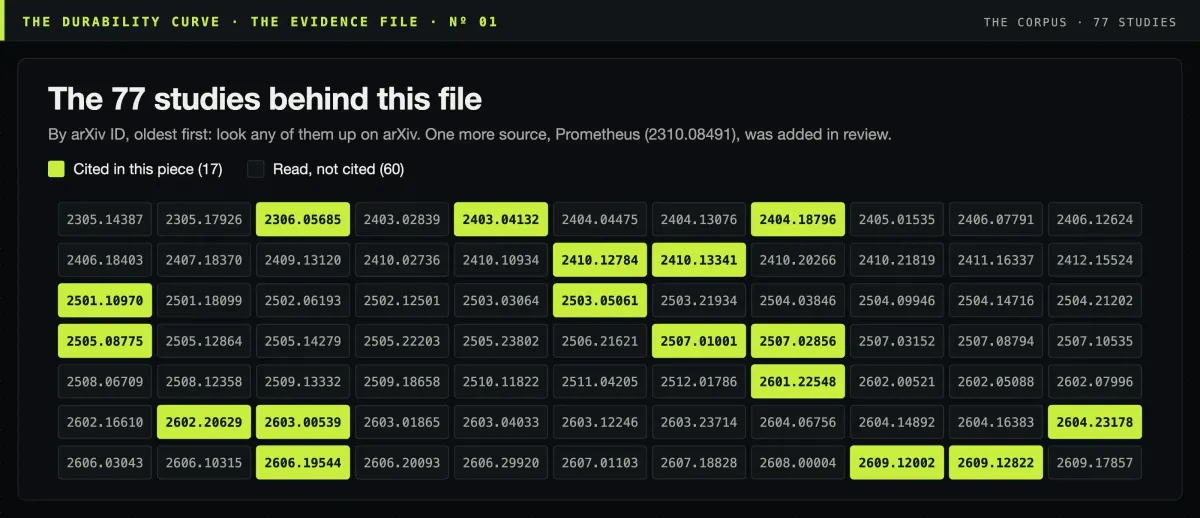
برای جلوگیری از این شکستها، متخصصان باید یک غربال پنج مرحلهای را با استفاده از ۲۰ مورد (که حداقل ۱۰ مورد از آنها پاسخهای قطعا غلط باشند) اجرا کنند. این روش بر اساس رویکرد هامِل حسین در ردیابی توافق و بررسی یوجین یان درباره اثرات ترتیب است:
۱. خط پایه دستی: ۲۰ مورد را خودتان تصحیح کنید. تا حد امکان از اشتباهات واقعی سیستم خود برای ایجاد حقیقت زمینی (Ground Truth) استفاده کنید.
۲. اجرای دوگانه: داور را یک بار بدون کلید و یک بار با کلید پاسخهای تاییدشده اجرا کنید. برای موارد باز، لیستی از الزامات مکتوب ارائه دهید (هرچند این روش ضعیفتر از کلید پاسخ است).
۳. تست حل مسئله: از داور بخواهید هر سوال را در یک چت مجزا پاسخ دهد. اگر بیش از یک یا دو مورد را غلط جواب داد و در عین حال پاسخهای غلط را در حالت داوری «قبول» کرد، هرگز بدون کلید از آن برای آن نوع سوال استفاده نکنید.
۴. تست استرس چیدمان: پاسخها را با استفاده از سرتیترها، بولتها یا بولد کردنهای مختلف بازچینی کنید. اگر در حال نمرهدهی به جفتها هستید، ترتیب آنها را جابهجا کنید و تعداد تغییر رایها را بشمارید.
۵. شمارش مجزا: «قبولهای کاذب» و «ردهای کاذب» را به طور مستقل ردیابی کنید. میانگین توافق به تنهایی جهت خطا را میپوشاند.
تحلیل: توهم پیشرفت
این دادهها نشان میدهد که اتکای صنعت به «LLM-as-a-Judge» بر پایهای شکننده بنا شده است. مدلهای جدیدتر در حال بهبود هستند؛ در اجرای مجدد سال ۲۰۲۶، مدل Claude Opus 4.6 به توافق اصلاحشده (Chance-corrected) ۰.۸۷۵ و GPT-5.4 به ۰.۶۰۶ رسید. حتی Claude Opus 4.7 بهبود نشان داد و توافقش در سوالاتی که قبلاً در آنها شکست خورده بود، هنگام دریافت پاسخ متخصص از ۰.۳۳ به ۰.۶۶ رسید.
با این حال، شکاف همچنان باقی است. برای GPT-5.4، حتی تلاش استدلالی بالا (High reasoning effort) تنها توانست شکاف را در سوالاتی که غلط پاسخ داده بود از ۰.۶۸ به ۰.۸۴ کاهش دهد. برای یک کاربر عملی، هر «نرخ پاس» که توسط یک داور هوش مصنوعی بدون کلید تاییدشده تولید شود، در واقع معیاری از اعتمادبهنفس مدل است، نه درستی پاسخ.
جزئیات اجرایی برای بررسی داور
برای اجرای این بررسی، از پرامپتهای خاص استفاده کنید. برای اجرای بدون کلید، خط پاسخ تاییدشده را حذف کنید: «شما یک داور متخصص هستید. یک سوال و یک پاسخ به شما نشان داده میشود. تصمیم بگیرید که آیا پاسخ نهایی درست است یا خیر. دقیقاً با یک کلمه پاسخ دهید: PASS یا FAIL.»
برای تست حل مسئله (گام ۳)، از یک چت مجزا استفاده کنید تا پاسخ خودِ داور هرگز تبدیل به کلیدش نشود. از پرامپتی مانند این استفاده کنید: «به سوال پاسخ بده. مراحل کوتاه را نشان بده و در نهایت با یک خط به فرم FINAL:
برای تست چیدمان (گام ۴)، پاسخها را با فرمت ساختاریافته بازسازی کنید:
Solution
- <اولین خط محاسبات>
- <خط بعدی محاسبات>
- Final answer:
- FINAL:
ارزیابی نتایج
هنگام تحلیل برگه نمرهدهی، از این معیارهای خاص برای شناسایی حالتهای شکست استفاده کنید:
- قبولهای کاذب: مواردی را بشمارید که نمره شما FAIL اما نمره داور PASS است. این تعداد را با و بدون کلید مقایسه کنید.
- ردهای کاذب: مواردی را بشمارید که نمره شما PASS اما نمره داور FAIL است.
- توافق در حل مسئله: میزان توافق را به طور جداگانه برای سوالاتی که داور درست حل کرد در مقابل سوالاتی که اشتباه پاسخ داد، محاسبه کنید.
- تغییرات چیدمان: تعداد آرای تغییر یافته هنگام تغییر فرمت را بشمارید.
اگر قبولهای کاذب با وجود کلید ناپدید میشوند، از کلید استفاده کنید. اگر باقی میمانند، کلید را اصلاح کنید یا انسان را در چرخه نگه دارید. اگر توافق در سوالاتی که داور نمیتواند حل کند به طور قابل توجهی بدتر است، هرگز بدون کلید روی آن نوع سوالات اجرا نکنید.
برای اعتماد واقعی به یک داور هوش مصنوعی، باید از معیارهای ساده توافق فراتر بروید. داوری که از هر پنج پاسخ غلط، یکی را به اشتباه قبول میکند، ممکن است در یک تست ۱۰ موردی، یک بار از هر ده بار هیچ قبول کاذبی نشان ندهد. برای رسیدن به سطح اعتماد، راهنمای حسین پیشنهاد میکند برای هر حالت شکست، ۱۰۰ نمونه بسازید. تا آن زمان، مقرونبهصرفترین اقدام امنیتی ساده است: به داور خود کلید پاسخ را بدهید.



گفتگو