اگر در حال توسعهی عاملهای هوش مصنوعی هستید که باید در لحظه پاسخ دهند، معیار سرعت شما امروز تغییر کرد. مدل GLM-5.3-FlashX با توان عملیاتی ۲۰۰ توکن در ثانیه، مرزهای پاسخدهی آنی را جابهجا کرده است. این مدل در ۱۸ سپتامبر ۲۰۲۶ عرضه شد تا پاسخگوی نیاز برنامههایی باشد که در آنها هر میلیثانیه تأخیر در فراخوانی ابزارها، تجربه کاربر را تخریب میکند. این موضوع در حالی رخ میدهد که رویکرد توسعه عاملهای هوشمند در حال گذار از حلقههای ساده به موتورهای گراف است تا مدیریت پروژههای پیچیده AI بهینهتر شود. طبق اعلام Z.ai، این مدل بهصورت بومی چندوجهی (Multimodal) است و میتواند ویدیو، تصویر، متن و فایلها را با یک پنجره زمینه (Context Window) عظیم یک میلیون توکنی پردازش کند.
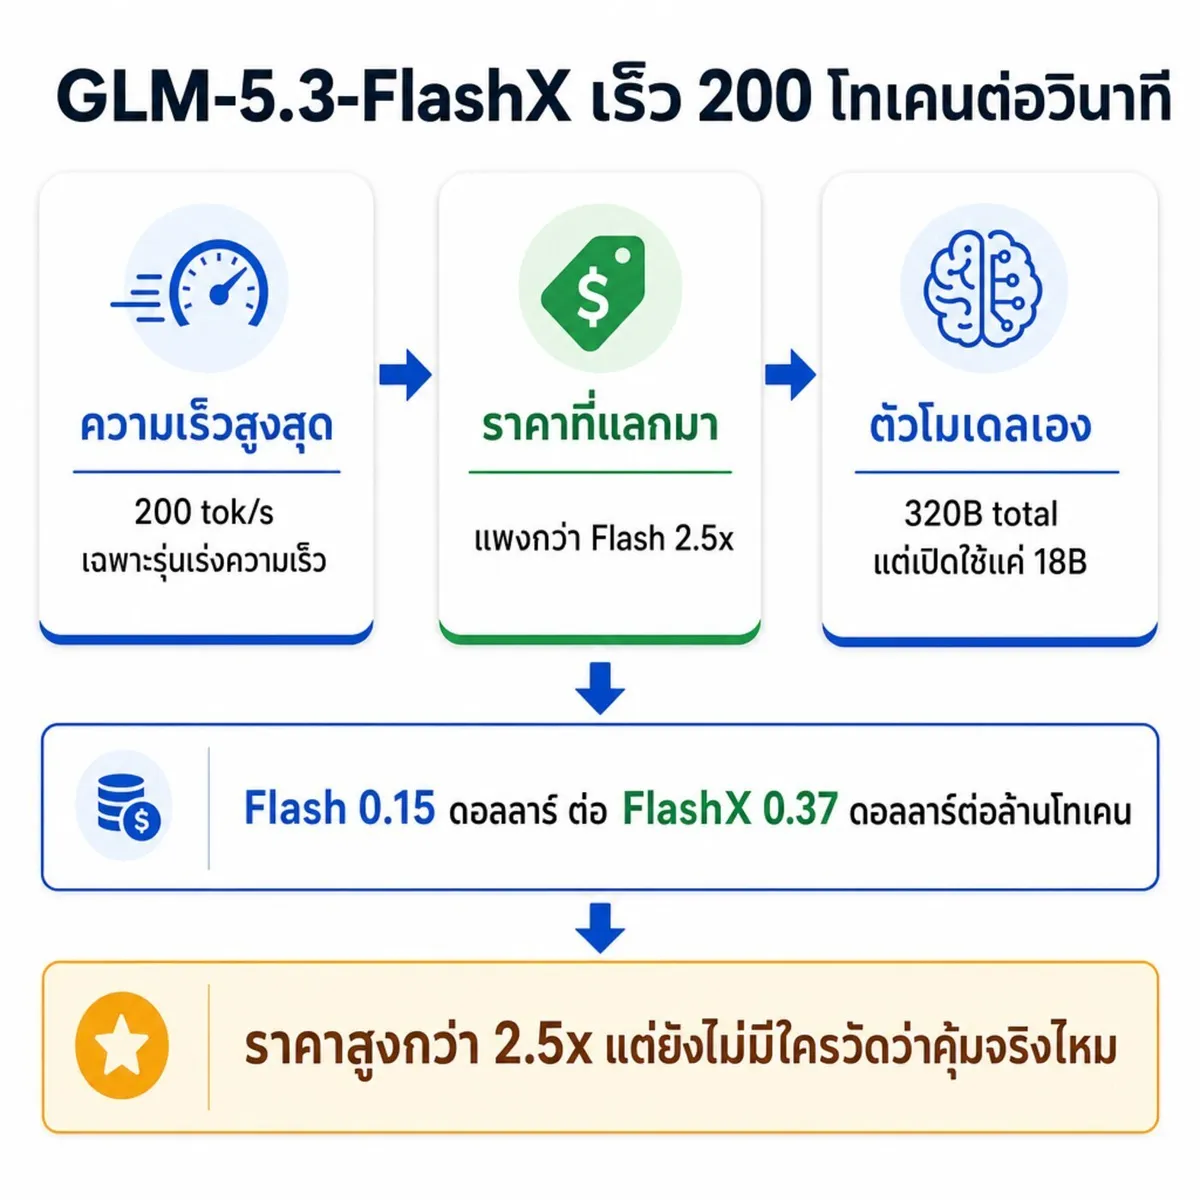
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای لبه اشاره کردیم، کاهش تأخیر همواره با هزینهای همراه است. در مورد FlashX، این بهای سرعت بسیار سنگین است؛ بر اساس مستندات رسمی Z.ai، هزینه توکنهای خروجی این مدل ۲.۵ برابر و توکنهای ورودی ۲.۴۷ برابر مدل استاندارد GLM-5.3-Flash است.
قیمتگذاری و سطوح مدل
برای درک جایگاه FlashX، باید آن را در خانواده GLM-5.3 بررسی کرد. طبق جدول قیمتهای رسمی Z.ai:
- GLM-5.3-Flash: ورودی ۰.۱۵ / خروجی ۰.۵۰ دلار (مدل چندوجهی اقتصادی و اصلی).
- GLM-5.3-FlashX: ورودی ۰.۳۷ / خروجی ۱.۲۵ دلار (نسخه شتابیافته ۲۰۰ توکن در ثانیه).
- GLM-5.3: ورودی ۱.۴۰ / خروجی ۴.۴۰ دلار (مدل پرچمدار با تمرکز بر امنیت سایبری و کدنویسی).
نکته مهم این است که در حالی که مدل Flash استاندارد بهطور صریح در «طرح کدنویسی GLM» گنجانده شده و سهمیه آن ۳ برابر مدل GLM-5.3 است، نسخه FlashX تحت پوشش این طرح نیست. کاربران برای استفاده از FlashX باید هزینه را بر اساس مصرف واقعی و لحظهای پرداخت کنند.
معماری فنی و نقاط اشتراک
بهرهوری این مدل از طراحی ترکیب خبرهها (Mixture of Experts - MoE) نشأت میگیرد. مدل GLM-5.3-Flash در مجموع ۳۲۰ میلیارد پارامتر دارد، اما برای هر توکن تنها ۱۸ میلیارد پارامتر فعال میشوند تا هزینههای محاسباتی پایین بماند.
به نقل از Z.ai، این شرکت برای نخستین بار در صنعت، «توجه پراکنده» (Sparse Attention) را با «توجه خطی» (Linear Attention) ترکیب کرده است. این رویکرد ترکیبی، محاسبات توجه (Attention) را ۳.۰۱ برابر کاهش و حجم KV Cache را ۴.۴۴ برابر نسبت به مدل پایه GLM-5.3 کوچکتر کرده است. این معماری شامل ۴۵ لایه است که در آن نسبت لایههای خطی به کامل ۳ به ۱ است (۳۴ لایه خطی و ۱۱ لایه توجه کامل).
جالب اینجاست که این طراحی شباهت زیادی به مدل Qwen3.8-Flash-Next دارد که در حدود ۲۴ اوت ۲۰۲۶ منتشر شد. هر دو تیم بهطور مستقل روی چهار ستون فنی مشترک متمرکز شدهاند:
- نسبت توجه: استفاده از نسبت ۳ به ۱ که در آن لایههای خطی، تاریخچه را در یک حالت بازگشتی با اندازه ثابت فشرده میکنند تا محاسبات ثابت بماند، در حالی که لایههای توجه کامل، بازیابی دقیق دادهها در فواصل دور را مدیریت میکنند.
- فشردهسازی زمینه: هر دو مدل از بودجه ۲۰۴۸ توکنی برای تاریخچههای با اولویت بالا استفاده میکنند. GLM از یک رتبهبند لایتنینگ ۳۲-سره با سیستم "IndexPool" برای فشردهسازی چهار بردار کلید ایندکسور به یک بردار استفاده میکند. در مقابل، Qwen از QSA (در سطح میکرو-بلاک) برای امتیازدهی به بلوکهای ۴ توکنی استفاده کرده و ۵۱۲ بلوک برتر (دقیقاً ۲۰۴۸ توکن) را حفظ میکند.
- گسترش جریان باقیمانده: هر دو تیم استاندارد جریان باقیمانده تکگانه سال ۲۰۱۷ را رها کرده و از چهار جریان موازی با کنترل گیتدار استفاده کردهاند. GLM از اتصالات هایپر-محدود به منیفولد (mHC) شرکت DeepSeek بهره میبرد، در حالی که Qwen از طراحی اختصاصی "Gated Residual" خود استفاده میکند.
- بهینهسازی آموزش: هر دو از بهینهساز Muon استفاده کرده و ماتریسهای ادغامشده را پیش از متعامدسازی (Orthogonalization) جدا کردند. تیم Qwen بهطور خاص اشاره کرد که حذف مرحله گرمکردن (Warm-up) اندازه دسته (Batch Size)، ۱۸.۸ درصد از گامهای بهینهساز را بدون کاهش عملکرد ذخیره کرده است.
اختلاف در رمزگذاری موقعیت
یک نقطه اختلاف کلیدی در مورد رمزگذاری موقعیت (Positional Encoding) وجود دارد. مدل GLM-5.3-Flash رمزگذاری موقعیت چرخشی (RoPE) را در لایههای توجه کامل حذف کرده (با تنظیم qk_rope_head_dim = 0) و از رویکرد NoPE (بدون رمزگذاری موقعیت) استفاده میکند که در آن دادههای موقعیت از طریق لایههای خطی بازگشتی جریان مییابند.
در مقابل، تیم Qwen همچنان RoPE را حفظ کرده است. گزارشهای فنی Qwen نشان میدهد که رویکرد NoPE اگرچه در پیشآموزش تفاوتی ایجاد نکرد، اما باعث شد مدلها پس از همراستاسازی (Alignment) و آموزش تقویتشده با بازخورد انسانی (RLHF)، نتوانند تولید متن را متوقف کنند. این موضوع نشان میدهد که منحنیهای زیان در پیشآموزش ممکن است نقصهای رفتاری را پنهان کنند که تنها پس از همراستاسازی آشکار میشوند.
دیدگاههای صنعت درباره توجه خطی
این روند معماری تنها محدود به دو تیم نیست. DeepSeek پیشگام استفاده از ایندکسرهای پراکنده و بودجه ۲۰۴۸ توکنی از طریق DSA در مدل DeepSeek-V3.2-Exp بود و طراحی mHC را که اکنون در GLM استفاده میشود، ارائه کرد. همچنین Moonshot لایههای توجه خطی KDA را که در GLM به کار رفته، توسعه داد.
با این حال، MiniMax دیدگاهی مخالف دارد. آنها در توسعه مدل M2 دریافتند که در استدلالهای چندمرحلهای (Multi-hop) وقتی زمینه از ۳۲ هزار توکن فراتر میرود، نقصهای شدیدی پس از SFT رخ میدهد. به همین دلیل، M2 در تمام لایهها از توجه سافتمکس (Softmax) کامل استفاده میکند. برای مدل M3، آنها از توجه پراکنده MiniMax (MSA) برای سبک کردن سافتمکس از طریق انتخاب بلوک استفاده کردند، اما بهطور کامل از لایههای توجه خطی اجتناب کردند.
عملکرد و زیرساخت
به گزارش Z.ai، مدل GLM-5.3-Flash در شاخص Intelligence Index v4.1.1 (نسخه ۴.۱.۱) امتیاز ۵۷ کسب کرد، در حالی که هزینه هر تسک (پس از تخفیفها) ۰.۰۴۵ دلار بود. Z.ai ادعا میکند این سطح از هوش قبلاً ۱۰ برابر گرانتر بود. در محکهای کدنویسی و عاملها، این مدل در DeepSWE v1.1 به امتیاز ۶۳.۴ رسید (در مقابل ۴۶.۲ برای GLM-5.2) و در AutomationBench امتیاز ۴۸.۸ را کسب کرد (در مقابل ۲۶.۲ برای GLM-5.2). Z.ai ادعا میکند این نتایج به سطح Claude Opus 4.8 نزدیک شده است؛ هرچند این اعداد توسط شخص ثالث تأیید نشدهاند.
سرعت ۲۰۰ توکن در ثانیه تنها نتیجه وزنها نیست، بلکه حاصل یک پشته سختافزاری است. Z.ai این مدل را بهصورت ناشناس با نام "ox-alpha" در OpenRouter و OpenCode تست کرد و به پرمصرفترین مدل هفته تبدیل شد. شرکت فاش کرد که این ترافیک روی هزاران شتابدهنده (Accelerator) بومی چینی اجرا شده است. آنها با بهینهسازی سرویسدهی سرتاسری (End-to-End)، به کارایی ۳ برابری نسبت به خط پایه اولیه رسیدند و توانستند با عملکرد و هزینه هر توکن در GPUهای انویدیا برابری کنند.
هشدارهای استقرار
کاربران باید بدانند که سرعت واقعی API بسته به میزبان بهشدت متفاوت است. بررسیهای eesel نشان داد در حالی که نقطه اتصال Z.ai با سرعت ۴۹ توکن در ثانیه اجرا میشد (که به عنوان یکی از کندترین نقاط توسط Artificial Analysis شناخته شد)، همین مدل روی Databricks به ۲۷۳ توکن در ثانیه رسید.
سایر ملاحظات عبارتند از:
- حریم خصوصی: گزارشهای eesel حاکی از نبود توافقنامههای امضاشده، نبود سطوح «عدم ذخیرهسازی» (Zero-retention) و اجرای سرویس تحت قوانین حاکم بر چین است.
- میزبانی شخصی: نیازهای سختافزاری بسیار بالاست. کوچکترین نسخه کوانتیده (UD-IQ1_S) در Hugging Face به ۹۳.۱ گیگابایت VRAM نیاز دارد، در حالی که نسخه UD-Q4_K_XL به ۱۹۹.۷ گیگابایت حافظه نیاز دارد. نسخه BF16 به ۶۴۱.۶ گیگابایت حافظه میرسد.
این همگرایی معماری بین Z.ai و Qwen نشان میدهد که صنعت در حال رسیدن به یک «فرمول برنده» برای مدلهای کارآمد با زمینه طولانی است. نبرد واقعی اکنون از تعداد پارامترها به همافزایی بین توجه پراکنده و سختافزارهای تخصصی منتقل شده است.
گام بعدی شما
- اگر تأخیر (Latency) گلوگاه اصلی اپلیکیشن شماست، مدل FlashX را در مقایسه با مدلهای رایگان تست کنید تا تفاوت سرعت را بسنجید.
- برای استقرار شخصی، ابتدا میزان VRAM در دسترس خود را با نسخههای کوانتیده در Hugging Face تطبیق دهید.
- در صورت استفاده برای دادههای حساس، سیاستهای ذخیرهسازی دادههای Z.ai را بررسی کنید.



گفتگو