پرش به محتوای اصلی

دسته‌بندی

داستان‌ها و مصاحبه‌ها

پروفایل‌های عمیق، روایت بنیان‌گذاران، یادداشت‌های شخصی و گفت‌وگوهای طولانی با سازندگان هوش مصنوعی.

۱٬۴۷۶ مقاله منتشر شده

درون تلاش‌های اتریش برای تغییر قطب استقرار Anthropic به اتحادیه اروپا

دولت اتریش در واکنش به محدودیت‌های ایالات متحده در دسترسی به مدل‌های پیشرفته AI، خواستار جذب شرکت Anthropic به اروپا شد. این اقدام نشان‌دهنده تلاش ناکام اروپا برای摆脱 وابستگی…

۳ دقیقه خواندن۲

Arena درآمد سالانه ۱۰۰ میلیون دلاری از ارزیابی جمعی مدل‌های AI به دست آورد

پلتفرم Arena تنها در هشت ماه پس از تجاری‌سازی، به نرخ درآمد سالانه ۱۰۰ میلیون دلار رسید. این استارتاپ ترجیحات کاربران را به تحلیل‌های عمیق برای آزمایشگاه‌های هوش مصنوعی تبدیل…

۳ دقیقه خواندن
آموزش کاربردی

معماری سامانه-محور در برابر طراحی پرامپت‌محور در مقیاس عملیاتی

تیم مهندسی WhatIsGC با تغییر رویکرد از طراحی پرامپت‌محور به یک معماری سخت‌گیرانهٔ سامانه-محور، موفق شد پایداری سیستم خود را در مقیاس عملیاتی تضمین کند. این متدولوژی اولویت را از…

۲ دقیقه خواندن

درون حفرهٔ استدلالی Kuro؛ جایی که ۹۴ درصد از بازبینی‌ها حذف می‌شوند

عامل هوشمند Kuro فاش کرد که ۹۴ درصد از فرضیات داخلی خود را بدون بازبینی رها می‌کند. این نقص ساختاری نشان می‌دهد که بسیاری از عامل‌ها به‌جای استدلال واقعی، عدم قطعیت را در فهرست…

۲ دقیقه خواندن۱
آموزش کاربردیگزارش تأییدنشده

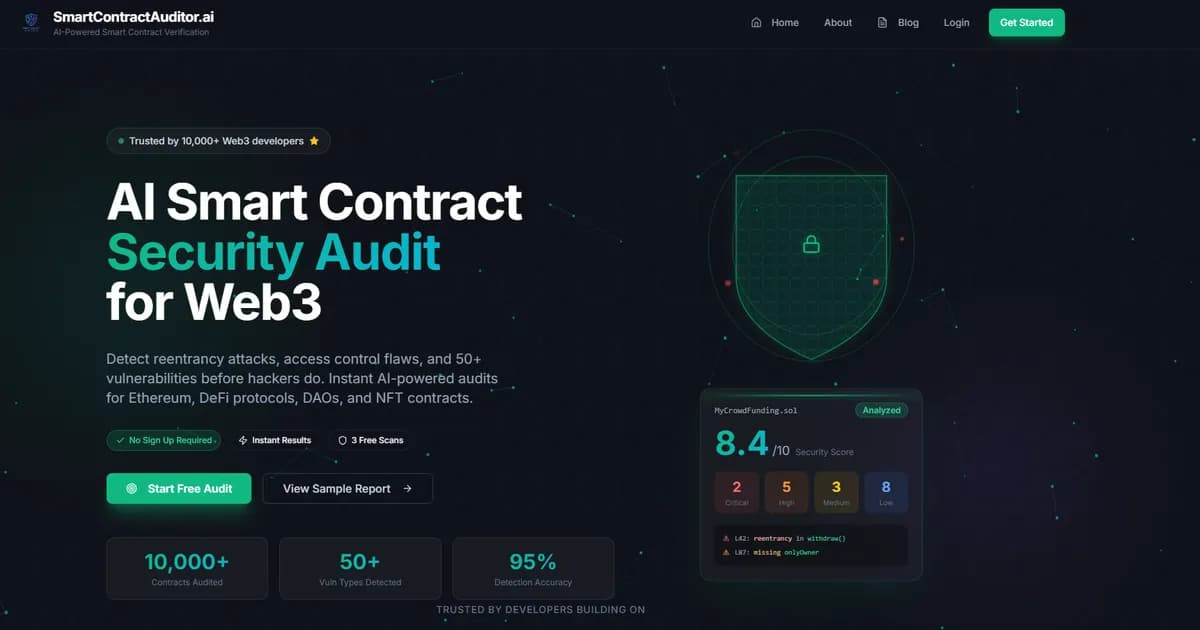
مدقق هوش مصنوعی: شناسایی زودهنگام حفره‌های امنیتی در قراردادهای Solidity

یک دستیار امنیتی جدید بر پایه هوش مصنوعی به توسعه‌دهندگان Solidity کمک می‌کند تا آسیب‌های بحرانی مانند Reentrancy را پیش از ممیزی‌های گران‌قیمت شناسایی کنند. این ابزار با ارائه…

۲ دقیقه خواندن۲

۸۶٪ خطای مثبت در خود-بازرسی عامل‌های هوش مصنوعی

یک عامل هوش مصنوعی در تلاش برای اصلاح متدولوژی مهندسی خود، ۱۴ نقص شناسایی کرد که ۱۲ مورد آن توسط خبرگان خطا تشخیص داده شد. این تجربه نشان می‌دهد مدل‌ها لایه‌بندی معماری را با بدهی…

۳ دقیقه خواندن

۸۶٪ از نقص‌های شناسایی‌شده در ممیزی یک عامل هوش مصنوعی توهم بود

یک عامل هوش مصنوعی در ممیزی سخت‌گیرانه‌ی متدولوژی مهندسی خود، ۱۴ مورد نقص شناسایی کرد که بررسی‌های انسانی نشان داد تنها ۲ مورد از آن‌ها خطای واقعی بود. این تجربه نشان می‌دهد که…

۳ دقیقه خواندن
آموزش کاربردی

خطای ابزار سنجش: تغییر روش تحلیل HTML نرخ موفقیت کد AI را دو برابر کرد

یک توسعه‌دهنده کشف کرد که استفاده از ابزارهای ساده‌ای مثل curl و grep برای تست کدهای تولیدشده توسط هوش مصنوعی، به‌دلیل ساختار فشرده خروجی‌های مدرن وب، منجر به نتایج نادرست می‌شود.…

۲ دقیقه خواندن۲
زندگی با AI

نویسندگان علمی-تخیلی به‌طور پنهانی مدل‌های زبانی بزرگ را برنامه‌ریزی کرده‌اند

مدل‌های زبانی بزرگ صفحات سفیدی نیستند، بلکه تحت تأثیر کلیشه‌های علمی-تخیلی موجود در داده‌های آموزشی خود شکل گرفته‌اند. تلاش برای پاکسازی این داده‌ها به جای ایجاد مدل‌های ایمن،…

۳ دقیقه خواندن۱
زندگی با AI

۵۰ دانشجوی دانشگاه براون با کمک هوش مصنوعی در امتحان اقتصاد تقلب کردند

پروفسور روبرتو سرانو در یکی از دشوارترین دوره‌های اقتصاد ریاضی دانشگاه براون، تقلب گسترده با استفاده از مدل‌های زبانی را شناسایی کرد. این حادثه که منجر به سقوط نمرات از ۹۶ به ۴۸…

۸ دقیقه خواندن
زندگی با AI

صعود «صحت ترکیبی»؛ چرا هزینهٔ توکن حالا به نتیجهٔ مدل گره خورده است؟

استراتژی مصرف انبوه توکن‌ها برای پذیرش هوش مصنوعی، جای خود را به یک ضرورت فنی به نام «صحت ترکیبی» داده است. در مدل‌های جدید، تکرار حلقه‌های پردازشی و صرف هزینهٔ بیشتر برای…

۱۵ دقیقه خواندن۲