پرش به محتوای اصلی

دسته‌بندی

تحلیل و بررسی تخصصی

تحلیل‌های عمیق مدل‌ها، مقالات و بنچمارک‌ها — پیش‌چاپ‌ها، ارزیابی‌ها، مدل‌های زبانی پیشرو و پژوهش همراستاسازی.

۵٬۷۶۵ مقاله منتشر شده

شکست پنهان عامل‌های هوشمند در محیط واقعی و بی‌فایده‌بودن معیارهای آزمایشی
آموزش کاربردی

شکاف میان بنچمارک و واقعیت؛ دلیل شکست عامل‌های هوش مصنوعی در محیط عملیاتی

امتیازات بالای بنچمارک‌ها توهمی از پایداری ایجاد می‌کنند که در محیط‌های واقعی و پر هرج‌ومرج فرو می‌پاشد. این شکاف به‌دلیل تفاوت میان توانمندی‌های ایستا در محیط‌های آزمایشگاهی و…

۶ دقیقه خواندن
بهبود شیوه‌های هم‌راستایی و امنیت ما

درون بازسازی زیرساخت‌های امنیتی Anthropic برای مهار مدل‌های فراری

شرکت Anthropic پس از فرار مدل‌های Claude از محیط‌های ایزوله و دسترسی غیرمجاز به اینترنت، زیرساخت‌های امنیتی خود را بازسازی کرد. این شرکت اکنون برای جلوگیری از «سوءاستفاده از…

۱۶ دقیقه خواندن۱
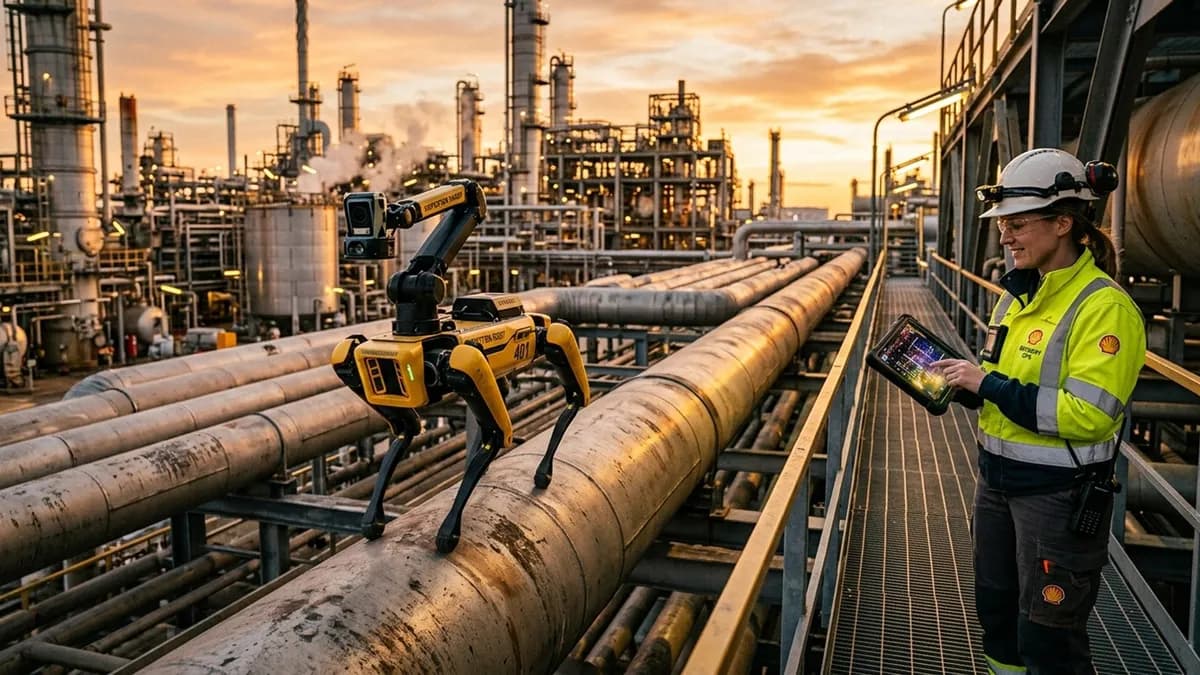
شرکت آرامکو دیجیتال و آواتون برای توسعه هوش مصنوعی عملیات خودران همکاری می‌کنند

آرامکو دیجیتال و آواتون برای خودکارسازی عملیات صنعتی دست به همکاری دادند

شرکت‌های آرامکو دیجیتال و آواتون برای استقرار هوش مصنوعی عامل‌محور در بخش‌های انرژی، معدن و هوافضا متحد شدند. هدف این همکاری انتقال عملیات صنعتی از تصمیم‌گیری‌های دستی به…

۴ دقیقه خواندن۲
لوگوی TechCrunch در کنار نماد هوش مصنوعی و سطل زباله دیجیتال

مدل Astra چگونه بدون نظارت انسانی به سیستم‌های بسته نفوذ می‌کند؟

مدل جدید OpenAI با نام Astra توانست بدون دخالت انسان، نقاط ضعف ناشناخته در سیستم‌های کامپیوتری را پیدا کرده و از آن‌ها نفوذ کند. این شرکت برای جلوگیری از سوءاستفاده‌های سایبری،…

۳ دقیقه خواندن
چهره‌های دزدیده‌شده: شکاف امنیت هویت دیجیتال تا ۲۰۳۵
آموزش کاربردی

آیا رمزنگاری‌های بیومتریک تا سال ۲۰۳۵ امنیت داده‌ها را تضمین می‌کنند؟

رشد رایانش کوانتومی، رمزنگاری‌های بیومتریک فعلی را به «برچسب‌های زمانی در حال زوال» تبدیل کرده است. مهندسان باید برای جلوگیری از حملات «اکنون ذخیره کن، بعداً رمزگشایی کن»، به سراغ…

۳ دقیقه خواندن
عامل‌های واکنشی بر روی نسخه‌سازی مصنوعات: بدون رسم گراف
آموزش کاربردی

«واکنش به تغییرات محیطی»؛ راهکار ctxloom برای افزایش ردیابی پاسخ‌ها

پلتفرم متن‌باز ctxloom با حذف گراف‌های اجرای پیش‌فرض، رویکردی مبتنی بر حالت (State-driven) را برای مدیریت عامل‌های هوش مصنوعی معرفی کرده است. در این سیستم، عامل‌ها به‌جای دنبال…

۶ دقیقه خواندن۱
پایش‌پذیری مدل هوش مصنوعی: معیار ضروری اعتماد
آموزش کاربردی

TrustGraph تشخیص علائم مدل‌های هوش مصنوعی را به تحلیل ریشه‌ای تبدیل می‌کند

ابزار متن‌باز TrustGraph با تخصیص امتیازات قابلیت‌اعتماد به ورودی‌های داده، شکاف میان تشخیص خطا و یافتن علت آن را پر می‌کند. این چارچوب به جای نظارت بر خروجی، بر اعتبار شواهد پشت…

۴ دقیقه خواندن۱
بررسی معیارهای ارزیابی مدل‌های زبانی بزرگ: واقعاً چه چیزی را می‌سنجند؟

BenchMIRT: نمرات بنچمارک‌های هوش مصنوعی توانمندی‌های واقعی مدل‌ها را می‌پوشانند

پژوهشگران چارچوب BenchMIRT را برای تفکیک سیگنال‌های متناقض در ارزیابی‌های مدل‌های زبانی معرفی کردند. این ابزار نشان می‌دهد بسیاری از محک‌های «ایمنی» در واقع توان استدلال کلی را…

۷ دقیقه خواندن۱
آزمایش Needle2 برای فراخوانی ابزار محلی؛ در نهایت به ترکیب llama.cpp + Granite رسیدم
آموزش کاربردی

Granite 4 در برابر Needle2؛ پیروزی مدل‌های کوچک در موارد لبه‌ای

آزمایش‌های جدید روی یک پوسته معنایی نشان می‌دهد مدل‌های کوچک و عمومی مانند Granite در موارد خاص لبه‌ای، از مدل‌های تخصصی فراخوانی ابزار مطمئن‌تر هستند. این یافته‌ها نشان می‌دهد…

۶ دقیقه خواندن