پرش به محتوای اصلی

دسته‌بندی

تحلیل و بررسی تخصصی

تحلیل‌های عمیق مدل‌ها، مقالات و بنچمارک‌ها — پیش‌چاپ‌ها، ارزیابی‌ها، مدل‌های زبانی پیشرو و پژوهش همراستاسازی.

۶٬۸۳۸ مقاله منتشر شده

آموزش کاربردی

درون Patter SDK؛ مدل‌سازی جریان‌های کاری تلفنی پیش از اتصال واقعی

کیت توسعه Patter SDK ابزاری برای شبیه‌سازی، آزمایش و استقرار عامل‌های صوتی هوش مصنوعی با تمرکز بر مدیریت تأخیر و حفاظ‌های ایمنی است. این چارچوب به توسعه‌دهندگان اجازه می‌دهد پیش…

۱۴ دقیقه خواندن۱

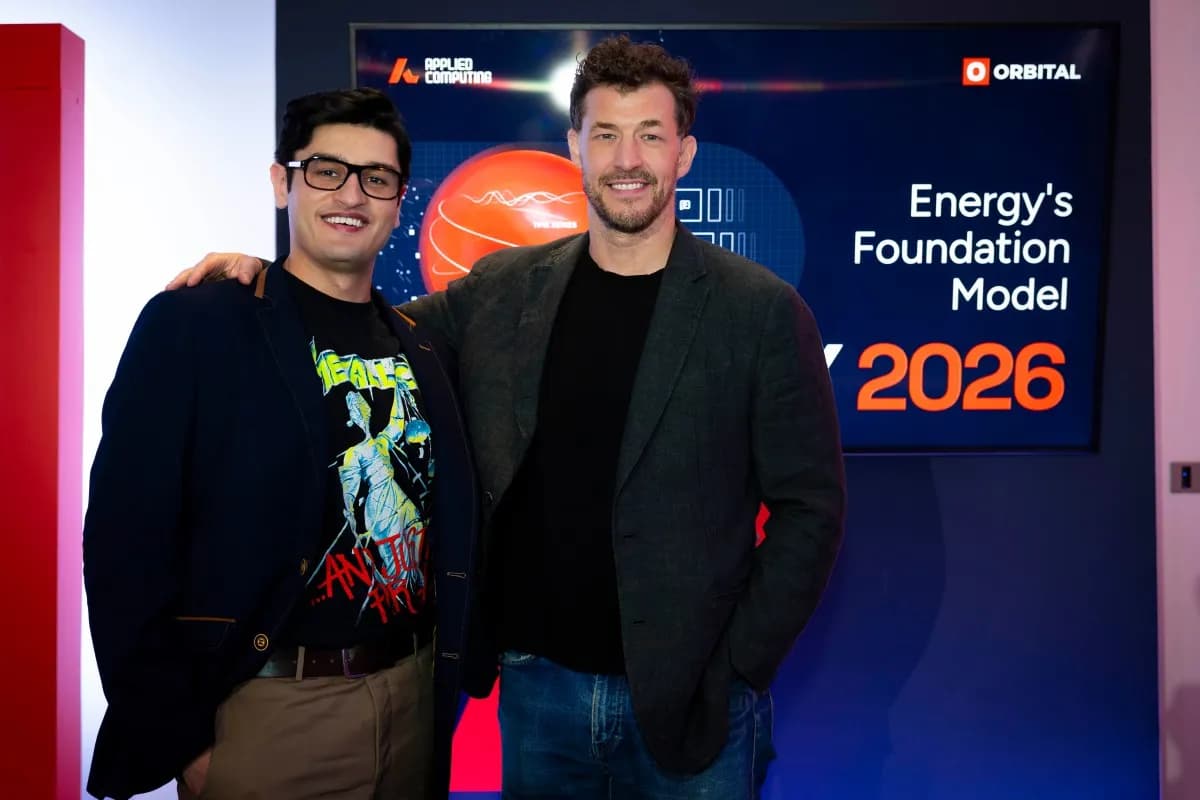
Applied Computing با جذب ۲۰ میلیون دلار، مدل بنیادی Orbital را برای صنایع نفت و

استارتاپ Applied Computing سرمایه‌ای ۲۰ میلیون دلاری برای توسعه Orbital جذب کرد. این مدل بنیادی با ترکیب داده‌های حسگر، قوانین فیزیک و مستندات فنی، مدیریت پالایشگاه‌ها و تأسیسات…

۴ دقیقه خواندن۱

کرنل‌های Triton سرعت استنتاج مدل‌های کم‌رتبه را ۳.۷۶ برابر کرد

پژوهشگران با طراحی کرنل‌های سفارشی Triton، گلوگاه‌های حافظه‌ای در فشرده‌سازی مدل‌های Block Low-Rank را برطرف کردند. این بهینه‌سازی‌ها سرعت استنتاج را در سخت‌افزارهای محدود مانند…

۳۶ دقیقه خواندن

برنامه‌ریزی پیش‌دستانه در برابر توجیه‌های لحظه‌ای در مدل‌های زبانی

تحلیل رفتار مدل‌های زبانی نشان می‌دهد که تفاوت عمیقی میان فرآیند تصمیم‌گیری داخلی و توضیحات بیرونی آن‌ها وجود دارد. در حالی که مدل‌هایی مثل Claude قادر به برنامه‌ریزی پیش‌دستانه…

۹ دقیقه خواندن۲

رمزنگاری هم‌ریخت در برابر LLM؛ تقابل امنیت مطلق و سرعت پردازش

رمزنگاری کاملاً هم‌ریخت (FHE) امکان پردازش داده‌های رمزگذاری‌شده بدون نیاز به رمزگشایی را فراهم می‌کند، اما سربار محاسباتی عظیم آن، استنتاج در مدل‌های زبانی بزرگ را فعلاً غیرممکن…

۶ دقیقه خواندن

آیا معماری HBF می‌تواند گلوگاه‌های حافظه‌ای مدل‌های زبانی بزرگ را برطرف کند؟

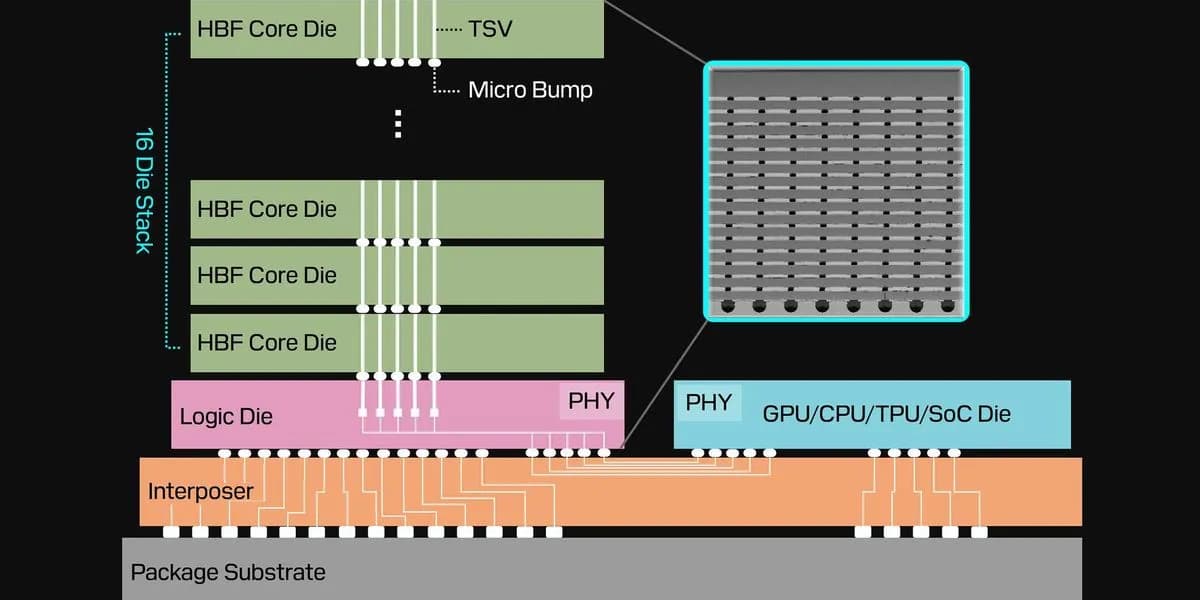
دو غول حافظه با معرفی معماری High Bandwidth Flash (HBF) قصد دارند گلوگاه‌های حافظه‌ای مدل‌های عظیم هوش مصنوعی را برطرف کنند. این فناوری با کاهش وابستگی به حافظه‌های گران‌قیمت HBM،…

۵ دقیقه خواندن
آموزش کاربردی

سامانه‌های توزیع‌شدهٔ عامل‌محور زمان پرس‌وجوهای حجیم را از ۴۰ دقیقه به ۹۰ ثانیه

تغیری بنیادین در معماری هوش مصنوعی، دستیاران یکپارچه را با سامانه‌ای چهارلایه جایگزین کرده تا پرس‌وجوهای در مقیاس پتابایت را مدیریت کند. این رویکرد با تجزیهٔ درخواست‌های پیچیده به…

۲۳ دقیقه خواندن۱
آموزش کاربردی

۵۹٪ از سخت‌ترین آزمون‌های SWE-bench Verified به‌دلیل خطاهای فنی شکست خوردند

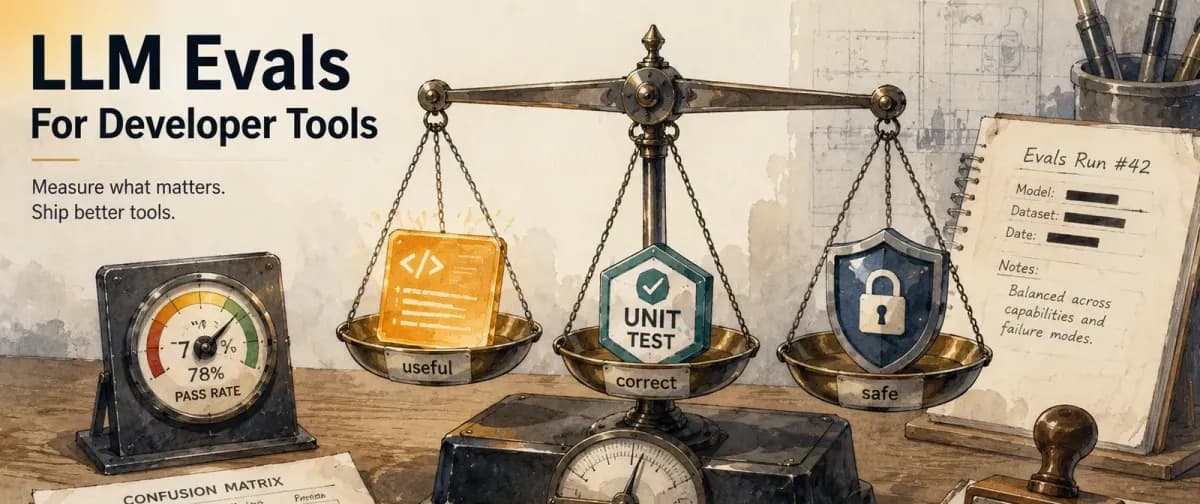
تحلیل‌های جدید نشان می‌دهد بنچمارک‌های کدنویسی به‌جای سنجش مهارت مهندسی، حافظه مدل‌ها را اندازه می‌گیرند. تیم‌های توسعه برای ارزیابی واقعی باید سه محور مستقلِ صحت، کاربردی بودن و…

۱۹ دقیقه خواندن۱