پرش به محتوای اصلی

موضوع

عامل‌محور

Autonomous agents, tool use, planning, multi-step workflows

۷٬۳۳۲ مقاله منتشر شده

آموزش کاربردی

چرا برای ساخت عامل‌های هوش مصنوعی نیازی به فریم‌ورک‌های پیچیده نیست؟

یک آزمایش ساده با مدل Gemma 4 نشان داد که برای ایجاد رفتارهای پیچیده و تغییر موضوع در گفتگو، نیازی به ابزارهای سنگین مدیریت عامل‌ها نیست. این یافته ثابت می‌کند که وزن‌های داخلی…

۸ دقیقه خواندن
آموزش کاربردیتأییدنشده · منبع منفرد

ترکیب Tailscale و tmux: سازوکار ارسال کد تولیدی از آیفون با عامل‌های هوش مصنوعی

یک توسعه‌دهنده روشی را منتشر کرد که در آن آیفون را به ترمینالی برای مدیریت عامل‌های کدنویسی تبدیل می‌کند. این سیستم با استفاده از یک مک به عنوان سرور SSH و ابزارهای شبکه، اجازه…

۵ دقیقه خواندن
آموزش کاربردی

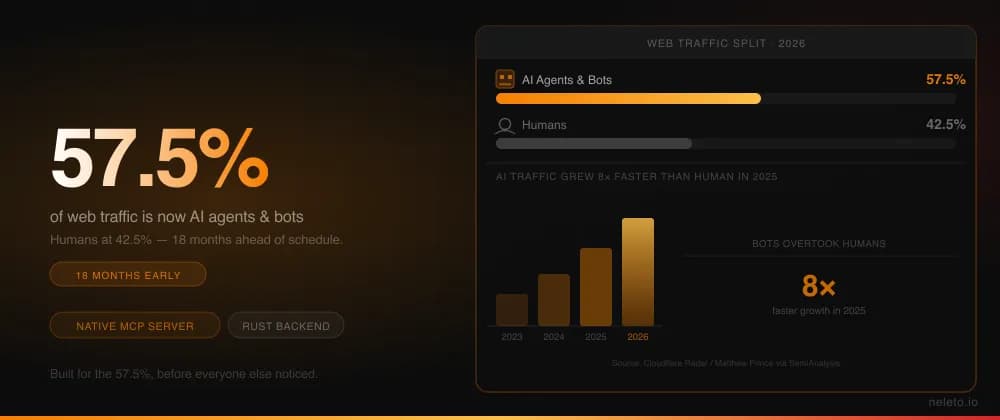
چرخش در ترافیک وب: چرا سئو از جذب انسان به اقدام عامل‌ها تغییر می‌کند؟

عامل‌های هوش مصنوعی اکنون با ۵۷.۵٪ از درخواست‌های وب، جایگاه انسان‌ها را به عنوان بازدیدکننده اصلی اینترنت گرفته‌اند. این تغییر، ضرورت گذار از طراحی‌های بصری به محتوای ساختاریافته…

۶ دقیقه خواندن

چرا عامل‌های هوش مصنوعی باعث تورم هزینه‌های ابری می‌شوند و Lakebase چه می‌کند؟

شرکت Databricks ابزاری به نام Lakebase معرفی کرد تا هرج‌ومرج زیرساختی ایجاد شده توسط عامل‌های خودکار را مهار کند. این دیتابیس با استفاده از قابلیت شاخه‌بندی و محاسبات صفر-پذیر،…

۱ دقیقه خواندن

AHA-WAM: کاهش ۴.۵۹ برابری تأخیر در کنترل رباتیک با مدل‌سازی نامتقارن جهان

چارچوب AHA-WAM با جداسازی پیش‌بینی جهان از اجرای عملیات، تأخیر کنترل بسته-حلقه در ربات‌ها را ۴.۵۹ برابر کاهش داده است. این معماری مبتنی بر ترنسفورمرهای انتشار دوگانه، امکان کنترل…

۲ دقیقه خواندن۲

چرا نمرات «شروع سرد» برای سنجش قابلیت یادگیری عامل‌های VLM کافی نیستند؟

پژوهشگران بنچمارک OmniGameArena را برای اندازه‌گیری نحوه بهبود عامل‌های مدل زبانی-دیداری از طریق بازتاب خودکار معرفی کرده‌اند. برخلاف تابلوهای امتیازات ایستا، این سیستم مسیر…

۱ دقیقه خواندن

انتقال کنترل از خط‌مبنا به شبکه عصبی؛ راهکاری برای حذف آزمون-خطای پرهزینه در RL

یک تکنیک جدید در یادگیری تقویت‌شده (RL) با جایگزینی آموزش «از صفر» با انتقال تدریجی کنترل از یک خط‌مبنای عملیاتی به شبکه عصبی، هزینه‌های محاسباتی را کاهش می‌دهد. این روش نرخ رسیدن…

۲ دقیقه خواندن

DARP: افزایش ۴۶ درصدی تعمیم‌پذیری در یادگیری تقلیدی با رویکرد بازیابی محلی

رویکرد DARP با جایگزینی سیاست‌های سراسری با ساختارهای بازیابی محلی، خطاهای انباشته در حالت‌های خارج از توزیع را کاهش می‌دهد. این متد منجر به بهبود ۱۵ تا ۴۶ درصدی عملکرد در کنترل…

۱ دقیقه خواندن

چرا یادگیری تقویت‌شده چندعاملی جایگزین محاسبات هندسی در حمل‌ونقل رباتیک می‌شود؟

یک چارچوب جدید یادگیری تقویت‌شده چندعاملی (MARL)، تیم‌های رباتیک را قادر می‌سازد تا اجسام با هر شکل و توزیع جرم نامتقارن را به‌طور خودگردان جابه‌جا کنند. این سیستم با ادغام کنترل…

۱ دقیقه خواندن

سازه ReCoVLA: تبدیل VLM به انتخابگر پاداش برای بازیابی خطاهای رباتیک

چارچوب ReCoVLA با استفاده از مدل‌های چندوجهی برای هدایت پاداش‌ها، توانایی ربات‌ها در بازیابی از شکست‌ها را بدون نیاز به بازآموزی سیاست اصلی افزایش می‌دهد. این روش نرخ موفقیت…

۱ دقیقه خواندن