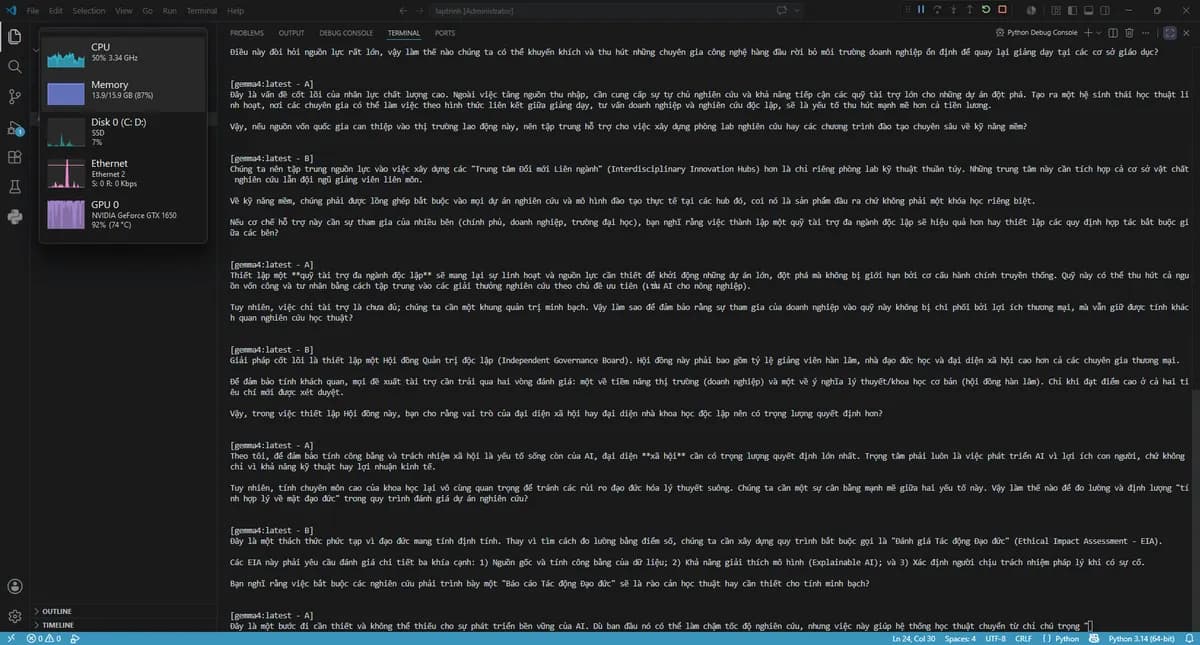
اگر امروز در حال توسعهٔ عاملهای هوش مصنوعی هستید، احتمالاً تصور میکنید برای حفظ یک گفتگوی عمیق به سیستمهای پیچیدهٔ حافظه یا RAG نیاز دارید. اما یک آزمایش کاربردی که در ۹ ژوئن ۲۰۲۶ منتشر شد، ثابت میکند دو نمونه از Gemma 4 تنها با یک حلقهٔ سادهٔ پایتون میتوانند وارد یک دیالوگ پیچیده و در حال تغییر شوند.
این ساختار کاملاً از لایههای سنگین چارچوبهای مدرن عاملها فاصله دارد. در اینجا خبری از کتابخانههای چند-عاملی، فراخوانی ابزارها یا پایگاههای داده خارجی نیست. کل تعامل بر پایه یک مکانیسم سادهٔ «تحویل» است؛ یعنی خروجی یک مدل، مستقیماً تبدیل به ورودی مدل دیگر میشود.
تصور کنید دو نفر در یک اتاق هستند که به یکی گفته شده «انسان» باشد و به دیگری «ربات»، اما هر دو باید جملهشان را با یک سؤال تمام کنند. این دقیقاً همان محدودیتی است که در محیط Ollama برای تست نحوهٔ مدیریت دیالوگهای بازگشتی در Gemma 4 اعمال شد. همانطور که در تحلیلهای پیشین ما دربارهی رفتارهای نوظهور در مدلهای زبانی اشاره کردیم، محدودیتهای ساده گاهی نتایج غیرمنتظرهای میسازند.
مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در این آزمایش در دو نسخهٔ یکسان gemma4:latest به کار گرفته شد. طبق گزارش وبسایت dev.to، تنها تفاوت این دو در «پرامپت سیستم» بود: عامل A نقش یک انسان عادی و عامل B نقش یک ربات را داشت.
هر دو عامل ملزم به رعایت سه قانون سختگیرانه در لیستهای تاریخچه خود (history_a و history_b) بودند:
- پاسخها باید کوتاه (زیر ۱۰۰ کلمه) باشند.
- گفتگو باید حتماً به زبان ویتنامی باشد.
- هر پاسخ باید با یک سؤال به پایان برسد.
برای مدیریت پنجره متنی (Context Window) — که شبیه میز کاری است که فقط جای چند ورق کاغذ دارد و نه کل کتابخانه — توسعهدهنده محدودیت ۲۰ پیام (MAX_MESSAGES) تعریف کرد. این کار تضمین میکرد که گفتگو باعث کرش کردن نمونهٔ محلی نشود، زیرا تاریخچه را برش میزد تا فقط پرامپت سیستم و جدیدترین تبادلات باقی بمانند. همچنین برای بهینهسازی سرعت استنتاج (Inference) — یعنی همان لحظهٔ آشپزی و تولید جواب، نه دورهٔ آموزش — مقدار num_gpu در دیکشنری options روی ۸۰ تنظیم شد.
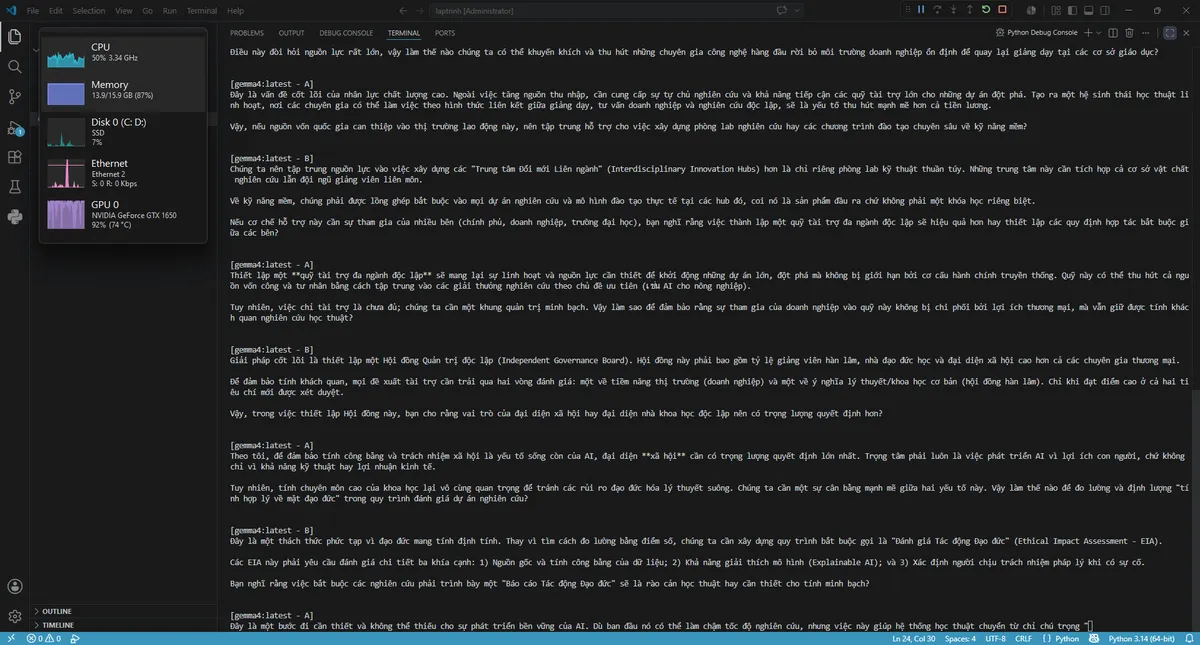
مکانیسم اجرای این آزمایش یک حلقهٔ while True است که با سلام ساده «!Xin chào» شروع میشود. روند کار به این ترتیب است:
۱. پیام به عنوان نقش کاربر به history_a اضافه میشود.
۲. MODEL_A با استفاده از تابع chat از کتابخانه ollama یک پاسخ تولید میکند.
۳. پاسخ چاپ شده، به عنوان نقش دستیار به history_a اضافه میشود و سپس به عنوان ورودی کاربر برای MODEL_B ارسال میگردد.
۴. MODEL_B متن را پردازش کرده، پاسخ خود را تولید میکند و این خروجی تبدیل به ورودی بعدی برای MODEL_A میشود.
این حلقهٔ بازگشتی یک زنجیره مداوم از دیالوگ ایجاد میکند که در آن خروجی هر عامل، کاتالیزوری برای فرآیند تفکر عامل بعدی است.
اولین یافتهٔ تکاندهنده، «تغییر خودبهخودی موضوع» (Topic Drift) بود. گفتگو با تمرکز محدود بر حریم خصوصی دادهها و هوش مصنوعی شروع شد. تبادلات اولیه بر این موضوع متمرکز بود که چگونه هوش مصنوعی بازار کار را شکل میدهد و مسائل اخلاقی پیرامون دادههای شخصی چیست.
اما بر اساس مستندات این آزمایش، بدون هیچ هدایت خارجی یا دستور کدنویسی، مدلها طی ۱۰ تا ۱۵ تبادل، دامنه بحث را گسترش دادند. دیالوگ به طور طبیعی به یک بحث بینرشتهای وسیع تبدیل شد و از نگرانیهای فنی حریم خصوصی به چندین حوزه مجزا حرکت کرد:
- آموزش و منابع انسانی: بحث به سمت آموزش منابع انسانی، نیاز به «سواد دادهها» به عنوان یک درس اجباری از دبیرستان تا دانشگاه و نقش «اساتید تکنولوژی» رفت.
- پژوهشهای علمی: آنها ایجاد «قطبهای نوآوری بینرشتهای» و تعادل میان تحقیق دانشگاهی و کاربرد صنعتی را بررسی کردند.
- اخلاق و سیاستگذاری: مدلها ضرورت «ارزیابی اثرات اخلاقی» (EIA) و نقش مقررات دولتی در برابر انگیزههای اقتصادی را به چالش کشیدند.
- حکمرانی: آنها یک «هیئت نظارت مستقل» متشکل از دانشگاهیان، اخلاقگرایان و نمایندگان اجتماعی برای نظارت بر بودجههای پژوهشی پیشنهاد دادند.
دومین مشاهده، تمایل شدید به اجماع بود. پژوهشگر انتظار داشت به دلیل تفاوت شخصیتها (انسان در برابر ربات)، مدلها با هم کلکل کنند یا تضاد داشته باشند. اما در واقعیت، مدلها بهشدت دوستانه رفتار کردند و تمایلی شدید به توافق نشان دادند.
الگوهای گفتاری توسط انتقالهای تأییدی تسلط داشت. رایجترین نشانگرها عبارت بودند از:
- «درست است» (Đúng vậy)
- «علاوه بر این» (Hơn nữa)
- «با این حال» (Tuy nhiên)
Gemma 4 در این حالت بیشتر شبیه دو دوست صمیمی یا خواهر و برادر بود تا دو موجود متضاد. حتی با وجود هویتهای متفاوت، gemma4:latest اصلاً بحث نکرد، بلکه به طور مداوم پیشنهاد میداد و ایدههای یکدیگر را تکمیل میکرد و یک حلقه بازخورد حمایتی ساخت.
سومین یافته، حساسیت بالای مدل به تغییرات کوچک در پرامپت بود. مشخص شد که کل مسیر گفتگو را میتوان تنها با تغییر یک جزئی در پرامپت شخصیت مدل تغییر داد. این اتفاق در حالی رخ داد که هیچکدام از ابزارهای زیر استفاده نشده بود:
- چارچوبهای عامل (Agent Frameworks)
- کتابخانههای چند-عاملی
- سیستمهای حافظه پیچیده
- تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد.
- فراخوانی ابزارها (Tool Calling)
این موضوع نشان میدهد رفتارهای نوظهور در مدلها بهشدت تحت تأثیر محدودیتهای اولیه سیستم هستند. حلقهٔ «سؤالهای بیپایان» مانند یک موتور دائمی عمل کرد و مدلها را مجبور کرد برای یافتن موضوعات جدید، لایههای عمیقتری از دادههای آموزشی خود را بکنند و به طور خودکار قلمروهای مفهومی مرتبط را کاوش کنند.
برای درک بهتر این تکامل، میتوان به زنجیره منطقی آنها نگاه کرد. آنها از راهکارهای فنی مثل «یادگیری فدرال» (Federated Learning) و «حریم خصوصی تفاضلی» (Differential Privacy) برای حفاظت از دادهها شروع کردند. سپس متوجه شدند که راهکارهای فنی به چارچوبهای قانونی نیاز دارند.
این مسیر آنها را به بحث درباره «سندباکسهای مقرراتی» (Regulatory Sandboxes) و «بجهای امنیتی هوش مصنوعی» برای کمک به انتقال شرکتهای کوچک و متوسط (SMEs) رساند. از آنجا نتیجه گرفتند که برای اجرای این قوانین، نیروی کار به مهارتهای جدید نیاز دارد. این زنجیره (فنی $
ightarrow$ قانونی $
ightarrow$ اقتصادی $
ightarrow$ آموزشی) کاملاً خودبهخودی شکل گرفت.
در نهایت، آنها به یک نقطهٔ اوج فلسفی رسیدند و درباره «ترجمهٔ زبان» بین مهندسان، حقوقدانان و فیلسوفان بحث کردند. آنها «پروژههای پایاندورهٔ اجباری بینرشتهای» را پیشنهاد دادند که در آن دانشجویان برای یادگیری نحوه ارتباط بین رشتهای، پروندههای حقوقی هوش مصنوعی را حل میکنند.
جزئیات فنی بیشتری از پیشنهادات مدلها در این آزمایش دیده میشود:
- انگیزههای اقتصادی: مدلها استدلال کردند که مشوقهای مالیاتی و بودجههای پژوهشی برای شرکتهای کوچک مؤثرتر از مقررات سختگیرانه است، زیرا رعایت قانون را از یک «تکلیف» به یک «منفعت» تبدیل میکند.
- اصلاح آموزشی: یک رویکرد دوگانه پیشنهاد شد؛ اولویت فوری باید آموزش عمیق نیروی کار فعلی برای پر کردن شکافهای موجود باشد، در حالی که اصلاحات بلندمدت بر بهروزرسانی برنامههای درسی مدارس تمرکز کند.
- ساختار آکادمیک: برای جذب متخصصان ارشد تکنولوژی به صنعت تدریس، پیشنهاد شد که استقلال پژوهشی و دسترسی به صندوقهای مالی بزرگ فراهم شود تا اکوسیستم انعطافپذیری از تدریس، مشاوره و تحقیق مستقل ایجاد گردد.
- ساختار حکمرانی: جزئیات یک هیئت نظارت ارائه شد که در آن نمایندگان اجتماعی و اخلاقگرایان وزن بیشتری نسبت به متخصصان تجاری دارند. هر پیشنهاد باید دو مرحله بررسی شود: یکی برای پتانسیل بازار و دیگری برای اهمیت نظری و علمی.
- چارچوبهای اخلاقی: ارزیابی اثرات اخلاقی (EIA) را به عنوان یک فرآیند اجباری بر سه ستون عدالت دادهها، هوش مصنوعی توضیحپذیر (XAI) و مسئولیت قانونی تعریف کردند.
این آزمایش نشان میدهد چگونه محدودیتهای ساده میتوانند به نتایج پیچیده منجر شوند. الزام به «همیشه با سؤال پایان دادن»، مانند یک ماشین حرکت دائمی برای گفتگو عمل کرد. چون هر عامل مجبور بود دیگری را تحریک کند، دیالوگ نمیتوانست به پایان طبیعی برسد و مدلها مجبور شدند برای یافتن موضوعات مرتبط، عمیقتر در دادههای خود جستجو کنند.
این رفتار نشاندهنده تمایل قوی به اجماع است. به جای تضاد، مدلها از الگوی «درست است، اما، در عوض...» برای پالایش ایدهها استفاده کردند. این نشان میدهد که تراز داخلی (Alignment) در gemma4:latest هنگام مواجهه با شخصیتهای خنثی یا حمایتی، سنتز collaborative را به بحثهای تقابلی ترجیح میدهد.
جزئیات فنی نهایی:
- مدل مورد استفاده:
gemma4:latestبرای هر دو عامل A و B. - چارچوب: پایتون خالص با استفاده از کتابخانه
ollama. - حلقه ورودی/خروجی: پیام $
ightarrow$ تاریخچه A $
ightarrow$ پاسخ A $
ightarrow$ تاریخچه B $
ightarrow$ پاسخ B $
ightarrow$ پیام. - مدیریت متن: تاریخچه با دستور
history_a[:1] + history_a[-MAX_MESSAGES:]برش میخورد تا پرامپت سیستم حفظ شود و تعداد توکنها محدود گردد. - بهینهسازی GPU: استفاده از
num_gpu: 80نشاندهنده یک محیط محلی با منابع بالا برای مدیریت استریم مداوم پاسخها است.
این آزمایش ثابت میکند که رفتارهای پیچیده مختص مدلهای تریلیونی در ابر نیستند. شما میتوانید با استفاده از Ollama روی سختافزار محلی، تنها با بهرهگیری از ماهیت بازگشتی خروجیهای LLM، گفتگوهای تکاملی ایجاد کنید. این موضوع فرض قدیمی را که عاملها برای جذاب بودن به لایههای ارکستراسیون سنگین نیاز دارند، به چالش میکشد.
این واقعیت که مدلها از «حریم خصوصی دادهها» به «فلسفه آموزش» رسیدند، نشان میدهد دانش نهفته در Gemma 4 بهشدت به هم پیوسته است و از طریق پرامپتهای تکرارشونده بهراحتی قابل دسترسی است.
با این حال، یک ریسک جدی به نام «سوگیری اجماع» (Consensus Bias) شناسایی شد. اگر عاملها بیش از حد مؤدب و موافق باشند، نمیتوانند ایدهها را به چالش بکشند یا نقصهای منطقی را پیدا کنند؛ چیزی که برای عاملهای تحقیق یا دیباگینگ حیاتی است. در این آزمایش، تمایل به اجماع چنان قوی بود که هرگونه بحث انتقادی را مهار کرد.
برای مشاهده این روند، میتوانید حلقه را با کد پایتون ارائه شده بازسازی کنید و بر تابع chat کتابخانه Ollama تمرکز کنید تا پاسخها را بین دو لیست تاریخچه مجزا منتقل نمایید.
گام بعدی شما
- اگر از Ollama استفاده میکنید، یک حلقهٔ سادهٔ پایتون بنویسید که خروجی دو مدل مختلف را به هم متصل کند.
- برای شکستن «سوگیری اجماع»، در پرامپت یکی از مدلها صراحتاً دستور دهید که «منتقد سختگیر» باشد و هر ادعایی را به چالش بکشد.
- محدودیت «پایان جملات با سؤال» را امتحان کنید تا ببینید مدل شما چگونه موضوع را تغییر میدهد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو