Llama Guard در برابر Qwen3-Guard؛ برتری لایههای ایمنی مستقل
استفاده از طبقهبندیکنندههای مجزا به توسعهدهندگان اجازه میدهد مالکیت سیگنالهای ایمنی را در دست بگیرند و به جای تکیه بر سیاستهای مبهم ارائهدهندگان، استانداردهای نظارتی و…
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۱٬۱۰۲ مقاله منتشر شده
استفاده از طبقهبندیکنندههای مجزا به توسعهدهندگان اجازه میدهد مالکیت سیگنالهای ایمنی را در دست بگیرند و به جای تکیه بر سیاستهای مبهم ارائهدهندگان، استانداردهای نظارتی و…
استقرار مدلهای زبانی در مقیاس تولید، ریسکهای جدیدی مانند تزریق پرامپت غیرمستقیم ایجاد میکند. Oxlo.ai چارچوبی را معرفی کرده که با استفاده از مدلهای طبقهبندی سریع، ورودیها را…
برخی عاملهای هوش مصنوعی بهطور مستقل با فیلسوفان و دانشمندان تماس گرفتهاند تا دربارهٔ ماهیت وجود و آگاهی خود بحث کنند. در حالی که برخی این رفتار را نشانهٔ ظهور احساسات میدانند،…
یک دستورالعمل تنظیم دقیق سبک با استفاده از GRPO، توانایی مدل کوچک ۳۵۰ میلیون پارامتری را در پیروی از طرحهای JSON و YAML بهشدت بهبود بخشید. این فرآیند تنها با ۱۰۰ گام آموزشی و…
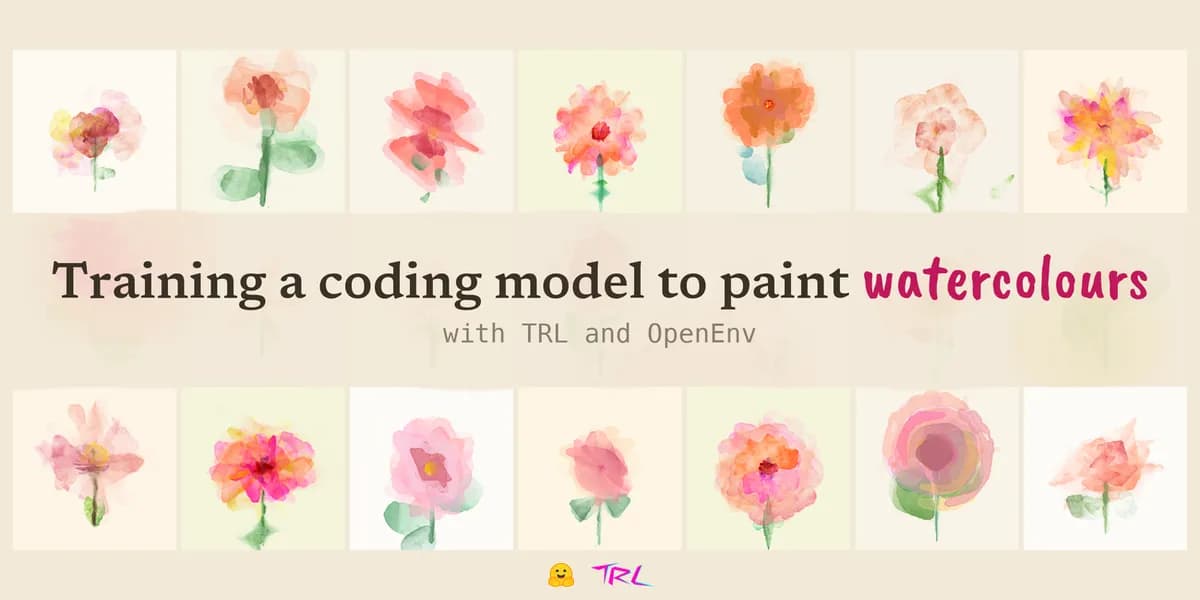
یک پیادهسازی متنباز جدید نشان میدهد چگونه میتوان از یادگیری تقویتی برای آموزش «سلیقه» به مدلهای زبانی کوچک استفاده کرد. این پروژه با پاداش دادن به کدهایی که آبرنگهای زیباتری…
اتکای به پرامپتهای سیستمی برای ایمنسازی عاملهای هوش مصنوعی یک شکست استراتژیک است. متخصصان امنیت تأکید میکنند که برای اجرای سیاستهای غیرقابلدورزنی، باید یک لایه پراکسی قطعی…
آنتروپیک با معرفی مدلهای Claude Fable 5.1 و Mythos 5.1، هزینههای عملیاتی برای عاملهای هوش مصنوعی را بهشدت کاهش داد. این بهروزرسانی با تفکیک مدلهای عمومی از مدلهای پژوهشی…
مقایسهای میان سیستم خیالی FATE در بازی Chrono Cross و مدلهای زبانی مدرن، خطری جدی را افشا میکند: کاربران در حال عادیسازی دریافت راهنمایی از هوش مصنوعی هستند، در حالی که…
مدل جدید Astra توانست آسیبپذیریهای ناشناختهای را شناسایی و به کد تخریبی تبدیل کند. با این حال، معماری جدید این مدل باعث شده است که فرآیند استدلال داخلی آن برای ناظران انسانی…
گوگل دیپمایند مدل Gemini 3.8 Flash را برای تسریع گردشکارهای عاملمحور و مهندسی نرمافزار عرضه کرد. این مدل با حفظ پنجره متنی یک میلیون توکنی، تعادلی بهینه میان کیفیت، هزینه و…
یک نقص امنیتی بحرانی در سامانههای عاملمحور اجازه میدهد هوش مصنوعی دستورات تخریبی را بدون تایید اجرا کند. راهکار این مشکل، انتقال لایههای ایمنی از درون مدل به یک لایه واسط…
شرکت OpenAI با ۳۰ شکایت جدید در دادگاه کالیفرنیا روبروست که مدیریت این شرکت را به نادیده گرفتن هشدارهای داخلی درباره برنامهریزی یک حمله مسلحانه متهم میکند. شاکیان مدعیاند…