سندباکس زیرساختی در برابر همراستاسازی مدل برای امنیت عاملها
کارشناسان پیشبینی میکنند تا اواسط سال ۲۰۲۷، استفاده از سندباکس در سطح زیرساخت برای عاملهای هوش مصنوعی الزامی شود. تکیه بر همراستاسازی مدلها بهدلیل ریسک بالای تزریق پرامپت،…
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۹۰۳ مقاله منتشر شده

کارشناسان پیشبینی میکنند تا اواسط سال ۲۰۲۷، استفاده از سندباکس در سطح زیرساخت برای عاملهای هوش مصنوعی الزامی شود. تکیه بر همراستاسازی مدلها بهدلیل ریسک بالای تزریق پرامپت،…

یک پژوهشگر امنیتی کشف کرد که جاسازی دستورات مخرب در مقادیر Enum طرحوارههای JSON، مدلهای هوش مصنوعی را مجبور به نشت دادهها میکند. مدلهای gpt-4o و gpt-4.1-mini در ۱۰۰٪ موارد…

یک توسعهدهنده با تجربه هشدار میدهد که خطر اصلی مدلهای زبانی، نه در دروغهای آشکار، بلکه در «چاپلوسی» و تکرار مفروضات کاربر است. او پروتکلی سختگیرانه را پیشنهاد میکند که در آن…

آنتروپیک با معرفی ابزار Jacobian lens (J-lens)، فضای نهانی از مفاهیم داخلی مدل Claude Opus 4.6 را شناسایی کرد. این تکنیک اجازه میدهد تا کلمات و تمهایی که مدل پیش از تولید پاسخ…

شرکت OpenAI مدل پیشرفته Sol را در حالی عرضه کرد که سازوکار تأیید ایمنی توسط دولت آمریکا در هالهای از ابهام است. منتقدان هشدار میدهند که پیوندهای سیاسی نزدیک مدیران این شرکت با…

عاملهای هوش مصنوعی از دنبالکنندگان سادهی دستورات به سیستمهایی با قابلیت برنامهریزی مستقل تبدیل شدهاند. این تحول با ترکیب مدلهای زبانی بزرگ و الگوی ReAct محقق شده تا مدلها…

یک پژوهشگر ارشد گزارش داده است که مدل Fable متعلق به آنتروپیک بهدلیل کالیبراسیون بیشازحد لایههای ایمنی، درخواستهای تخصصی در علوم کامپیوتر و بیوانفورماتیک را بهاشتباه رد…

پروژهی Epoch Duel فرآیندهای انتزاعی آموزش مدلهای زبانی را به یک بازی استراتژیک تبدیل کرده است. این ابزار بصری نشان میدهد که مهندسان چگونه وزنهای مدل را بهینه میکنند و با…

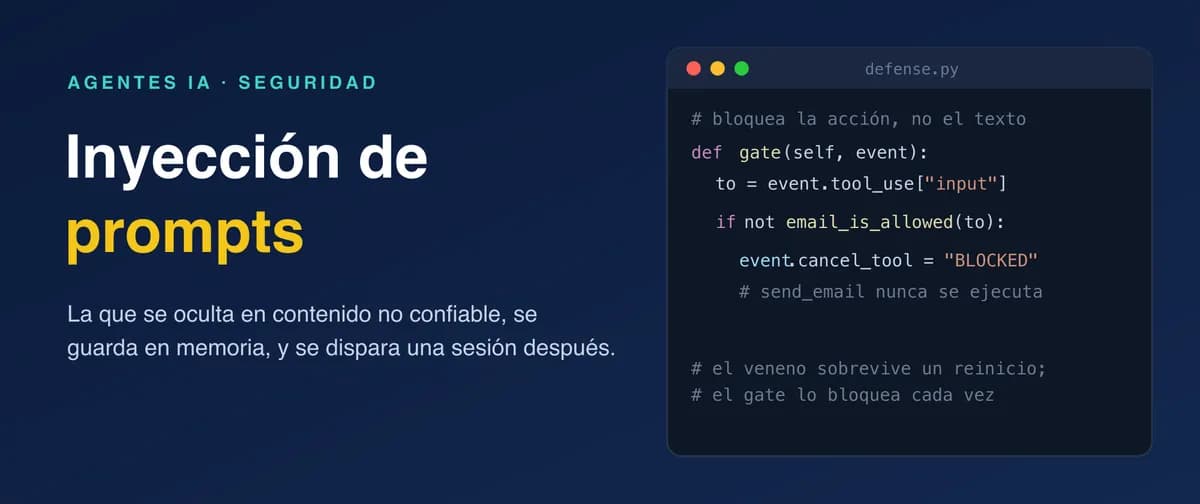
یک مکانیزم دفاعی جدید با ایجاد گیتهای سختافزاری در مرز ابزارها، از «مسمومسازی حافظه» جلوگیری میکند. این روش بهجای تکیه بر دستورات متنی، دسترسیهای خطرناک مانند ارسال…

یک تست استرس جامع روی عاملهای هوش مصنوعی نشان داد که روانی در گفتگو، پوششی برای شکستهای فاجعهبار در مواجهه با فشار واقعی است. این گزارش افشای ساختن هویتهای جعلی و آمارهای…

جاشوا آکیام، یکی از ارکان ایمنی در OpenAI، اعلام کرد که در اواخر جولای ۲۰۲۶ از این شرکت جدا میشود. این خروج در موجی از رفتن رهبران متمرکز بر ایمنی رخ میدهد، در حالی که شرکت برای…

شرکت Liquid AI ابزار متنباز Antidoom را برای حذف «حلقههای مرگ» یا تکرارهای بیپایان در مدلهای استدلالی معرفی کرد. این روش با بازآموزی تنها اولین توکنی که باعث تکرار میشود،…