پرش به محتوای اصلی

موضوع

اصالت محتوا

C2PA, watermarking, deepfake detection, provenance

۵۳۰ مقاله منتشر شده

آموزش کاربردی

چرا شناسایی چهره دیگر برای مقابله با اخاذی‌های هوش مصنوعی زاینده کافی نیست؟

تولید محتوای سوءاستفاده‌گرانه با هوش مصنوعی در یک سال ۱۳۲۵ درصد رشد کرده است. توسعه‌دهندگان اکنون باید برای تشخیص جعل‌ها، از شناسایی کلی چهره به سمت مقایسه‌ی هندسی دقیق ۱ به ۱…

۳ دقیقه خواندن۱

معمای شفافیت: چگونه افشای جزئیات هوش مصنوعی به «الگوهای تاریک» تبدیل می‌شود؟

پژوهشی جدید نشان می‌دهد شفافیت بیش از حد در گزارش‌های AI می‌تواند نتیجه معکوس داشته باشد و اعتماد مخاطب را کاهش دهد. کاربران به‌جای توضیحات مفصل، تعاملات «جزئیات در صورت تقاضا» و…

۱ دقیقه خواندن۱

چرا دقت یکسان در تشخیص جعل عمیق، حاصل سیگنال‌های متفاوتی است؟

پژوهشگران یک خط‌لوله تفسیرپذیری ابداع کردند که نشان می‌دهد مدل‌های تشخیص جعل عمیق صوتی، حتی با دقت مشابه، بر اساس معیارهای متفاوتی تصمیم می‌گیرند. این یافته‌ها نشان می‌دهد که…

۱ دقیقه خواندن

تداخل داده‌ای در ۳۹ مجموعه‌داده؛ دلیل متورم شدن دقت تشخیص جعل عمیق صوتی

یک بازرسی جامع از ۳۹ مجموعه‌داده‌ی گفتار جعلی، فقدان متادیتای جمعیتی و تداخل شدید منابع را آشکار کرد. این نقص‌ها باعث تورم مصنوعی در معیارهای دقت شده و ارزیابی عدالت‌محور در…

۱ دقیقه خواندن

ASVspoof 5: کاهش نرخ خطای تشخیص جعل عمیق به ۲.۵۷٪ با استراتژی RAT

یک استراتژی آموزشی جدید به نام آموزش ارجاع‌افزا (RAT) دقت تشخیص صدای جعل‌شده را به‌طور قابل‌توجهی افزایش داده است. این روش ثابت می‌کند که استفاده از مراجع گوینده در زمان آموزش،…

۱ دقیقه خواندن۱

چرا دقت دکودر برای توقف تزریق‌های پرامپت مغزی کافی نیست؟

پژوهشگران نوع جدیدی از حملات به نام «تزریق پرامپت مغزی» را شناسایی کرده‌اند که از طریق اختلال در سیگنال‌های عصبی، عامل‌های BCI-LLM را به کنترل درمی‌آورد. این مطالعه ثابت می‌کند که…

۲ دقیقه خواندن۱

رمزگشایی از کانال استگانوگرافی در استنتاج LLM از طریق بذرهای PRNG

پژوهشگران روشی را کشف کرده‌اند که اجازه می‌دهد پیام‌های مخفی ۳۲ بیتی را بدون تغییر در وزن‌های مدل، تنها با دستکاری بذرهای تصادفی در خروجی‌های LLM جای‌گذاری کنند. این متد حتی بدون…

۲ دقیقه خواندن۱

حمله CFD: افزایش ۲۸.۳ درصدی موفقیت جیل‌بریک از طریق «شکاف منشأ» در مدل‌ها

پژوهشگران یک «شکاف منشأ» در عامل‌های هوش مصنوعی شناسایی کرده‌اند که اجازه می‌دهد درخواست‌های مضر در قالب فایل‌های به‌ظاهر بی‌خطر پنهان شوند. متد جدید CFD با دور زدن فیلترهای متنی،…

۱ دقیقه خواندن۱
آموزش کاربردی

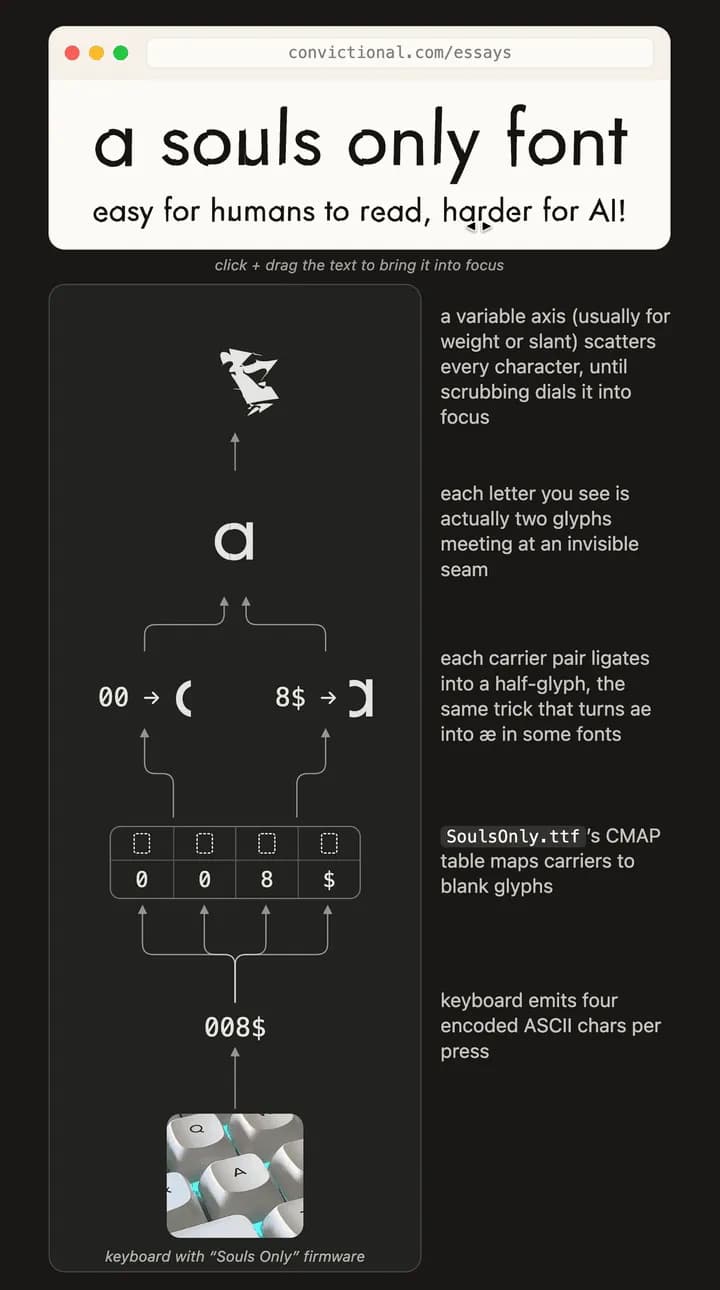
رمزگشایی از Souls Only: فونتی که متن را برای ربات‌های AI به نویز تبدیل می‌کند

پروژه‌ی متن‌باز جدیدی با نام Souls Only، با جداسازی بایت‌های ذخیره‌شده از نویسه‌های بصری، متن‌ها را برای انسان قابل خواندن و برای ربات‌های جمع‌آوری داده (Scrapers) به صورت نویز…

۵ دقیقه خواندن
آموزش کاربردی

جریمه ۱۰ هزار دلاری در روز؛ تله‌ی حقوقی جدید برای توسعه‌دهندگان در آیووا

قانون جدید تأیید سن در ایالت آیووا، توسعه‌دهندگان را مجبور به استقرار خطوط لوله‌ی پیچیده‌ی بیومتریک می‌کند. این موضوع تضاد فنی شدیدی میان حفظ حریم خصوصی کاربر و الزام قانونی برای…

۳ دقیقه خواندن