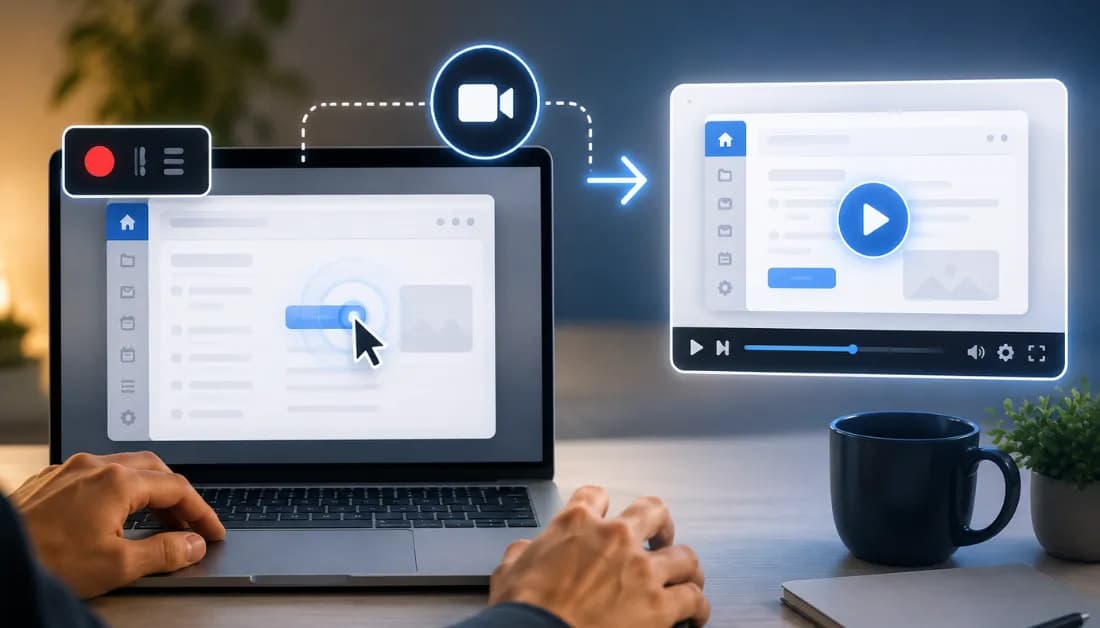
Guideless: ۲ خروجی متنی و صوتی از یک ضبط سادهٔ صفحه
پلتفرم Guideless با استفاده از یک افزونه کروم، ضبط صفحه را به راهنماهای ویدئویی روایتشده و مستندات متنی تبدیل میکند. این ابزار نیاز به سناریونویسی و ضبط صدا را حذف کرده و امکان…
۱۲ دقیقه خواندن۲
موضوع
Models that natively process text+image+audio+video
۱٬۶۶۴ مقاله منتشر شده
پلتفرم Guideless با استفاده از یک افزونه کروم، ضبط صفحه را به راهنماهای ویدئویی روایتشده و مستندات متنی تبدیل میکند. این ابزار نیاز به سناریونویسی و ضبط صدا را حذف کرده و امکان…
آیبیام دو مدل فشرده برای بازشناسی گفتار منتشر کرد که سرعت پردازش آنها ۱۲ هزار برابر بیشتر از زمان واقعی است. این مدلها با حذف کامل لایه زبانی، توان عملیاتی عظیمی را برای…
تکنولوژی بازشناسی چهره در محیطهای کنترلشده تا اوت ۲۰۲۶ به دقت ۹۵٪ رسیده است. با این حال، عملکرد این سیستمها در دنیای واقعی همچنان تحت تأثیر متغیرهایی چون نورپردازی و سوگیریهای…
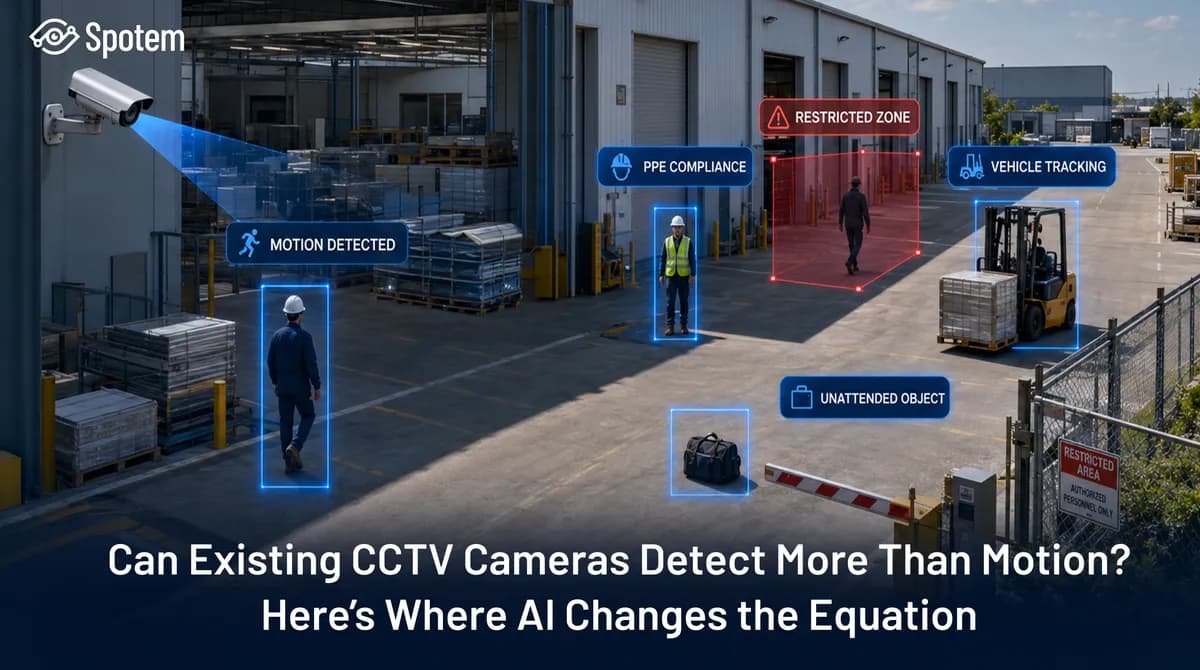
امنیت صنعتی از تشخیص سادهٔ حرکت به سمت طبقهبندی اشیا با هوش مصنوعی حرکت میکند. با افزودن یک لایه نرمافزاری به دوربینهای IP موجود، اپراتورها میتوانند بدون تعویض سختافزار،…
مدل متنباز SuperQwen3.8-27b-abliterated با قابلیت پردازش یک میلیون توکن و حذف محدودیتهای سانسور عرضه شده است. این مدل با استفاده از روش تنظیم دستهجمعی عاملها، مشکلاتی نظیر…
گرا دیو (Gradio) ابزار gr.Workflow را معرفی کرد که اجازه میدهد خط لولههای هوش مصنوعی را بهصورت گرافهای بصری بسازید. این جریانهای کاری بهطور خودکار به عنوان رابطهای تعاملی و…
مایکروسافت با ادغام Azure Content Understanding در Foundry IQ، امکان استناد دقیق عاملهای هوش مصنوعی به ثانیهها و فریمهای تصویری ویدیوها را فراهم کرد. این قابلیت با تبدیل…
پلتفرم HeyGen امکان ساخت همزاد دیجیتال فوتورئالیستیک را تنها با دو دقیقه ویدیو فراهم کرد. این ابزار تولید محتوای مقیاسپذیر به بیش از ۴۰ زبان را ممکن میکند، اما کیفیت خروجی…
یک گردشکار عاملمحور جدید با ترکیب مدلهای زبانی محلی و APIهای تخصصی تولید سهبعدی، پرامپتهای متنی را به مدلهای آماده تولید تبدیل میکند. این سیستم با تولید صفحات چندنمایی و…
یک الگوی معماری جدید برای بازارهای گیمینگ، نظارت بر محتوای چندوجهی را از طریق یک درگاه Node.js و خروجیهای JSON ساختاریافته متمرکز میکند. این روش با هدایت متن و تصویر به یک API…
یک چارچوب معماری جدید برای تولید تصویر با هوش مصنوعی، بر استفاده از آداپتورهای مستقل و پیشتنظیمهای سختگیرانه تأکید میکند تا از قفلشدگی سازنده (Vendor Lock-in) جلوگیری شود.…
مدل جدید Wan3.0 شرکت علیبابا میتواند با دریافت متن، تصویر و اسناد ساختاریافته، ویدیوهایی تا ۳۰ ثانیه تولید کند. این ابزار با هدف کاهش اعوجاجهای بصری در چهرهها و رابطهای…