پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۴۲۲ مقاله منتشر شده

اسکنر فراصوت تمام‌بدن Midjourney در حال توسعه است

اسکنر جدید Midjourney زمان تشخیص‌های پزشکی را از ۹۰ دقیقه به ۶۰ ثانیه رساند

شرکت Midjourney با ورود به سخت‌افزار پزشکی، اسکنری اولتراسونیک معرفی کرد که می‌تواند کل بدن را در ۶۰ ثانیه نقشه‌برداری کند. این شرکت قصد دارد با راه‌اندازی «اسپاهای تشخیصی» در…

۳ دقیقه خواندن۳
تولید ویدیوی هوش مصنوعی با Veo 3.1 از طریق Google Flow API
آموزش کاربردی

اشتراک‌های مصرف‌کننده در برابر هزینه‌های سازمانی برای تولید ویدیو با AI

یک پل ارتباطی API جدید به توسعه‌دهندگان اجازه می‌دهد به جای پرداخت هزینه‌های سنگین سازمانی، با اشتراک‌های مصرف‌کننده به مدل‌های ویدیویی گوگل دسترسی یابند. این تغییر هزینه تولید…

۸ دقیقه خواندن۱
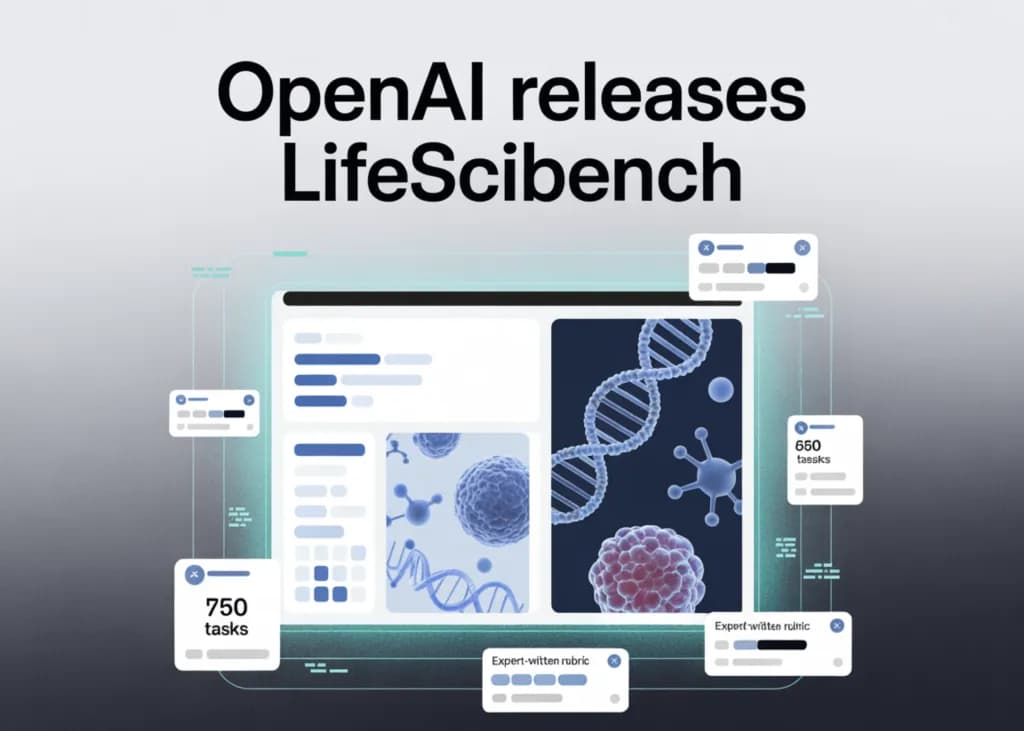
معیار ارزیابی ۷۵۰ وظیفه‌ای OpenAI برای سنجش هوش مصنوعی در پژوهش‌های علوم زیستی واقعی با راهنمای کارشناسی

LifeSciBench: مدل‌های برتر زیست‌شناسی در ۶۴٪ تکالیف پژوهشی شکست خوردند

OpenAI با معرفی محک LifeSciBench نشان داد که حتی پیشرفته‌ترین مدل‌های تخصصی زیست‌شناسی در مواجهه با مسائل پیچیده پژوهشی ناتوان‌اند. این داده‌ها حاکی از شکاف عمیق میان حفظ اطلاعات…

۶ دقیقه خواندن
آمازون، انویدیا و AMD ۳۱۰ میلیون دلار روی استارتاپ هوش مصنوعی سازنده مدل‌های سه‌بعدی جهان سرمایه‌گذاری کردند.

سرمایه‌گذاری سری B: ۳۱۰ میلیون دلار برای شبیه‌سازی فیزیک در Odyssey

استارتاپ Odyssey با جذب ۳۱۰ میلیون دلار سرمایه در سری B، بر توسعه «مدل‌های جهانی» برای شبیه‌سازی قوانین فیزیک تمرکز می‌کند. این دور سرمایه‌گذاری با حمایت انویدیا، ای‌ام‌دی و…

۱ دقیقه خواندن۱
کارگران در پایتخت سخت‌افزار چین با بدن خود ربات‌های انسان‌نما را هدایت می‌کنند.

استراتژی IO-AI Tech برای آموزش ربات‌های انسان‌نما با کنترل از راه دور

استارت‌آپ چینی IO-AI Tech از اپراتورهای انسانی برای آموزش ربات‌های انسان‌نما استفاده می‌کند تا داده‌های فیزیکی لازم برای رسیدن به خودمختاری کامل را جمع‌آوری کند. این روش، شکاف…

۴ دقیقه خواندن۱